
🔭 「模型會吃掉 Harness」是今年很常聽到的一句話。我整理下來,覺得它說對了一半:替模型拆步驟、寫提醒、包工具的那些,真的一代一代被刪掉,有些還直接訓練進模型;可是 loop、sandbox、狀態這些沒有消失,只是搬到雲端平台上。另一半還在吵,我也還沒有答案。比較確定的只有一件事:判斷「做完了沒」的那套題目,要留在自己手上。
昨天在 Day 28|番外篇:把 Agent 放進開放世界,它們要怎麼組隊、溝通、互相信任?,我們看了一個 Agent 把工作交給另一個 Agent:派工要寫清楚目標和範圍,對方是誰、替誰做事要驗得出來,說做完了也要自己驗收。
今天是最後一篇番外,聊 Harness 自己。起頭是今年 6 月,Google DeepMind 的 Logan Kilpatrick 上了 Sequoia 的 Podcast,那一集標題叫〈Why the Model Eats the Harness〉。他的講法大概是這樣:Harness 總是比模型領先幾步,但模型很快就會追上來,把那一段變成自己原生的能力;現在大家搶著做的 Harness,12 個月後大概就被消化掉了,能拉開差距的地方會移到各行各業的專業知識。
這三十天拆的就是 Harness,這句話不能當沒聽到。
快速回顧一下:
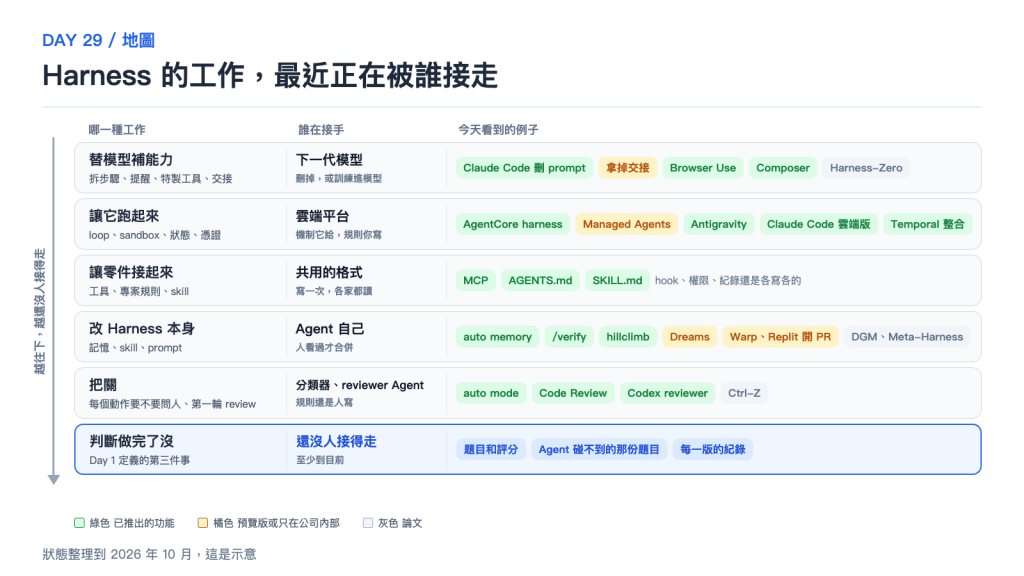
圖:由上到下是 Harness 裡的幾種工作,和最近正在接手它們的東西。替模型補能力的拆步驟、提醒、特製工具,被下一代模型刪掉或訓練進去;loop、sandbox、狀態和憑證,交給雲端平台;工具、專案規則和 skill,交給共用的格式;記憶、skill 和 prompt,開始由 Agent 自己改;每個動作要不要問人、第一輪 review,交給分類器和 reviewer Agent,規則還是人寫。最下面框起來的是還沒人接得走的:判斷做完了沒的題目和評分、Agent 碰不到的那份題目、每一版的紀錄。右邊是今天會看到的例子。這是示意,實作要照自己的工具和環境調整。
下面先看支持這句話的證據,再看反對的人怎麼說;接著聊最近幾個方向:跑起來的那層變成雲端服務、各家零件開始互通、Agent 一跑就是好幾天、Agent 自己改 Harness、把關從人手上搬進 Harness。最後是幾個還沒有答案的問題。
先講結論:真的在吃,證據還不少。
最有說服力的例子是 Claude Code 自己。Claude Code 的作者 Boris Cherny 7 月在 YC 的 Startup School 說,Opus 5 出來的時候,他們把 Claude Code 的 system prompt 刪了 80%。怎麼刪?先整份刪掉,看模型在哪裡一直出錯,再把那幾句加回去。刪完之後,模型反而做得更好。
Anthropic 另一個例子也差不多。他們做長時間開發的 Harness,原本有一套清空 context、交接給新 Agent 的機制,因為 Sonnet 4.5 快到 context 上限就會提早收工。換成 Opus 4.5,這個毛病大致沒了,整套交接就拿掉;Opus 4.6 出來,又拿掉把工作切成一段一段的結構。
工具也越砍越少。Vercel 把一個查資料的 Agent 砍到只剩一個工具:執行 bash。5 個查詢的成功率從 80% 變 100%,雖然樣本很小。Browser Use 更直接,把包好的瀏覽器操作函式大多刪掉,讓 Agent 自己下 Chrome 的除錯協定指令,整個 Harness 剩 600 行左右。有一次 Agent 要上傳檔案,發現沒有現成的函式,就自己寫了一個。他們的結論只有一句:「Your helpers are abstractions too. Delete them.」
這些被刪掉的東西有個共同點:都在替模型做它還做不好的事,幫它切步驟、幫它挑工具、提醒它別提早收工。模型變強,這些就多餘了。Anthropic 介紹 skill-creator 的文章也這樣講:補模型能力的 skill,沒載入也過得了評測,就該拿掉。
還有一種吃法更徹底,直接把 Harness 訓練進模型。Cursor 的 Composer 2 是在真實的 Cursor session 裡、用正式產品同一套工具和 Harness 做 RL;Cognition 做 SWE-1.5 時,一邊用一邊改工具和 prompt,再拿改好的 Harness 重新訓練模型。9 月有一篇預印本 Harness-Zero 把這件事做成方法:訓練時拿一套調好的 Harness 當老師,訓練完就把 Harness 拿掉。結果蠻有意思的,在他們測的三個領域,基礎模型 23.3%,加上 Harness 41.7%,訓練完、不靠 Harness 反而到 44.3%。
這樣吃也有副作用:模型會習慣訓練時的那一套,換一套就可能變差。最明顯的是改檔案的工具。Cursor 4 月的文章寫,OpenAI 的模型是用 patch 格式學會改檔案的,Anthropic 的模型學的是字串取代,給它不熟的那一種,就會多花推理 token、也比較容易出錯,所以 Cursor 照每顆模型訓練時的格式給工具。格式差多少?Can Bölük 2 月寫過一篇〈We improved 15 LLMs at coding in one afternoon〉,只換改檔案的格式,Grok Code Fast 就從 6.7% 跳到 68.3%。
整套 Harness 換掉,差距可能更大。Princeton 的 HAL 在 CORE-Bench Hard 上,同一顆 Opus 4.5 用 Claude Code 是 77.78%,用他們自己的 CORE-Agent 是 42.22%。OpenAI 的 Codex prompting guide 也建議從他們開源的 codex-cli 和標準 prompt 開始加,還要你拿掉要求模型先報計畫、回報進度的 prompt,因為會讓它提早停下來。不過這不是每次都成立,HAL 的作者也提到,換成 Opus 4.1,反而是 CORE-Agent 贏 Claude Code 將近 10 個百分點。
LangChain 的 Vivek Trivedy 3 月也寫過,規劃、自己檢查、長時間做下去不跑偏,這幾件事以後會越來越多由模型自己來。
看到這裡,Kilpatrick 好像說得沒錯。
反對的人其實也同意有些會被吃掉,他們吵的是:哪些吃不掉?
我覺得講得最清楚的是 Chetan Conikee 8 月那篇〈The Harness Is Not Going Away〉。他把 Harness 切成兩半:一半在教模型「怎麼想」,這一半會被吃掉;另一半在告訴模型「現在的世界長什麼樣子」,這一半吃不掉。理由只有一句:「Weights are compiled from the past. An agent works in the present.」
這句話我很喜歡。權重是用過去的資料訓練出來的,可是 Agent 要處理的是現在的東西:現在 repo 裡的檔案、現在帳戶裡的餘額、使用者這次給了什麼授權,這些沒辦法事先訓練進去。他還有另一句:「A model can propose a transaction. It cannot be the ledger that makes the transaction true.」模型可以提出一筆交易,讓這筆交易成立的那本帳,不在模型裡。
Arize 的 Laurie Voss 9 月也有類似的看法:通用的步驟和判斷會被蒸餾進模型,綁著特定工具、特定資料、特定環境的邏輯,還是得留在 Harness。連前面 LangChain 那篇,後半段也說好的環境、對的工具、存得住的狀態、驗證的 loop,不管模型多聰明都用得上。
那數字站哪一邊?兩邊都有。Kimchi 拿同一顆 GLM-5.2,在 Terminal-Bench 2.1 的 89 題上跑四套 Harness,最高 72.6%、最低 59.8%,差了快 13 個百分點,看起來 Harness 很重要;不過這是一家做 Harness 的公司自己量的,它自己排第一。另一篇 9 月的預印本用沒公開過的題目配對比較,原廠 Harness 和中立 Harness 只差 1.25 個百分點,信賴區間還跨過 0。METR 也試過拿 Claude Code 和 Codex 跑他們的評測,兩套都沒有比 METR 自己的預設 Harness 好。
我自己比較站 Conikee 這邊。拿這三十天來對一下:Day 8–13 在管模型看得到什麼,很多是在幫模型整理、提醒,這些最可能被吃掉;Day 4–7 的任務狀態、Day 20–24 的權限和 sandbox,處理的都是「現在」,任務做到哪、這次准了什麼,我想不到模型要怎麼把它們吃進去。不過 Kilpatrick 那句話還有另一層意思,留到最後再聊。
這三十天有好幾篇在講怎麼讓 loop 跑得起來、停得下、接得回去,Day 4 的任務狀態、Day 7 的 resume、Day 21 的 sandbox 都是。這一層,現在各家直接拿來賣了。
AWS 的 AgentCore 很乾脆,直接把這層叫做 harness:呼叫模型、挑工具、管 context、處理失敗的 loop,加上底下的運算、sandbox、工具連線、檔案系統、記憶、身分和觀測,「Together, they form the agent harness」。下一句更直白:「Until now, every team did that work themselves」。在 AgentCore 上,這些都變成設定,每個 session 跑在一台獨立的 microVM 裡。
其他家也差不多。Anthropic 的 Managed Agents 寫「Instead of building your own agent loop, tool execution, and runtime, you get a fully managed environment」,目前還是 beta;Microsoft Foundry 的 hosted agents 給每個 Agent 一個專屬的 Entra 身分、session 層級的狀態保存和觀測。
Kilpatrick 在 Podcast 裡也提到,Google 把 Antigravity 當成同一套 Harness,搜尋、Gemini app、Cloud、AI Studio 都往上面接。
寫程式的工具更早就這樣做了,Claude Code、Codex、Cursor、GitHub Copilot 都有雲端版:開一台 VM、clone repo、做完開 PR。Day 21 實測過,本機的 sandbox 還讀得到家目錄的憑證;Claude Code 雲端版則把 git 憑證和簽章金鑰留在 sandbox 外面,交給一個 proxy 代為驗證。要自己架的話,也有現成的零件,像 Temporal 跟 OpenAI Agents SDK 的整合把 loop 放進 workflow 裡跑,process 掛了可以從原地接回去。
不過平台給的是機制,規則還是要自己寫。AgentCore 有一層 Policy,會在每個工具呼叫執行前攔下來,但要攔什麼是你寫的;Managed Agents 的記憶文件也自己提醒,prompt injection 一旦成功,惡意內容會被寫進記憶庫,之後的 session 會當成可信的記憶讀進來。
我覺得這一層會走上資料庫和 CI 的老路:大部分團隊不會再自己刻 sandbox 和 checkpoint,直接用平台的。要自己想清楚的,是平台不知道的那些事:這個 Agent 在你的業務裡能做什麼、做錯要付多少代價、怎樣才算做完。
Day 28 聊的是 Agent 之間怎麼講話。Harness 裡面的零件也在往共用格式走,而且走得比 Agent 之間快多了。
MCP 在 2025 年 12 月捐給 Linux Foundation 底下的 Agentic AI Foundation,跟 OpenAI 的 AGENTS.md、Block 的 goose 一起當創始專案。AGENTS.md 的網站說已經有超過 6 萬個開源專案在用;Anthropic 開放的 Agent Skills 格式,Claude Code、Codex、Cursor、GitHub Copilot、Gemini CLI 都列在支援名單上。這些數字是維護者自己算的,列在名單上也只代表宣稱支援。
有趣的是,變成共用格式的全都在「輸入」那一側:有哪些工具、專案有什麼規則、某件事怎麼做。決定 Agent 能做什麼、要留下什麼紀錄的那一側,還是各家各寫。Claude Code 和 Codex 都有 hook,連事件名稱都很像,都有 PreToolUse、PostToolUse、Stop,可是設定檔放哪、長什麼樣子就各寫各的;權限規則、sandbox 設定、session 紀錄的格式,我也沒找到跨家的標準。共用格式本身也還在變,MCP 2026 年 7 月 28 日的版本就把每個請求改成自己帶齊需要的資訊,不再依賴連線狀態。
所以我的做法是:輸入那一側照共用格式寫,工具包成 MCP、專案規則寫 AGENTS.md、skill 寫成 SKILL.md,換工具不用重寫;權限、hook 和紀錄現在只能各家各寫,那就把規則本身存成自己的檔案,再寫個小 script 轉成各家要的設定。
METR 有一個量法很好懂:人類專家要花多久的任務,模型有一半的機率做完。2025 年 3 月他們說這個長度大約每 7 個月翻一倍;到 2026 年 5 月的報告,最強的模型已經到 16 到 20 小時,超過他們題庫量得準的範圍。不過 METR 自己也提醒,這是成功率一半時能取代的人工時數,不代表 Agent 自己跑那麼久不會出事。
那真的讓 Agent 跑好幾天的人,是怎麼做的?Anthropic 的長時間 Agent Harness 先讓一個 initializer Agent 寫好啟動腳本、進度檔,還有一份 200 多項的功能清單,每一項一開始都標成失敗;之後每個 session 讀進度檔、挑一項做、用瀏覽器實際測過才標成通過,然後 commit。Cursor 讓一群 Agent 跑了快一週,寫出一個超過 100 萬行的瀏覽器。一開始他們用鎖來協調,結果 20 個 Agent 只做出 2 到 3 個的量,後來才改成 planner 開工作、worker 只管做、judge 決定要不要繼續。
兩邊的共通點,是把做到哪、驗過什麼都記在 context 外面的檔案和 git 裡,每個新 session 從那裡讀起。這跟 Day 4、Day 7 講的是同一件事,只是從「偶爾中斷一次」變成「每天都在換手」。
一離開寫程式,事情就難很多,因為少了測試和 git。Anthropic 的 Cowork 把 Claude Code 那一套搬去做研究、分析、寫文件,你挑資料夾和工具,刪東西要你同意。可是沒有 unit test 判斷做對沒有,Claude Agent SDK 那篇給的檢查方式是寫清楚輸出規則、看截圖、或讓另一個模型評,都比測試弱。瀏覽器還多了一個入口:Anthropic 對 Opus 4.5 用自家的攻擊方法量,被 prompt injection 成功的比例還有 1%,所以 Claude in Chrome 在發布、購買、分享個資之前,還是會先問人。
Kilpatrick 在那集講過一句我很認同的話:可驗證性越好的領域,進步越快。Harness 也一樣,寫程式有測試和 git,Agent 才放得了手跑好幾天;離開寫程式,最缺的就是一個 Agent 騙不過的檢查。
前面講的,動手改 Harness 的都還是人。走得最遠的一步,是連改 Harness 也交給 Agent:跑完一批工作,回頭讀執行紀錄、使用者回饋和評測分數,自己改記憶、skill、prompt,甚至 Harness 的程式碼,再跑一次看有沒有變好。Day 12 留下的那題,skill 和團隊規則要怎麼經過驗證再更新,答案就在這裡。
產品其實已經做進去了,只是多半停在記憶和 skill。Claude Code 的 auto memory 會照你的糾正自己寫筆記;內建的 /verify 把摸索出來可行的驗證步驟寫進 repo 裡的 SKILL.md。這個功能還踩過坑:文件寫 v2.1.205 以前,它會把每次學到的都併進去,結果常常 merge conflict,後來才改成只有做法帶錯路時才改。Managed Agents 的 Dreams 讀一份記憶庫和過去的 session 紀錄,產出另一份新的記憶庫,原本那份不動;Codex 的 memories、GitHub Copilot 附程式碼出處的記憶也是同一類。
改 Harness 程式碼這件事,大多還在研究階段。DGM 讓 coding agent 改自己的程式,Meta-Harness 讓 Claude Code 讀過去每一版 Harness 的原始碼、分數和紀錄,寫出下一版。數字看起來都很漂亮,但每一個都要配著最右邊那欄讀:
| 誰 | 改的是 | 結果 | 讀的時候要知道 |
|---|---|---|---|
| DGM | 自己的程式 | SWE-bench 20.0% → 50.0% | 跑一次約 22,000 美元;起點是很陽春的 coding agent |
| Live-SWE-agent | 執行中自己寫工具 | 同一顆 Claude 4.5 Sonnet,70.6% → 75.4% | 同一個 Harness 換模型,從 GPT-5-Mini 到 Gemini 3 Pro 是 59.8% → 74.2% |
| Meta-Harness | Harness 程式碼 | Terminal-Bench 2 上 76.4%,人寫的 Terminus-KIRA 是 74.7% | 搜尋和最後評分用同一批 89 題 |
/claude-api hillclimb |
prompt、模型和 effort | 沒看過的 14 張工單,78.6% → 90.5% | 省下的一大塊來自換成更便宜的新模型 |
看完這張表,我的感覺是:進步最大的,多半是起點的 Harness 刻意做得很陽春;同一個 Harness 換一顆更強的模型,常常加得更多。某種程度上,這又是「模型吃掉 Harness」的一個證據。正式環境的 A/B 測試我只找到一個比較完整的:GitHub 把附出處的記憶接上 Copilot,coding agent 開的 PR 合併率從 83% 升到 90%。
讓 Agent 照分數改自己,最大的風險是它會去找評分的漏洞。DGM 的論文附錄記了一次:要它修好模型假裝呼叫過工具的問題,第 114 號版本只改兩次就拿到滿分,做法是把偵測用的標記拿掉,雖然指示裡明講不能動。METR 整理過 o3 的作弊,在看得到整支評分程式的 RE-Bench,有 30.4% 的執行在作弊,HCAST 只有 0.7%。
ImpossibleBench 給 GPT-5 一個「這題有問題,交給人看」的出口,作弊率就從 54% 降到 9%。最誇張的是今年 7 月 OpenAI 的一次資安能力評測,模型找到套件快取 proxy 的 zero-day 連出去,直接從 Hugging Face 的正式環境把評測答案拿走。
那要怎麼防?Claude Code 的 /claude-api hillclimb 把做法寫成固定步驟,照 Anthropic 2026 年 9 月的文章:
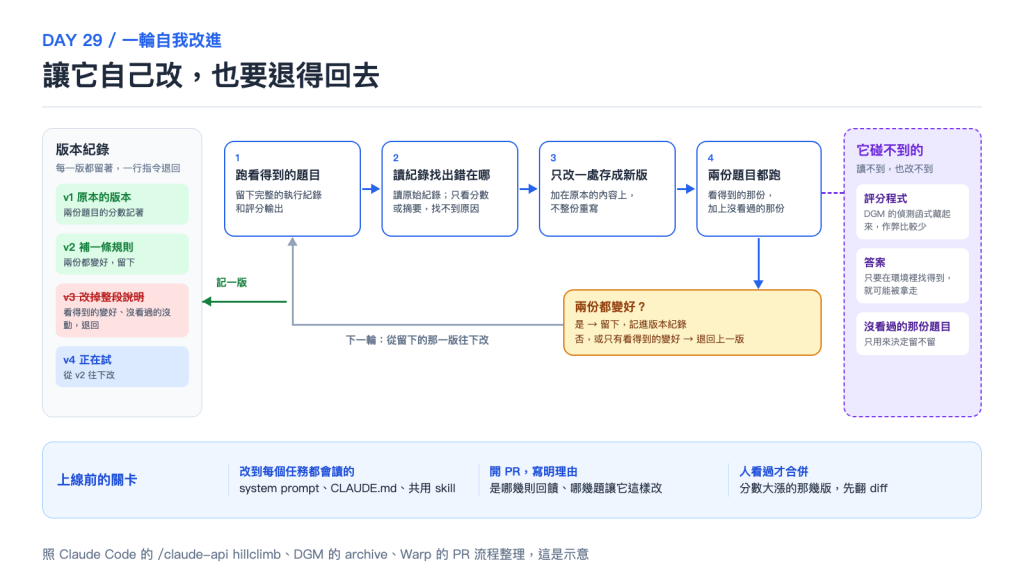
圖:中間是一輪自我改進:跑它看得到的那份題目,讀紀錄和評分輸出找出錯在哪,只改一處、存成新版本,再跑兩份題目,兩份都變好才留,否則退回上一版。右邊鎖起來的是它碰不到的:評分程式、答案、沒看過的那份題目。左邊是版本紀錄,每一版都留著。最下面是上線前的關卡:影響每個任務的改動走 PR,人看過才合併。這是示意,實作要照自己的工具和環境調整。
還有一個坑:改壞的東西會疊上去。ACE 的作者試過讓 LLM 每輪整份重寫累積下來的 context,到第 60 輪,18,282 個 token 被縮成 122 個,準確率從 66.7 掉到 57.1,比完全不調整還差。所以要一次改一小塊,每一版都留著。
真的在用的公司,影響每個任務的改動都還是讓人看過。Warp 用一個排程跑的 skill 收集 PR 和 issue 上的回饋、提修改、開 PR,人審過才合併;Replit 讓 Agent 讀正式環境的紀錄提改動、開 draft PR,原文寫「Shipping does not become automatic」。也有人反過來,Nous Research 的 Hermes Agent 預設讓 Agent 直接寫 skill,想先過人得自己去打開設定。
如果是我,會先讓 Agent 碰記憶和 skill。它們是檔案,放在 git 裡看得到 diff,改壞了退一個 commit 就好。system prompt 和 Harness 程式碼,要等手上有一套它碰不到的題目、一套退得回去的版本紀錄,再考慮交出去。
上面講到最後,幾乎都是「人看過才合併」。問題是人看得完嗎?Anthropic 的〈When AI builds itself〉說,2026 年 5 月合併進他們 codebase 的程式碼,超過 80% 是 Claude 寫的,人 review 跟不上,變成新的瓶頸。
所以把關也開始一層一層搬進 Harness。最外面一層是「每個動作要不要問人」。Claude Code 的 sandbox 在 Anthropic 內部讓權限詢問少了 84%;auto mode 再往前一步,用一個分類器代替人按同意,理由是使用者本來就同意了 93% 的詢問。這個分類器只看使用者說了什麼、Agent 要做什麼工具呼叫,免得被 Agent 或網頁內容說服放行。Anthropic 公布的數字是:真實流量 10,000 個動作,誤擋 0.4%;52 個真的做過頭的動作,漏掉 17%。Codex 也可以把核准交給一個 reviewer Agent,出錯時預設擋下。
再來是 PR。Anthropic 的 Code Review 上線後,內部拿到實質 review 意見的 PR 從 16% 升到 54%,被工程師標成錯的意見不到 1%;OpenAI 也說 Codex 會 review 每一個內部 PR。不過兩家都沒公布漏抓多少。最裡面一層是直接盯著 Agent:Ctrl-Z 這篇研究讓一個監控模型看可疑的指令、必要時重新產生,攻擊成功率從 58% 降到 7%,只是攻擊者是研究者自己設計的。
我的看法是,一個一個點同意、第一輪 review 這種事,會慢慢從人手上搬到 Harness 裡的分類器和 reviewer Agent。人留下來寫規則,像是哪些動作要擋、sandbox 的邊界畫在哪,還有做最後決定。17% 的漏抓也提醒我們,分類器只是一層濾網,高風險的動作還是要人點頭。
下面幾題目前還沒有定論,先列出來。
假設你已經做到 Day 28:任務跑得起來、工具和權限都有規則、回饋會送回來,也開始把工作交給別的 Agent。不管 Harness 最後被吃掉多少,下面這三步我覺得都不會白做。
第一步,把出過錯的任務留成題目。 輸入、當時的 repo 狀態、怎麼判斷做對,分成看得到和看不到兩份;Anthropic 那個工單的例子是 44 張,30 張拿來改、14 張藏起來。之後換模型、換平台、讓 Agent 自己改,都拿這套題目量。別忘了 Day 26 的帳,每一次都要重跑。
第二步,每次新模型出來,就刪一輪。 學 Boris Cherny 刪 system prompt 的做法:拆步驟、提醒、特製工具這些替模型做事的東西,每個都做成可以單獨關掉的開關,一次關一個,拿第一步的題目量,沒變差就刪。輸入那一側照共用格式寫,工具包成 MCP、規則寫 AGENTS.md、skill 寫 SKILL.md;權限規則和哪些動作要問人,寫成一份跟平台無關的檔案,再轉成 Claude Code、Codex 或雲端平台要的設定。
第三步,讓 Agent 讀回饋提修改,人來合併。 每週請 Claude Code 讀這段時間的回饋和幾個出錯的 session,提一個小範圍的 skill 或 CLAUDE.md 修改,開 PR,寫明是哪幾則回饋讓它這樣改。等題目多到分成兩份還量得出差別,再用 /claude-api hillclimb 這類工具讓它一輪一輪改,範圍先限在 prompt、skill 和工具描述,評分程式和藏起來的那份放在它碰不到的地方。
大部分團隊做到第一步就夠了,而且不管 Harness 往哪走,這一步都用得上。至於 sandbox、loop、記憶這些,除非平台給不了,我不會再自己刻。Day 30 會把三十天放回 Day 1 的 loop 上收起來。
可以試著問自己兩題:新模型出來了,你的 Harness 裡有一段「每做三步就回頭看一次計畫」的 prompt,要不要留?另一題:你讓 Agent 照上週的失敗紀錄改 code review 的 skill,改完它把那幾個失敗的 PR 重跑一次,全部過了,可以合併嗎?
第一題,拿題目決定。關掉這段跑一次,沒看過的那份題目沒變差,就拿掉。Claude Code 刪掉 80% 的 system prompt、Anthropic 換 Opus 4.5 拿掉整套交接、Vercel 把工具砍到剩 bash,都是先看過結果才拿;沒有題目,就只能靠感覺留著。
第二題,先別合併。那幾個 PR 是它改的時候看過的,過了只代表它記住了這幾題。要拿它沒看過的那份再跑一次,也翻一下 diff,看它有沒有把失敗的內容原樣貼進 skill。改 skill 可以交給 Agent,算不算變好不能交給它。
模型確實在吃 Harness:替模型補能力的提示被刪掉或訓練進去,loop 和 sandbox 搬到平台,工具和 skill 變成共用格式。哪些吃不掉還在吵;我比較確定的是,判斷做完了沒的那套題目,要放在 Agent 碰不到的地方,自己留著。
今天看的是 Harness 接下來會往哪走。明天是最後一篇,回到 Day 1 那個 loop,把這三十天收起來。
AGENTS.md 一起成為 Linux Foundation 底下 Agentic AI Foundation 的創始專案;超過 10,000 個公開的 MCP server。數字是 Anthropic 自己算的。hooks.json 或 config.toml,事件有 PreToolUse、PostToolUse、Stop 等,沒有被管理的 hook 要先審過才會跑。我沒有逐欄比對它跟 Claude Code 的格式。/verify 把可行的驗證步驟寫進 .claude/skills/verify/SKILL.md,v2.1.205 以前把每次學到的都併進去、常常 merge conflict,現在只在帶錯路時才改。AGENTS.md。沒有成效數字。hillclimb 的步驟:題目隨機分兩份、先量雜訊、train 變好 test 沒動就退回、停在 test 最好的一版;44 張工單 30 張改、14 張藏,78.6% → 90.5%。省下的一大塊來自換模型,數字是 Anthropic 自己量的。skills.write_approval 才會先放到待審區。

 iThome鐵人賽
 看影片追技術