
🏢 全公司導入 Agent,開發和測試要分開推。開發先發 skill 和設定,讓每次使用都把回饋送回來,照回饋改 skill,再一段一段把流程交給 Agent;測試先讓 unit test 跟著開發跑,再把驗證寫成 QA 拿得走的 script 或步驟。AI review 要擋合併,得先有一套知道答案的題目,所以放最後;PR 多到看不完時,人只細看回不去的改動。
昨天在 Day 26|Agent 的錢花在哪,該盯哪個數字?,我們拿一套 Harness 三週的帳,看錢花在哪,也看了為什麼每一版 Eval 都要先看 Prompt Cache 命中率。
今天是番外篇。前面 26 篇講的都是一個 Harness 怎麼設計,今天換一個最貼近工程師的題目:在公司裡推廣、部署開發用的 Harness,幾千個人一起用 Agent 寫程式,要先準備什麼。站的位置也跟前面不太一樣,今天的讀者是替公司把這件事架起來的人。員工用的 Agent 多半是現成的工具,要蓋的是工具外面那幾層。
快速回顧一下:
AGENTS.md 寫成一份目錄,告訴 Agent 這個 repo 怎麼做事。今天會看到有公司替幾千個 repo 各生一份。CLAUDE.md 跟著 repo 走,再用 CI 擋。今天看規則多到要發給整間公司的時候怎麼辦。今天的材料是兩家公司今年自己寫的工程文章。Cloudflare 花了 11 個月,讓研發部門 93% 的人在最近 30 天裡用過 AI coding 工具,全公司約 6,100 人裡有 3,683 人在用;merge request(GitLab 上的 PR)的四週平均,從每週約 5,600 件漲到 8,700 件以上。Uber 從 2026 年 2 月到 8 月,全公司(含非工程師)每週使用 Agent 的人數成長 7 倍、請求數成長 9.4 倍,七成以上的 PR 歸在本機或雲端的 Agent 名下。
兩家做的事,我把它排成三步:
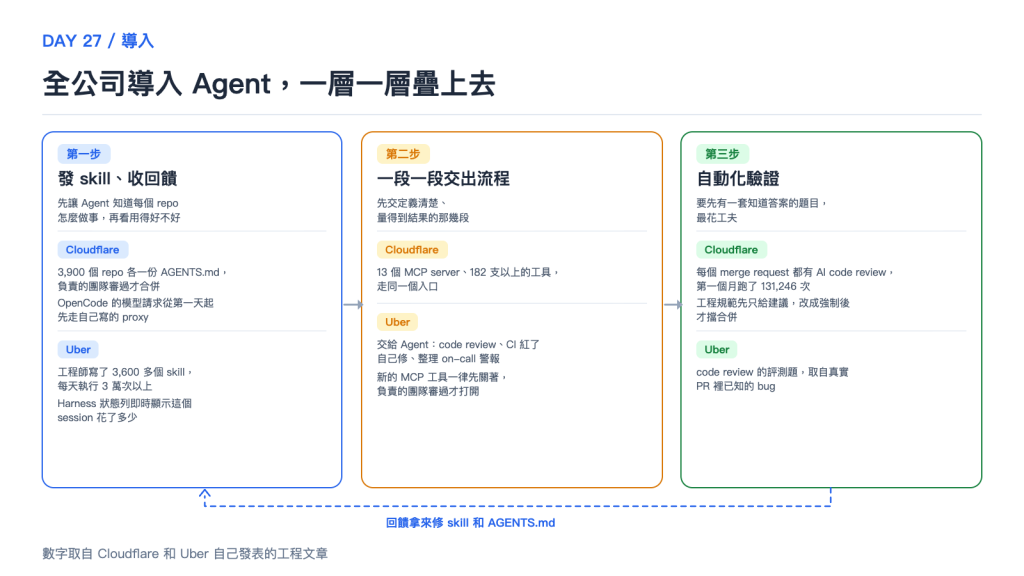
圖:由左到右是三步。第一步發 skill、收回饋:每個 repo 一份 AGENTS.md、OpenCode 的請求從第一天起先走自己寫的 proxy、3,600 多個 skill、狀態列顯示花費。第二步一段一段交出流程:MCP server 走同一個入口,code review、修 CI、整理警報交給 Agent。第三步自動化驗證:每個 merge request 都有 AI code review,規範先建議後強制,評測題取自真實 PR 裡的 bug。底下的箭頭是回饋。三步是我照兩家的做法排的,兩家實際上線的先後不完全是這樣。
下面照這三步走:先看一開始該發什麼、回饋怎麼收,再看流程先交出哪一段,接著是驗證為什麼放最後、PR 多到看不完時人要看哪裡。前兩步加上回饋,講的是怎麼讓 Agent 把程式寫對;驗證和 PR 那兩節,講的是寫出來之後怎麼確認沒問題。最後一節是我自己的做法,也是照這兩邊分開推:開發一條,測試一條。
Cloudflare 那篇寫,導入初期一直看到同一種失敗:coding agent 改出來的東西「looked plausible and were still wrong for the repo」,看起來合理,放進那個 repo 卻是錯的。他們說原因多半是缺這個 repo 自己的背景:模型不知道測試要跑哪個指令、團隊現在的慣例是什麼、哪些地方不能碰。
他們的解法是替每個 repo 寫一份 AGENTS.md。幾千個 repo 不可能請每個團隊從頭寫,所以做了一條產生的流程:先從服務目錄(他們用 Spotify 開源的 Backstage)抓出這個服務歸誰、依賴誰,再分析 repo 用什麼語言、怎麼 build、怎麼測,對上適用的工程規範,交給模型寫成文件,最後開一個 merge request,讓負責的團隊審、再自己修。
這樣處理了大約 3,900 個 repo。他們也承認第一版不一定好,混很多語言或建置方式特別的 repo 尤其容易寫錯,但比讓 Agent 每次自己從頭猜好很多。
缺了背景差多少,Uber 那篇有個查資料的例子。Uber 把 30 多個內部系統的資料整理成一張關聯圖(他們叫 Context Graph):服務、團隊、事故紀錄、PR、設計文件、資料表都在上面,連「誰平常查哪張表」的紀錄也有,Agent 可以直接用自然語言問它。
文章拿同一個問題、同一個模型比了一次。問題是「Forge 裡的 Vehicle Lists,有辦法用 Hive 查嗎?」(Forge 是 Uber 內部的系統)。接了這張圖的 Agent 呼叫 4 次工具、38 秒就答完:它從查詢紀錄找到一張 53 位分析師跑過 512 次的表,另外排了三個替代方案、寫好四種 SQL。沒接的那個只能去翻服務的程式碼,派了 2 個 subagent、撞了 3 次錯,花了 20 分鐘,最後回答「Vehicle Lists 沒辦法用 QueryBuilder 查」。可是那張表明明就在,已經有 53 位分析師在用。Uber 照正確、完整、具體、能不能照著做四項打分,前者拿滿 30 分,後者 19 分。
規則也要發。Cloudflare 把工程規範整理成 Engineering Codex:每條規範拆成「需要 X 就用 Y」「做 Y 的時候一定要 X」這種規則,再做成一個 skill。skill 的內容分層放,用到哪一段才讀哪一段,就是 Day 26 講的 progressive disclosure。工程師在本機可以直接問它「Rust 服務的錯誤要怎麼處理」。
Uber 那邊,工程師自己寫了 3,600 多個 skill,每天執行 3 萬次以上。公司也替最常用的幾個 MCP server 先寫好 25 個以上的 code-mode skill:模型把工具當成 shell 指令,寫一支腳本,把原本要來回好幾輪的查詢一次跑完,中間結果不用進 Context。這樣常見的流程,預設就走最省的那條路。
再來是怎麼發到每個人手上。Cloudflare 的員工用 OpenCode、Windsurf 等好幾種 coding agent,其中開源的 OpenCode 有一套替它做好的設定,只要跑一行指令登入:
opencode auth login https://opencode.internal.domain
OpenCode 會到這個網址底下固定的路徑拿公司的設定:模型供應商、MCP server、公司寫好的 Agent 和指令、預設權限。這些 Agent 和指令都是 markdown 檔,改完之後,每個新開的 session 自動拿到最新版。原文也寫明「local configs always take priority」,員工可以自己換預設模型、加自己的 Agent,不影響別人,所以這是一份預設值,公司沒有鎖死。
Uber 的做法類似:所有互動式的 Harness 都包在同一層 wrapper 裡,安裝、設定、登入、看花費都走它。預設值也是公司定的:compaction 在 40 萬 token 就觸發,模型撐得到 100 萬也一樣;reasoning effort 預設 medium。還有一個設定,跟 Day 26 那份帳算出來的結論一樣:工程師常常把互動 session 放著超過 5 分鐘,cache 一過期就要整段重寫,所以他們把互動 session 的 cache 從保留 5 分鐘改成 1 小時,只跑一件短工作的 subagent 維持 5 分鐘。
從第一天。Cloudflare 說他們早期做對的一件事,是從第一天起就讓 OpenCode 的模型請求先經過他們自己寫的一個 proxy,不讓員工的工具直接連到 AI Gateway(Cloudflare 自家的產品,公司裡每一筆模型請求都會經過它)。直接連一開始比較好架;可是多了這一層,後來要記「這筆算誰的」、管哪些模型能用、管權限,都只要改 proxy,不用去改每個人電腦上的設定。為了隱私,proxy 會把員工的 email 換成一組匿名編號,AI Gateway 和模型供應商都只看得到編號。
有了這一層,才看得到誰在用、用了多少。Uber 把花費直接放在工程師眼前:Harness 的狀態列即時顯示這個 session 花了多少、這個人在所有 Harness 上加起來花了多少,花到預期的 50%、80%、100% 時發 Slack 提醒。
光看總數不知道錢浪費在哪,所以 Uber 另外做了一個分析 session 紀錄的儀表板,不用另外設定,會列出 16 種浪費的用法,每種附上浪費多少錢、怎麼改。文章舉了幾種:
回饋最後要回到 skill 和 AGENTS.md 本身。Cloudflare 說第一份 AGENTS.md 只解決了從零開始的問題,之後還要一直跟著 repo 更新:「A stale AGENTS.md can be worse than no file at all」,過時的說明比沒有還糟。
他們讓 code review 那層幫忙盯。merge request 換了套件管理工具、測試框架、建置工具,搬了大批目錄、加了必要的環境變數或改了 CI,就提醒該更新 AGENTS.md。AGENTS.md 本身寫了「write clean code」這種空話、超過 200 行,或只寫工具名稱沒附可以直接跑的指令,也會被扣分。
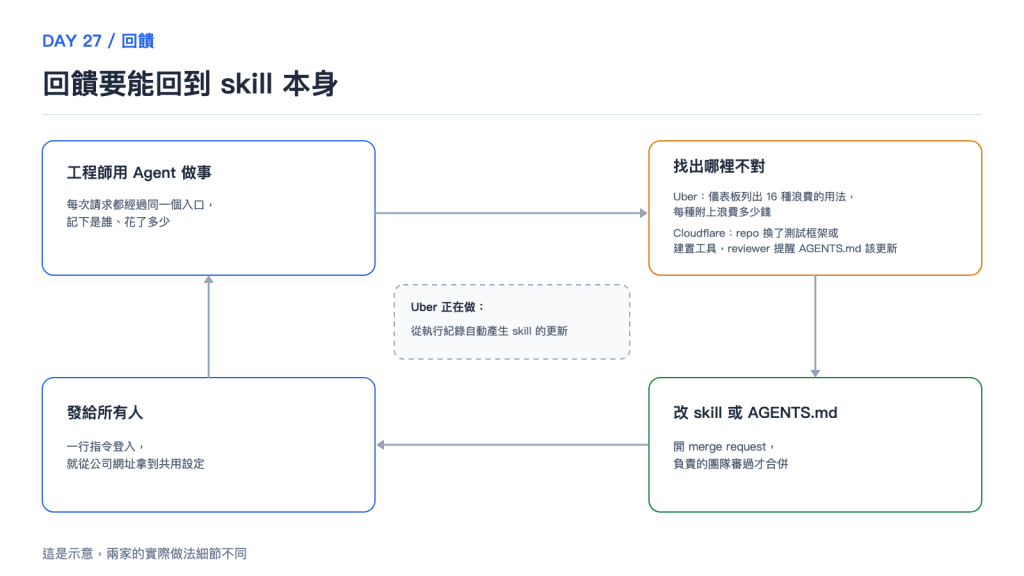
圖:四個節點繞一圈。工程師用 Agent 做事,每次請求都經過同一個入口,記下是誰、花了多少;接著找出哪裡不對,Uber 的儀表板列出 16 種浪費的用法,Cloudflare 的 reviewer 在 repo 換了測試框架或建置工具時提醒 AGENTS.md 該更新;然後改 skill 或 AGENTS.md,開 merge request 給負責的團隊審;最後發給所有人,一行指令登入就拿到共用設定。中間是 Uber 正在做的:從執行紀錄自動產生 skill 的更新。這是示意,兩家的做法細節不同。
Uber 下一步想把這一圈自動化:從 skill 執行的紀錄裡自動記下哪裡卡住,再自動產生 skill 的更新。讓 Agent 自己改 skill,是 Day 29 要講的事。
skill 發出去、回饋收得到之後,才開始把流程一段一段交給 Agent。
Uber 文章裡有一張圖,把 Agent 的用法分成四層。由下往上:
越往上,花多少錢、品質好不好、用哪個模型,越能由公司控制。文章說,越來越多 session 不是人開的,是最上面那層 Agent 自己開的。
最上面那層的每個 Agent,Uber 都看三類數字:一件工作花多少(每個合併的 PR、每次 review、每則警報各花多少錢)、品質(被 revert 的比例、review 抓 bug 準不準、從出事到修好要多久),還有做了多少(合進去幾個改動、發了幾次 review、處理了幾則警報)。他們的方向是把更多工作從工程師手上的互動 session 搬到這些專門的 Agent 上,因為模型、Harness 和花費都在公司手裡,比在幾千個工程師各自的 terminal 上一個一個省,更省錢,也更容易放大。
我覺得交出流程可以照這個順序:先交範圍清楚、結果量得到的那幾段。每交一段,都要講得出「做完了沒」和「做得好不好」怎麼算。
Agent 要做事,就要接得到公司內部的系統。Cloudflare 的入口集中了 13 個 MCP server、182 支以上的工具,接 Backstage、GitLab、Jira、Sentry、Elasticsearch、Prometheus、Google Workspace、內部的發版系統等等,全部走同一個網址、同一套登入。這些 server 都放在同一個 monorepo,共用一套 CI;Cloudflare 另一篇講 MCP 管理的文章也寫,員工想把內部資源做成 MCP server,要先經過 AI 治理團隊核准。
Uber 的 MCP 全部經過一個 gateway,內部的和外部 SaaS 的加起來超過 1,000 個 MCP server。他們介紹這個 gateway 的文章裡有一句我覺得可以直接抄:「discovery doesn't imply exposure」,掃得到,不代表就開放給 Agent 用。Uber 有幾千個內部服務,gateway 會自動掃服務的介面定義(Protobuf、Thrift 這類),產生對應的 MCP 工具,工具描述交給 LLM 寫,但每個 server、每支工具一開始都是關著的,要負責的團隊審過才打開。
工具描述每改一次,也要負責的團隊重新核准,必要時可以退回上一版。呼叫工具的權限、限流、把回應裡的個資遮掉,也都在 gateway 做。
工具一多,Context 的問題就來了。Uber 說裝了 100 多支工具時,光是一開始把工具定義全部送進去,就多了 5 到 7 萬 token;一個辦公套件的 MCP server 就有 49 支工具、約 2.2 萬 token。他們用了兩招:一是 tool search,要用的工具才載入;二是把 MCP 工具都變成 shell 指令,模型直接下指令,工具定義完全不進 Context。外部 SaaS 的常用流程,再另外包成 skill。這跟 Day 15 講的是同一件事,只是放大到整間公司。
因為要先知道什麼叫對。Agent 審 Agent 改的程式,說「沒問題」或「這裡有 bug」,都要有一套答案拿來比,才講得出它審得準不準。這套答案最難湊。
Uber 的 code review Agent 叫 uReview,負責所有 PR 的 AI review。它的評測題是從真實的 PR 裡挑出已經知道有 bug 的,再分成易、中、難三級,拿來算 precision、recall 和 F1:它指出的問題有幾成是真的、真的 bug 它抓到幾成,還有兩個合起來的分數。另外也看每次 review 花多少、多久、timeout 幾次、雜訊多不多。Uber 說之後每做一個新的 Agent 都照同一個順序:先定好要看的結果,再湊評測題,最後才挑模型。
Cloudflare 的 AI code review 接在 CI 裡,每個 merge request 都跑,但不是每次都派滿 reviewer。先看改動大小:20 個檔案以內的,10 行以內算 trivial、100 行以內算 lite;其餘都算 full,超過 50 個檔案或碰到 auth、crypto 這類安全相關路徑的,不管改多少行都是 full。trivial 平均一次 0.20 美元;full 最多派七個 reviewer,平均 1.68 美元。
reviewer 各管一塊:code quality、security、合不合工程規範、文件、效能、發版影響。第一個月跑了 131,246 次,涵蓋 5,169 個 repo、48,095 個 merge request,中位數 3 分 39 秒,平均每次 1.19 美元。
他們也清楚這擋不了全部。原文有一節專門講限制,第一句是「This isn't a replacement for human code review, at least not yet with today's models」:看不出整體架構為什麼這樣設計,改了 API 也確認不了下游用的人都跟著改了。每次審完平均只給 1.2 個意見,他們說這是故意壓低的,寧可少報,也不要一堆不準的意見。
另外,這套 review 擋在大家出貨的路上,所以他們留了一個緊急出口:人類 reviewer 在 merge request 留言 break glass,就強制放行,急著上 hotfix 的時候用得到。第一個月用了 288 次,占 merge request 的 0.6%。
規範也是慢慢收緊的。Cloudflare 另一篇講 Engineering Codex 怎麼擋:每條規範是一份 RFC,裡面的要求分 SHOULD 和 MUST。RFC 剛核准(approved)的時候,reviewer 看到違反只給建議、不擋合併;之後要再明確升級成 enforced,MUST 沒做到才會擋下來、不給合併。這就是 Day 12 說的「規則寫進檔案,再用 CI 擋」,只是擋的那一關換成 AI review。
從今年稍早這套規範上線,到這篇文章發表的 8 月初,大約四個月裡,reviewer 標出近 23 萬筆違規,其中約 1.6 萬筆是 enforced 規範裡的 MUST,讓它不給通過。工程師嫌 AI review 要等幾分鐘、改完又要再跑一輪,所以能用程式檢查的規範,他們另外做成 linter 設定,幾毫秒就有結果,目前先做了 TypeScript。
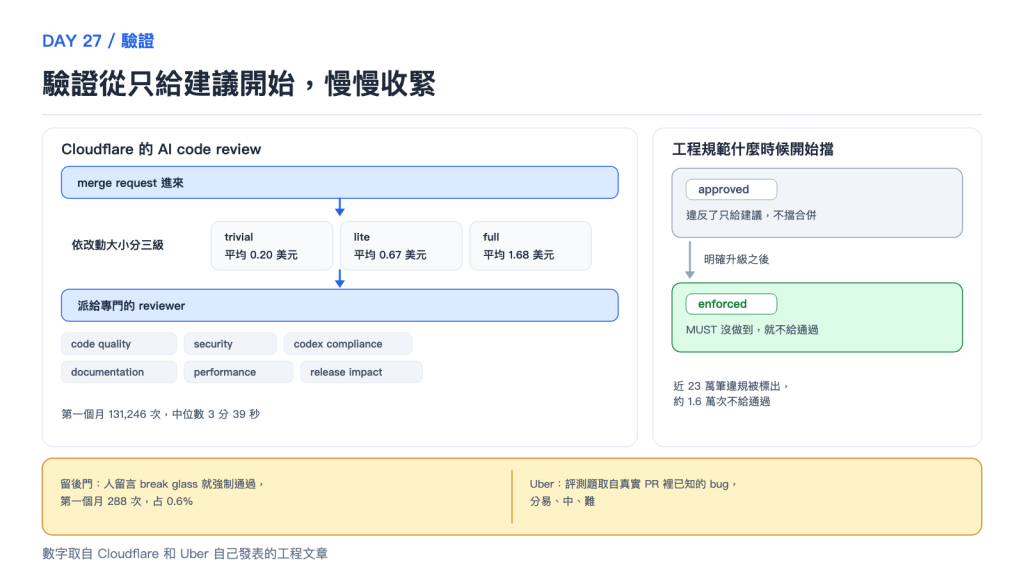
圖:左邊是 Cloudflare 的 AI code review:merge request 進來,依改動大小分成 trivial、lite、full 三級,平均一次 0.20、0.67、1.68 美元,再派給各管一塊的 reviewer;第一個月 131,246 次,中位數 3 分 39 秒。右邊是工程規範什麼時候開始擋:approved 時違反只給建議,明確升級成 enforced 之後,MUST 沒做到就不給通過;近 23 萬筆違規被標出,約 1.6 萬次不給通過。下方是兩個補充:留言 break glass 可以直接放行,第一個月 288 次;Uber 的評測題取自真實 PR 裡已知的 bug。這是示意,數字取自兩家公司的文章。
我覺得兩家的做法都在說同一件事:驗證要等前面兩步跑一陣子,才做得好。題目要從真的 PR 和真的 bug 來;規範要先有人寫、先試著只給建議,看誤報多不多,再決定要不要擋。
Cloudflare 的 merge request 一週從 5,600 件漲到 8,700 件以上,Uber 七成以上的 PR 歸在 Agent 名下。AI review 擋掉再多,最後還是有人要看。Matt Pocock(Total TypeScript、AI Hero 的作者,公開的 agent skills 很多人在用)在 AI Engineer Paris 2026 講了一場〈Fixing the PR Bottleneck〉,談的就是 PR 暴增之後,人要擺在哪裡。AI 懶人報有一集中文整理,附了原片的片段,整理成五點。
要變快,先裝煞車。他把 PR 合併前的檢查疊成三層:最下面是 lint、型別、測試這些自動檢查,只花機器的時間;中間是 AI review,花 token;最上面才是人的 review,花人的時間。要讓人那一層跟得上,靠的是把下面兩層做厚。他也提醒,code 就是 Agent 工作的環境,codebase 裡有爛 code,就會生出更多爛 code。Cloudflare 那套分級的 AI review,就是中間那一層。
測試也會說謊。他舉了一個自己抓到的例子:程式裡寫 X 貼文的字數上限是 280,Agent 寫的測試就是「預期上限是 280」,等於把實作再寫一次。這種測試檢查不到功能對不對,那個常數改個名字,測試卻會壞。他的解法從程式的設計下手:把複雜的行為藏在簡單的介面後面(他叫 deep module),逼 Agent 的測試只打在介面上,不去碰實作的細節。AI 懶人報那集再補了一句:看到把實作再寫一次的測試,直接刪掉。
寫程式和守規範,要交給兩個 Agent。寫程式的那個要找檔案、改 code、跑測試、除錯,Context 已經很滿,再塞一整份寫法規範,每件事都做得比較差;負責 review 的那個拿到的是改動,頂多再看一點周邊的程式,不用改 code 也不用除錯,空間還很多。所以他不把寫法規範放進 AGENTS.md 或 CLAUDE.md,另外寫一份 CODING_STANDARDS.md,只給 review 的 Agent 讀。
他還主張 review 的 Agent 找到問題,預設直接改、直接 commit,只有自己也拿不準的才留言,人打開 PR 時看到的是整理過的版本。這跟 Day 12 的做法不太一樣:Day 12 把一定要照做的規則寫進 CLAUDE.md,再用 CI 擋;兩邊都同意,最後要靠檢查擋。
人的時間,只留給回不去的改動。他借 AWS 的說法分單向門和雙向門:大部分 PR 合併之後出錯了,revert 就好,是雙向門;寄出去的信、刪掉的資料、昂貴的資料遷移收不回來,是單向門,要看得很細。單向門不一定長得大,一個很簡單的改動,也可能不小心寄信給六萬個人。他的 pr skill 會在 PR 描述裡寫上這是哪一種門,還有出錯會影響多大的範圍。
最後一點:人在 review 的,其實是產生 code 的那套系統。同一種錯在兩個 PR 裡都出現,問題就不在這兩個 PR,在產生它們的環境。他的 retro skill 會讀一次 coding session 的紀錄,建議該加哪個自動檢查、給 review Agent 的規範怎麼改、哪些全域說明該搬走;固定寫法、禁用的 API 這種機械性的錯,一律做成自動檢查,不再多寫一條規則。我的理解是,規則 Agent 不一定會讀,檢查每次都會跑。
我覺得這場跟兩家公司的做法接得起來。Cloudflare 和 Uber 把下面兩層做厚、做到整間公司都能用,像 Cloudflare 讓 reviewer 提醒更新 AGENTS.md、能用程式檢查的規範另外做成 linter;Matt 講的是最上面那一層,人要怎麼省時間。
我在 Day 1 提過,今年主管把幾個內部專案交給我,有機會替不同場景設計 Harness。規模跟這兩家差很遠,人少、時間也短,下面是我自己的做法,給同樣要在公司裡推 Agent 的人參考。我會把推廣拆成兩件事分開做:怎麼開發、怎麼測試。
開發:先寫幾個 skill,同時把回饋接回來。 一開始先從開發流程下手,把團隊最常做的事寫成幾個 skill,例如怎麼測、怎麼 build、哪些地方不能碰。回饋的流程同時做好:請 Claude Code 把這個 session 的回饋整理好,打一個 HTTP request 送到一台收回饋的 server。
Claude Code 的 hook 也能直接送 HTTP request,例如設成在 session 結束(SessionEnd)時,把 session 編號和結束原因 POST 出去(這個 hook 預設只等 1.5 秒,網路慢的話要把 timeout 拉長);用量和花費可以打開內建的 OpenTelemetry 匯出,送進公司的監控系統。
收到回饋就快速改 skill,下一輪的回饋看得出有沒有變好。Eval 要一套知道答案的題目,前面說過這最花工夫,經費有餘裕再做。
測試:先讓 unit test 跟著開發跑,再想好怎麼交給 QA。 驗證先從本機的 unit test 開始,讓 Agent 改完就跑,跟開發流程綁在一起,也就是 Matt 說的最下面那一層。做到這裡,迭代速度其實就能快很多。Agent 寫的測試,我會照前面 Matt 那一點檢查一遍,把實作再寫一次的刪掉。
接下來的問題是,驗證要怎麼交給 QA。unit test 過了還不夠,就算是線上服務,也要先部署到本地的環境實際跑一次。像我們開發 NAS,改完 code 要編好、換到一台 NAS 上測,Day 3 提過我們把換 code 的流程寫成了 skill,換上去之後怎麼驗,就是這一段要處理的。QA 可能還要實際按過一次,所以要先想好怎麼讓 QA 驗得快:一種是請 Claude Code 把畫面上一個操作背後的那一連串 API call 包成一支 script,QA 跑完看最後的結果是不是預期的;另一種是寫一份清楚好懂的 How to verify,寫明要怎麼操作、看到什麼才算對。
團隊小、只有幾個人在用的,開發那邊發幾個 skill,回饋當面講也收得到,大概就夠了。要讓整個部門一起用,回饋就要能自動送回來;測試那邊先讓 unit test 跟上,再處理交給 QA 這一段。至於把 AI review 做到能擋合併,要等累積夠多真實的紀錄和 bug,才有題目可以評它準不準。
Day 29 會講 Agent 自己改 skill 和 Harness,那時候要用的,就是這裡收到的回饋和驗證。
可以試著問自己兩題:公司剛導入 Agent 一個月,主管想馬上做一個 AI code review,擋下所有沒過的 merge request,你會怎麼建議?大家都裝了同一套 skill,三個月後 Agent 又開始常常改錯,可能差在哪?
第一題先別擋。還沒有一套知道答案的題目,就講不出它審得準不準;誤報一多,大家只會想辦法繞過它。可以先讓它只給建議,同時記下哪些意見被採納、哪些被忽略,之後整理成評測題。Cloudflare 的規範也是先只給建議,升級成 enforced 才擋。第二題多半是 skill 或 AGENTS.md 過時了:repo 換了測試框架、搬了目錄,說明沒跟著改。所以回饋要能回到 skill 本身,像 Cloudflare 讓 code review 看到這類改動時提醒更新。
全公司導入 Agent,開發和測試分開推:開發先發 skill、把回饋接回來、照回饋改;測試先讓 unit test 跟著開發跑,再把驗證交到 QA 手上;AI review 要擋合併,得先有一套知道答案的題目,人的時間留給回不去的改動。
今天看的是很多人各自用 Agent。明天換成 Agent 跟 Agent 之間:從同一個 Harness 裡組隊,到把工作交給別的團隊、甚至網路上不認識的 Agent,它們怎麼溝通、怎麼確認對方是誰。
AGENTS.md,開 merge request 給負責的團隊審;從第一天起 OpenCode 的模型請求先經過自己寫的 proxy,再到 AI Gateway;OpenCode 從公司網址拿共用設定,本機設定優先;13 個 MCP server、182 支以上的工具;Engineering Codex 做成 skill。數字是 Cloudflare 自己公布的。AGENTS.md。CODING_STANDARDS.md 只給 review 的 Agent,review 的 Agent 預設直接 commit;人只細看單向門的改動;同一種錯出現兩次就改產生它的系統。是個人的經驗分享,沒有公布數字。pr 在 PR 描述裡寫單向門或雙向門和影響範圍(Door、Blast Radius);retro 讀 session 紀錄,建議自動檢查、給 review Agent 的規範、該搬走的全域說明,機械性的錯一律做成自動檢查。type: "http",把事件的 JSON 用 POST 送到指定網址;SessionEnd 在 session 結束時觸發,帶結束原因,預設 timeout 1.5 秒,可以用 timeout 或 CLAUDE_CODE_SESSIONEND_HOOKS_TIMEOUT_MS 拉長。CLAUDE_CODE_ENABLE_TELEMETRY=1,再指定 exporter 和收資料的端點,就能用 OpenTelemetry 匯出 session 數、花費、token 等指標。

 iThome鐵人賽
 看影片追技術