
🗺️ 模型每一輪其實只做一件事:決定下一步。其他的事,像它看得到什麼、能做什麼、怎樣才算做完、任務做到哪了,都要靠模型外面的程式來管,這就是 Harness 的工作。這三十天,就是把這些事一件一件拆開來看。
昨天在 Day 29|番外篇:Harness 接下來會往哪走?,我們看了「模型會吃掉 Harness」這句話正反兩邊怎麼說,還有 Harness 最近往哪些方向發展。哪些會被吃掉還在吵,比較確定的是,判斷「做完了沒」的那套題目要留在自己手上。今天是最後一天,不開新題目了,回到 Day 1,把這三十天收個尾。
三十天前的 Day 1,我們從一次 LLM request 開始,接上工具就變成 Agent Loop:模型說下一步要做什麼,Harness 去執行工具,再把結果送回給模型。那天最後,我給 Harness 下了一個定義:決定模型看得到什麼、被允許做什麼、做完之後怎麼確認,讓結果不一定可靠的 LLM,也能一步步穩定地完成目標。
Day 1 用的例子是一次失敗的測試:模型說要用 read_test_log 讀 log,Harness 真的去讀,再把 log 放進下一輪,模型才看得到失敗訊息、解釋原因。那天最後留了兩個問題,說後面會回來回答。
第一題當時是這樣問的:工具的結果存進了資料庫,但沒放進下一輪,模型會知道嗎?現在回頭看,這題問得有點怪,沒放進去,模型當然不知道。比較容易出錯的是另一邊:事後查問題的人在資料庫裡看到那份 log,很容易以為模型也看過了。所以我把兩題改成這樣問:一、讀到的 log 存進了資料庫,就代表模型看過了嗎?二、模型最後說「原因找到了」,就代表它真的找對了嗎?
這兩題的答案就散在後面二十幾天裡。先把每一天放回 Day 1 那個 loop 上,看它補的是哪一段:
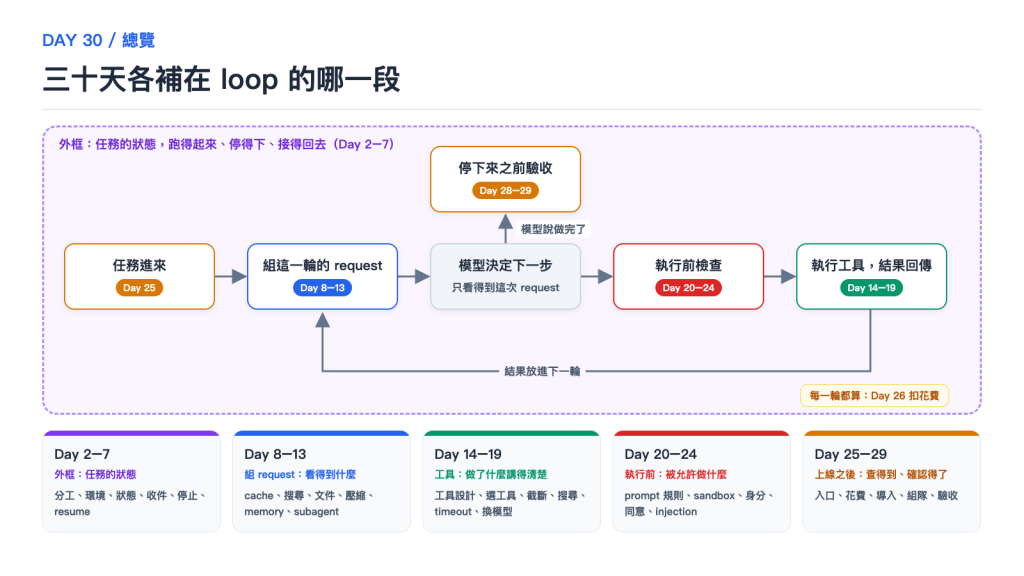
圖:Day 1 的 Agent Loop,每一段標上補在那裡的是哪幾天;外框是任務的狀態,下方五張卡是每部分講過的主題。
下面照 Day 1 分的五個部分走,每一天用一句話講它的結論,最後再回來回答那兩題。
Day 1 的 loop 只要一口氣跑完就好,但真的拿來用就沒這麼單純了。先要分得出問題出在模型還是 Harness,也要確認環境準備好了沒;接著任務會等人、會被使用者打斷、會換一台機器接著做,所以 Harness 得記住它做到哪,而且要記到換一個 process 也接得下去。
| Day | 答案 |
|---|---|
| Day 2|換了模型還是不穩:沿著 Agent Loop 找真正的瓶頸 | 先沿著 loop 看模型拿到了什麼、能做什麼;缺的是拿不到的資料,就改 Harness,換模型補不回來;改完用同一批任務確認有沒有幫助。 |
| Day 3|工具都接上了,事還是做不完:Agent 動手前、動手時、做完後,環境各要準備什麼 | 工具後面的環境要讓 Agent 找得到做法、真的跑得起來,最後拿得到能檢查的結果。 |
| Day 4|running 轉了一整天,是在等人還是掛了:任務狀態要記到別人接得下去 | 任務狀態要記到別人接得下去:做到哪、在等誰、等到了從哪裡繼續。 |
| Day 5|訊息先到了,模型還沒讀到:收下和送達要分開記 | 模型讀的對話只有 loop 能寫;loop 忙的時候進來的訊息,收下記一筆,寫進對話再記一筆。 |
| Day 6|按了停止還在改檔:Interrupt、Steer、Cancel 必須分開 | 停止畫面、停止工作、擋住舊結果、處理已經發生的效果,是四件要分開確認的事。 |
| Day 7|Worker 消失後怎麼接手:把進度留在 Process 外 | 對話、檔案、本機命令和外面那筆 CI 是四份各自獨立的狀態,resume 接回哪幾份,要看工具實際存了什麼;外部工作的編號要在送出去之前就存在 process 外。 |
模型只看得到這一次 request 裡的東西,所以 Harness 每一輪都在挑要放什麼進去。放太多,會慢、會貴,還可能答得更差;放到過期的版本,它就照著過期的做。
| Day | 答案 |
|---|---|
| Day 8|Prompt Cache 命中率:我做 Agent 時最先看的效能指標 | 命中率牽動每一輪的速度和費用,又很容易被一次不起眼的改版弄壞,每一版都要拿數字盯著。 |
| Day 9|Context 塞滿還是找錯:讓 Agent 按需發現證據 | 資料可以先留在 Context 外面,前提是 Agent 找得到、讀得到,結論也查得回原文。 |
| Day 10|文件寫了卻沒被讀到:知識需要可驗證的送達路徑 | 文件寫好只代表它存在,要確認它在什麼時候、以哪個版本進了模型輸入。 |
| Day 11|Compaction 壓完,原文去哪了? | 壓縮讓對話跑得下去,原文通常還在,摘要要記下出處才找得回去。 |
| Day 12|Memory 記住的事,過期了怎麼辦? | 寫進去時連當時的條件一起存,讀回來先看多舊、條件還在不在;有了新說法,舊的標成已取代。 |
| Day 13|多開幾個 Subagent,會比較快嗎? | 先換到的是乾淨的主對話;會不會快,看分出去的工作重疊多少。 |
模型看不到工具裡面發生了什麼,只看得到回傳的那一段。所以工具怎麼設計、回傳寫了什麼,會決定它下一步判斷得對不對;外面的操作到底有沒有做成,也得靠 Harness 去查清楚。
| Day | 答案 |
|---|---|
| Day 14|API 直接轉成工具,退款金額誰來算? | 工具照 Agent 的任務設計:模型判斷退哪幾件,金額由系統照規則算,做了什麼、為什麼被拒都寫進回傳。 |
| Day 15|工具越多,選錯越多:控制 Agent 當下看見的能力面 | 用不到的拿掉、重疊的合併,名稱和說明寫到分得開;還是很多,常用的一直給,其餘先只給名字、用到再載入。 |
| Day 16|工具輸出太長,截掉就好嗎? | 只回一部分可以,要講清楚讀到哪裡、為什麼只有這些、下一段怎麼拿。 |
| Day 17|Agentic search 停下來時,怎麼知道找齊了? | 交回時附上用哪些線索搜、排除了什麼、哪些還沒驗證。 |
| Day 18|Timeout 之後,可以直接重試嗎? | timeout 時動作可能已經做了;要再送,就帶從「做哪一件事」算出來的同一把 key,先查有沒有做過。 |
| Day 19|做到一半換模型,任務接得下去嗎? | 把確認過的結果(改好的檔案、diff)直接交給新模型;搬不過去的狀態,就用新模型自己的 prompt 和工具開新的一輪。 |
寫在 prompt 裡的規則,對模型來說只是一段讀到的文字,它不一定會照做。權限要放在模型外面、真正執行的那條路上:用誰的身分、碰得到哪些檔案和網址、哪些動作要先問過人。
| Day | 答案 |
|---|---|
| Day 20|寫在 Prompt 裡的規則,擋得住 Agent 嗎? | 擋不住;讀了外部內容的那一步不能拿著能寫回的 token,寫回交給另一段程式,只做規則允許的事。 |
| Day 21|開了 Sandbox,就安全了嗎? | Claude Code 的 sandbox 打開之後,Bash 只能寫專案目錄、連不到沒允許的網址,但家目錄的憑證和環境變數的密鑰照樣讀得到,要另外收緊,再實際跑一次確認。 |
| Day 22|Agent 該用誰的身分做事? | 用它自己的身分,再註明它代表你;本機的 Claude Code 用的是你的帳號,GitHub 分不出哪些是它做的。自己做的 Agent,讓使用者用 OAuth 授權給你的 App,token 存在 Harness、可以單獨撤銷;服務那邊看不出是哪個 App 做的,就由 Harness 自己記下它代表誰。 |
| Day 23|使用者按下同意,到底同意了什麼? | 同意的是按下去那一刻看到的那一筆;Claude Code 的「不再問」會存成一條規則,開頭相同的指令都放行;執行前要比對指令和當時的狀態,換個寫法就繞得過的規則擋不完,最後一關放在遠端。 |
| Day 24|Prompt Injection 擋不完,怎麼辦? | 同一輪裡,別讓這三件事同時成立:讀到外人寫的內容、讀得到私有資料、寫得到外人看得到的地方。token 只給這次任務的 repo;拆不開的話,寫到公開位置之前先比對這一輪讀過什麼,讀過私有 repo 就停下來讓人看。 |
Agent 一放到背景跑,就沒人盯著畫面了。工作從哪裡進來、花了多少錢,都要 Harness 自己記下來;再往後,推給整間公司用、交給別的 Agent 做,甚至讓 Agent 自己改 Harness,到底做完了沒、有沒有改得更好,都得用 Agent 以外的東西來確認。
| Day | 答案 |
|---|---|
| Day 25|Agent 被 Webhook 叫起來,怎麼做到剛好一次? | 先存進資料庫再回成功,同一張 Issue 只建一件工作,再定期對帳補回漏掉的通知。 |
| Day 26|Agent 的錢花在哪,該盯哪個數字?詳解如何控制 Harness 成本 | 錢大多花在每一輪把整段對話再送一次,Prompt Cache 決定是 1 倍還是好幾倍;每一版 Eval 答對率旁邊先看命中率,上限記在整件工作上。 |
| Day 27|番外篇:全公司導入 Agent,該從哪一步開始? | 開發和測試分開推:開發先發 skill、把回饋接回來、照回饋改,再一段一段把流程交給 Agent;測試先讓 unit test 跟著開發跑,再把驗證交到 QA 手上;AI review 要擋合併,得先有一套知道答案的題目。 |
| Day 28|番外篇:把 Agent 放進開放世界,它們要怎麼組隊、溝通、互相信任? | 先分出查資料、出意見的工作,動手改的最好只留一個;交辦和交回都寫清楚;另一個 Agent 寫的字當外人寫的,身分、授權和「做完了」都由收的這邊驗。 |
| Day 29|番外篇:Harness 接下來會往哪走? | 替模型補能力的提示會被下一代模型刪掉或訓練進去,loop 和 sandbox 變成平台服務,工具和 skill 變成共用的格式;判斷做完了沒的題目留給自己。Agent 自己改 Harness,也要拿它碰不到的題目量,影響每個任務的改動讓人合併。 |
Day 12 說過,skill 和團隊規則要怎麼驗證過再更新,留到最後再聊。這件事後來在 Day 29 一起講了:先讓 Agent 讀回饋、提修改、開 PR,由人來合併;要讓它自己一輪一輪改,就得先有一套它碰不到的題目。
也有幾件前面說好要講,最後卻沒寫到的,這裡老實交代一下。Day 16、18 和 Day 22 到 25 都說過,失敗之後該怎麼恢復、出事之後怎麼從紀錄一步一步查回去,會在 Day 27、28 講;結果寫到那邊,我把 Day 27 到 29 改成了番外,這兩件就沒有專門寫一篇。不過要用的零件前面都有:Day 4 每改一次狀態就追加一筆的變更紀錄、Day 18 從「做哪一件事」算出來的 Operation ID、Day 25 的對帳。另外 Day 7 說 Day 30 會接著講「做到一半的工作碰到版本升級怎麼辦」,也沒寫到,可以先參考那天引的 Cursor 做法:放在流程引擎裡、一跑就是很久的 workflow,拆短一點,升級就好做多了。
第一題:讀到的 log 存進了資料庫,就代表模型看過了嗎?不代表。Day 1 就講過,模型只看得到這一次 request 裡的東西,存在資料庫裡的它看不到。麻煩的是從外面看,很容易以為它看過了,後面幾天就碰到好幾次:Day 5 訊息收下了,還沒送進模型;Day 10 文件寫好了,沒進模型的輸入;Day 16 Claude Code 的 WebFetch 碰到太長的網頁,只把前面一段交給小模型整理,回傳時也沒說只讀了前面。所以東西存在哪裡都不算數,要看組 request 的時候,有沒有真的把它放進去;想知道模型當時看到什麼,就去看那一次 request 實際送了什麼。
第二題:模型說「原因找到了」,就代表它找對了嗎?也不代表,那只是它自己的判斷,要證明得靠它以外的東西。Day 17 要它交回搜了哪些線索、排除了什麼,別人才有東西可以檢查;Day 28 另一個 Agent 說做完了,交辦的這一方還是要用自己的標準驗收;Day 29 Agent 自己改了 Harness、說分數變好了,也要拿它沒看過的那份題目再跑一次,那份也變好才算數。往後看也是同一題:Harness 裡有些工作會慢慢交給模型和平台,但「到底做完了沒」,還是得用自己的題目來確認。
如果你手上已經有一個 Agent,不管是自己刻的還是直接用 Claude Code,都可以拿上面五個小標一個一個問它:任務停了接得回去嗎?這一輪它看得到什麼?工具回來的結果講得清楚嗎?它被允許做什麼?做完了要怎麼確認?哪一題答不出來,就回去翻那一部分的幾篇。
只是自己坐在電腦前用 Claude Code 的話,前四部分它內建了不少,先把相關設定看一遍:resume 和 compaction、權限規則、sandbox、auto mode(動作執行前先讓另一顆模型看一眼)。不過內建的不一定夠,像 Day 21 講的,sandbox 打開後家目錄的憑證還是讀得到,要自己再收緊。等到 Agent 要放到背景、沒人盯著跑,第五部分就得自己補了。換作是我,會先把回饋接回來(Day 27),再把出過錯的任務留下來當題目,分成看得到和看不到兩份(Day 29 的第一步)。之後不管換模型、換平台,還是讓 Agent 讀回饋自己提修改,都拿這套題目來量;哪裡常出錯、規則該怎麼改,看回饋和分數慢慢就看得出來。
回頭看這三十天,我們從 Day 1 的一次 LLM request 開始,接上工具變成 Agent Loop,然後一塊一塊往上補:先讓任務停得下、接得回去,再來看模型每一輪看得到什麼、工具做了什麼講不講得清楚、Agent 被允許做什麼,最後是上線之後怎麼查、怎麼確認真的做完了。收尾的三篇番外,則是聊了整間公司怎麼導入 Agent、Agent 之間怎麼組隊、互相信任,還有 Harness 接下來會往哪走。
Day 1 提過,去年推坑同事來挑戰鐵人賽,結果他一路撐完三十天還拿了佳作,推坑的我自己反而沒完賽過。今年總算寫完了,雖然最後五天人在日本,連載得有點抖抖的 XD,但研究所那次沒寫完的遺憾,也算補上了。
也要老實說一件事:我不太擅長寫作,所以這三十篇的寫法是,先跟 AI 討論當天想講什麼概念,加上我自己的論述,再請 AI 幫忙找參考資料和範例,慢慢把文章填起來。也因為這樣,有些地方讀起來會有點 AI 感,或是不太通順,還請見諒,後續會用比較好讀的方式整理到 blog 內。
寫到一半,我發現 Day 13「多開幾個 Subagent,會比較快嗎?」來看的人比我想的多很多,所以後面還沒發布的標題,我都改成比較通用的問句,例子留在正文裡。
說是寫完了,其實我自己也還在探索。Harness 會跟著模型的能力一起變:Day 29 講到,替模型補能力的那些提示,下一代模型一出來可能就被拿掉了。這個系列裡有些做法大概也一樣,明年再看可能就用不到了。我比較希望留下來的,是每篇開頭問的那個問題,就算換了工具也還用得上。
反過來,模型也會習慣某一套 Harness。有些模型在訓練時,就拿某一套 Harness 再微調過(用那套的工具和格式多練幾輪),練久了,換一套就可能變差。Day 29 舉過例子:Cursor、Cognition 直接拿自家的 Harness 練模型;Cursor 也說過,OpenAI 的模型習慣用 patch 改檔案,Anthropic 的模型習慣用字串取代,給它不熟的那種,就比較容易改錯。整套 Harness 換掉,差距可能更大:Princeton 在 CORE-Bench Hard 上量過,同一顆 Opus 4.5 放在 Claude Code 裡是 77.78%,換成他們自己寫的 Harness 只剩 42.22%。所以我猜 Claude Code 換成別家的模型,大概也沒這麼強;Day 19 換模型時要替每顆模型各配一套 prompt 和工具,也是這個原因。不過也不是每次都這樣:換成 Opus 4.1,反而是 Princeton 那套比較好;也有一篇預印本量出來,原廠的 Harness 跟中立的差不多。所以我現在的做法是,模型和 Harness 當成一組來挑,先用原廠配好的那一組;想換掉其中一個,先拿自己的題目跑一次,分數沒掉再換。
未來會變成什麼樣子,我不敢說,但我覺得短期內工程師應該還是有很多工作機會。軟體生得再快,也要有人用,需求永遠都在。拿我自己平常的工作來說,spec 寫完之後,光是實作一個功能就會牽扯到一大堆系統;沒有講清楚的話,AI 根本不知道預期的量級有多大、各個服務之間怎麼互動。就算用 Claude Code 配 Opus 5.5、effort 開高,照 SDD(spec-driven development,先寫好 spec 再讓 AI 照著做)的方式來,還是會漏東漏西:規劃階段常常要花不少人力介入,最後測試的時候也還是會抓到一大堆錯。
既然沒辦法 one shot,我覺得工程師的經驗就還用得上:把大功能拆小,想清楚每一塊要怎麼驗證。這其實也是這三十天一直在講的事:模型不知道的,要有人放到它看得到的地方;它說做完了,要用它以外的東西確認。
我覺得這個時代的工程師最重要的能力應該是快速適應,任何不懂的事情就是不斷地跟 AI 討論,不斷地死纏爛打,比起以前資訊比較不流通的時代,現在不斷的深入研究任何人都可以在一定的時間內熟悉某個技術。另外對於已經很有經驗的工程師來說,過往的經驗也可以確保你問對問題,畢竟很多時候 Agent 只會做你提到的事情,一些前提沒有事先告知或者你根本沒想到的話就不一定會包含到實作內。希望大家都可以在這個快速變化的時代站穩腳步,一起享受這個用嘴巴就可以把 POC 生出來,想學什麼問就對了的黃金年代。


 iThome鐵人賽
 看影片追技術