
💰 錢大多花在每一輪把整段對話再送一次,模型寫出來的只占一小塊。Prompt Cache 決定這筆錢是 1 倍還是 7 倍,Eval 又要把同樣的工作跑好幾百遍,所以每一版 Eval 第一個要看命中率。工具和 skill 用到再載入,每輪要送的就少。一件工作連 CI 和第三方 API 總共花多少,現成的上限都算不到,要 Harness 自己記一本帳。
昨天在 Day 25|Agent 被 Webhook 叫起來,怎麼做到剛好一次?,我們讓同一件工作不會被叫起來兩次。今天看它跑起來之後花了多少錢。
先說明一下寫法。前面 25 篇,大多從一個假設的情境開始:某個 Agent 在哪一步出事、Harness 少了什麼、要補什麼。最後這幾篇我想換個方式寫。今天講成本,就不舉假設的例子了,直接看實際跑出來的用量。之後三篇也不再是上線前的檢查清單:先用一篇番外看整間公司怎麼導入 Agent,再看最近兩個趨勢:Agent 怎麼把工作交給另一個 Agent、Agent 能不能自己把 Harness 改得更好,順便聊聊接下來可能的走向。
快速回顧一下:Day 8 講過 Prompt Cache,模型處理過的前段內容會先留著,下一輪開頭一模一樣,就直接拿來用,讀的價錢只有平常輸入的一小部分。那篇我說命中率是做 Agent 最該盯的指標,今天用帳單說明為什麼。Day 11 的壓縮和 Day 13 的 subagent,今天也都會在帳上看到。
用量來自我們自己運行的一套 Harness。從 9 月 18 日到 10 月 9 日這三週,它把每一次呼叫模型的用量都記在本機:送進去的 token 有多少是從 cache 讀的、多少是新寫進 cache 的,模型又寫出多少。三週一共 7,825 次呼叫,含它派出去的 subagent。照官方的 API 價目表換算大約 975 美元;同樣的用量,如果完全沒有 cache,要 6,887 美元。
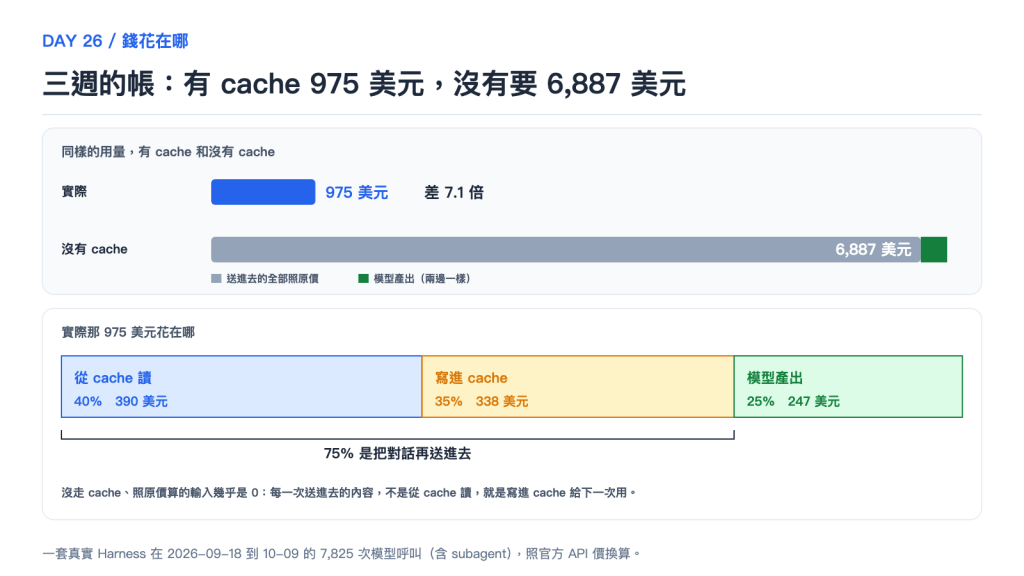
圖:上半是同樣的用量,有 cache 975 美元、沒有 cache 6,887 美元,差 7.1 倍;下半把 975 美元拆開,從 cache 讀 40%、寫進 cache 35%、模型產出 25%,前兩塊加起來的 75% 都是把對話再送進去。這是一套 Harness 三週的紀錄,換一套工具或換一種用法,比例會不一樣。
模型寫出來的只占 25%。下面先拆這筆錢花在哪、cache 省了多少、用不到的東西怎麼別先放進去,再看 Eval 為什麼貴、為什麼每一版第一個要看命中率,最後是上限要記在哪一層,還有其他省法。
Day 1 的 loop 每一輪都要打一次模型 API。模型不記得上一輪,所以每一輪都把整段對話重新送一次:system prompt、工具定義、使用者的話、模型前面每一輪的回覆、每一個工具結果。Agent 叫一次工具就多一輪,對話越長,每一輪要送的就越多。
下面是那套 Harness 的一段實際紀錄,同一個對話裡連續四次呼叫,前後隔十幾秒:
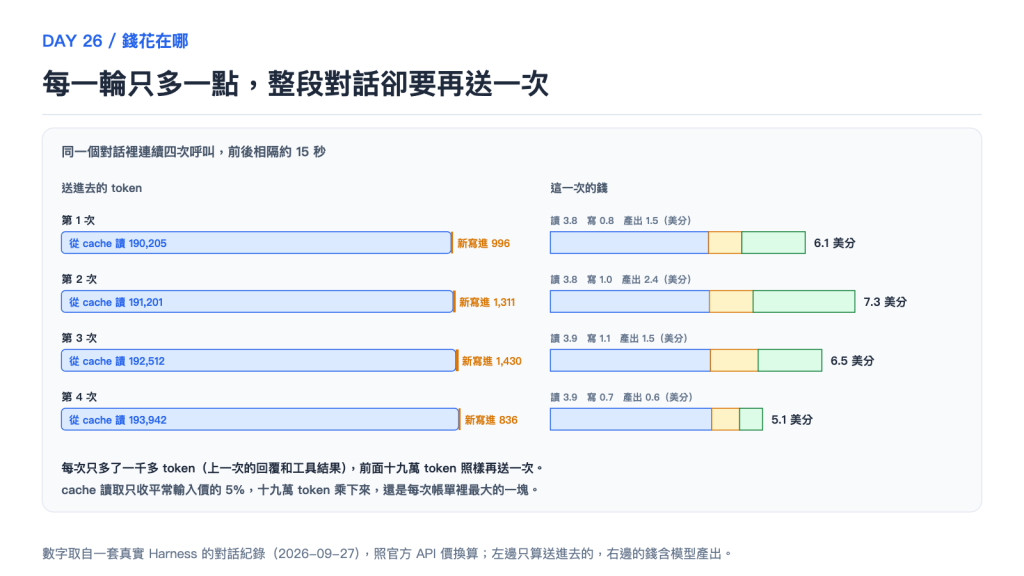
圖:左邊是每次送進去的 token,十九萬左右從 cache 讀,新寫進的只有一千上下;右邊是每次的錢,5 到 7 美分,讀 cache 那段最長,寫進 cache 和模型產出各占一小段。這四次是同一個對話裡連著的呼叫,數字照官方價目表換算。
每次新增的那一千多 token,是上一輪模型的回覆加上工具結果;前面那十九萬 token 每次都要再送一次。讀 cache 很便宜,這套 Harness 主要用的模型,讀的價錢是平常輸入的 5%,可是乘上十九萬,還是每次帳單裡最大的一塊。
寫進 cache 的 token 每次只有一千多,為什麼整份帳單裡占了 35%?因為寫比讀貴得多。照價目表,寫進只留五分鐘的 cache 是平常輸入價的 1.25 倍,留一小時的是 2 倍。這套 Harness 主要用的模型,同一個 token 寫一次的錢,夠讀它四十次。每一輪新增的內容都要先寫進去,下一輪才讀得到,七千多次呼叫累積下來就是那 35%。
對話一長,這筆錢就跟著長。下面是三週裡最長的一個對話,兩天裡呼叫了 842 次:
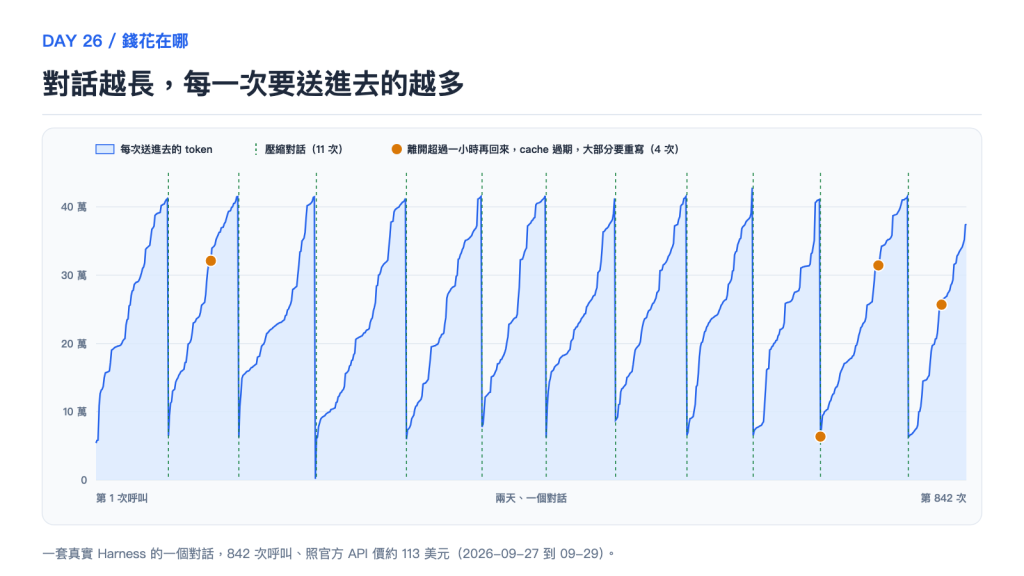
圖:藍色是每次呼叫送進去的 token,一路爬到四十萬左右;綠色虛線是 11 次壓縮,壓完掉回幾萬再往上爬;橘點是 4 次離開超過一小時再回來,cache 已經過期,大部分要重寫。這個對話照官方價目表約 113 美元。
每次要送進去的 token 一路爬到四十萬左右,才被壓縮拉回幾萬,接著又開始爬。三週所有主對話的呼叫,每次送進去的中位數是 22 萬 token。輪數多一倍,每一輪又比前面長,所以對話長兩倍,花費不只兩倍。壓縮除了讓對話跑得下去,也是在省錢。
這不是只有我這樣。Elastic 今年 9 月有一篇文章,標題就叫〈Why your AI bill tripled while token prices fell 75%〉,講的是一件工作從回答一個問題,變成自己跑完好幾步,token 單價降了,用量漲得更快。文中引了一份 2026 年、涵蓋 30 個上線團隊的審查,重複送的 context 占推論帳單的 62%;那份審查沒寫是誰做的,我只當參考。Anthropic 談多 Agent 研究系統的文章自報,Agent 用的 token 大約是一般聊天的 4 倍,多 Agent 系統大約 15 倍。
Harness 怎麼寫,也會讓帳單差好幾倍。Databricks 在自家程式庫比較 Coding Agent,同一個模型、同樣的 thinking effort,換一個 Harness,部分案例每題成本差了兩倍以上,主要差在每一輪送給模型多少 Context。Anthropic 3 月那篇 Harness 設計的文章更直接:同一個題目,單一 Agent 跑 20 分鐘花 9 美元;換成規劃、實作、檢查分開的完整 Harness,跑 6 小時花 200 美元。做出來的東西好很多,錢也多了二十倍。
還有一些錢不在模型的帳單上。Agent 叫工具去跑的 CI、sandbox 開著的時間、第三方 API,都記在別的帳上。GitHub 託管的 runner 照分鐘計費,私有 repo 用完方案內含的分鐘數就要付錢;Dropbox 的 Nova 修不穩定的測試時,會看原本的失敗率,在 CI 上把那支測試重跑一百次以上,才算驗證過。算一件工作花多少,這些也要算進去。
這份帳裡,沒走 cache、照原價算的輸入幾乎是 0:每一次送進去的內容,不是從 cache 讀,就是寫進 cache 給下一次用。三週下來,送進去的 token 有 97.2% 是從 cache 讀的。拿掉 cache,同樣的用量要 7.1 倍的錢。
省這麼多的不只這套 Harness。今年 1 月有一篇論文〈Don't Break the Cache〉,在 OpenAI、Anthropic、Google 三家的 API 上,用一個要搜尋網頁幾十次的研究型任務跑了 500 多個 Agent session,cache 省下 41% 到 80% 的費用,第一個 token 出來的時間也快了 6% 到 31%。它也點出哪些寫法會讓 cache 白做:會變的內容放在前面、每次都不一樣的工具結果放進 cache 的範圍;整段對話不分青紅皂白都丟進 cache,有時反而讓延遲變長。這跟 Day 8 列過的那幾種改動是同一件事,前綴一變,後面全部要重寫。
回到這份帳,cache 接不上的情況不多。我把「這一次從 cache 讀到的,比前一次送進去的少了一成以上」算成一次接不上:
這些呼叫寫進 cache 一共 49 美元左右,占 5%,裡面還包括每一輪本來就要寫的新內容。同一個對話裡,前面的內容幾乎沒變過,所以大部分時候都接得上。
比較值得講的是 cache 要留多久。這套 Harness 用的 API 有兩種:留五分鐘的,寫入是平常輸入價的 1.25 倍;留一小時的,寫入是 2 倍。紀錄裡,主對話一律寫一小時版,subagent 一律寫五分鐘版。我照主對話實際的呼叫時間重算了一次:
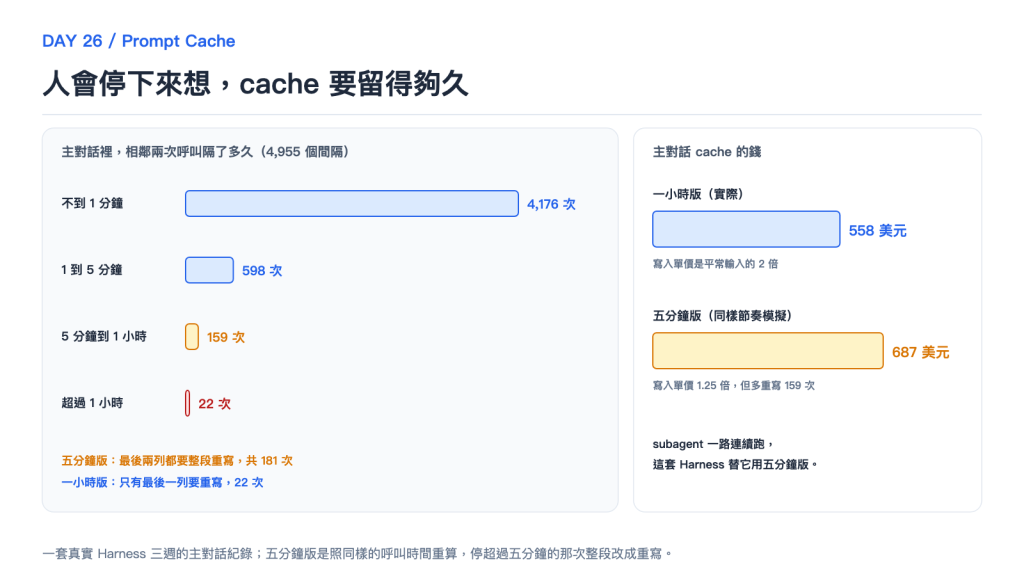
圖:左邊是主對話裡相鄰兩次呼叫隔了多久,4,176 次不到一分鐘、598 次一到五分鐘、159 次五分鐘到一小時、22 次超過一小時;右邊是主對話 cache 的錢,實際用一小時版是 558 美元,照同樣的時間改用五分鐘版重算是 687 美元。五分鐘版是推算的,假設停超過五分鐘的那一次整段重寫。
相鄰兩次呼叫,大部分隔不到一分鐘,那是 Agent 自己一輪接一輪在跑。可是有 159 次隔了五分鐘到一小時,多半是人停下來讀結果、想下一步要它做什麼。五分鐘版碰到這種停頓就過期了,下次要整段重寫。照同樣的節奏算,主對話的 cache 費用會從 558 美元變成 687 美元,多 23%。subagent 一路自己跑,中間沒有人停下來,用五分鐘版剛好。
所以 cache 留多久,要看誰在用。有人在旁邊看、會停下來想的對話,留久一點;排程或背景跑的,留短的就好。這是我從這份帳推的,每套 Harness 的節奏不一樣,拿自己的紀錄算一次最準。各家能選的也不一樣,OpenAI 的 prompt caching 文件寫,cache 預設就開著;GPT-5.6 之後的模型,最後一次寫入或用到之後留 30 分鐘,更早的模型大約 5 到 10 分鐘沒用就過期,可以另外設定延長。
subagent 還有一件事要知道:它在主對話外面另開一段對話,前綴跟主對話不一樣,cache 也是各算各的。這份帳裡 90 個 subagent 一共呼叫 2,836 次、花 210 美元,占 22%;平均一個 subagent 接一件小工作,跑 31 次呼叫,花 2.34 美元。等一下算 Eval 會用到這個數字。
要。前面拆過,錢大多花在每一輪把整段對話再送一次。工具說明、skill、system prompt 都在這一段裡,模型這一輪用不用得到,都會跟著送。一份用不到的工具說明放在最前面,對話跑 30 輪就送 30 次。有 cache 會便宜很多,寫進去之後每輪只付讀的錢,可是它一直占著 Context 的位置:對話比較早滿、比較早被壓縮(Day 11),工具一多,模型也比較容易挑錯(Day 15)。
所以現在常見的做法,是完整內容先不放進去,模型確定要用了再拿進來。Anthropic 的 Agent Skills 文件把這叫 progressive disclosure:啟動時每個 skill 只放名稱和描述,一個大約 100 token,任務對得上才讀完整的說明,更細的參考資料用到才讀(Day 10)。
工具也一樣。Anthropic 介紹 tool search 的文章算過一組常見的設定,GitHub、Slack 等五個 MCP server 共 58 支工具,對話還沒開始就用掉約 55K token。打開 tool search,工具的完整定義一開始不放進 Context,模型要用時先搜尋,找到哪支才載入哪支;載入的定義是後來才加進去的,前面已經 cache 好的 system 和常用工具照樣能重用(Day 8)。Day 14 實際量過一次,同一組工具打開 tool search,一次 request 從 32,261 token 降到 15,574。
如果 tool search 沒開,每次多送這約 1.7 萬 token,套到我們這三週的 7,825 次呼叫上,有 cache 大約多付 44 美元,不到整份帳的 5%;沒有 cache 就是 589 美元。所以錢的部分 cache 已經擋掉大半,工具定義晚一點再載入,省下來的主要是 Context 的位置。這只是粗估,實際差多少,要看接了幾個 server、裝了幾個 skill。
我覺得最關鍵的,還是 Day 9 講的 context engineering:只給 Agent 這一步需要的東西。skill 和 tool search 都是照這個想法做的。Anthropic 的 Context engineering 文章把 Context 當成有限的資源,要找的是最少、但最有用的那一組內容。資料先留在外面、用到再讀(Day 9),工具輸出太長就只回一段、講清楚下一段怎麼拿(Day 16),也是同一個想法。放進去的東西少了,Context 不會一下子就滿,每一輪要送的也跟著少。
Eval 在 Day 8 講過,是拿一組固定的任務,讓新舊版本各跑一次,比結果,也比代價。Agent 的 Eval 很貴,因為錢是乘出來的:
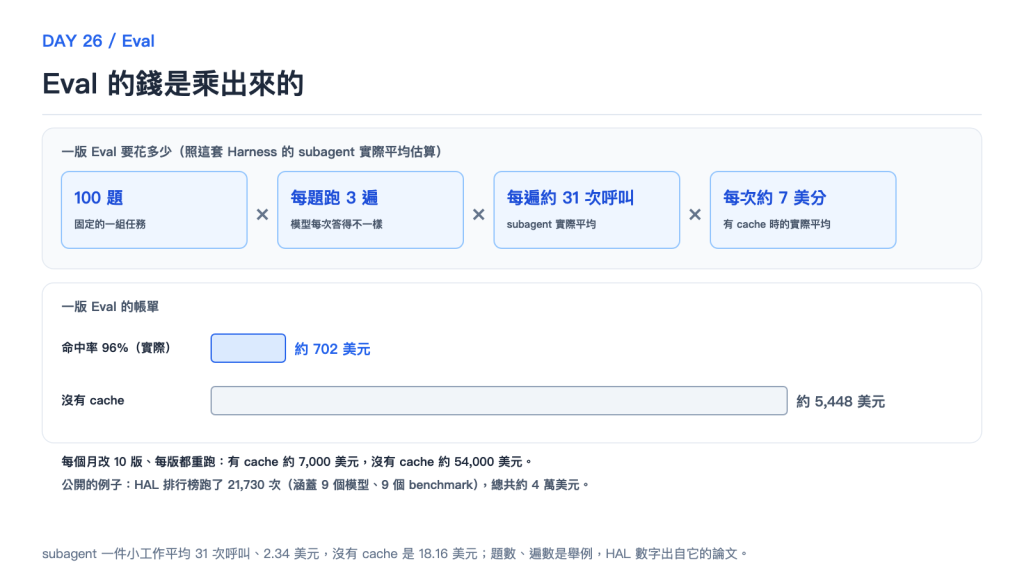
圖:上排是一版 Eval 的乘法,100 題、每題跑 3 遍、每遍約 31 次呼叫、每次約 7 美分;下排是一版的帳單,命中率 96% 時約 702 美元,沒有 cache 約 5,448 美元。每遍的呼叫數和花費取自那套 Harness 的 subagent 平均,題數和遍數是舉例。
假設一組 100 題,每題跑 3 遍,因為模型每次答得不一樣,跑一遍看不出穩不穩。照上一節 subagent 的平均,一題跑一遍大約 2.34 美元,一版 Eval 就是 702 美元左右。一個月改十版、每版都重跑,七千多美元。沒有 cache,一件小工作要 18.16 美元,同樣的 Eval 一版五千多,一個月五萬多。
公開的例子更大。普林斯頓團隊做的 HAL 排行榜,在 9 個模型、9 個 benchmark 上跑了 21,730 次 Agent,總共花了大約 4 萬美元,平均一次 1.8 美元左右,跟上面那件小工作的 2.34 美元差不多大。同一群人更早的論文〈AI Agents That Matter〉比過幾個複雜的 Agent 架構和簡單的做法,準確率沒有明顯差別,最貴的那個花費是簡單做法的 50 倍以上。他們的結論是 Agent 的評估一定要把花費一起算,只比準確率的排行榜,會把大家帶去做又複雜又貴的 Agent。
我覺得每一版 Eval,答對率旁邊第一個要放的是 Prompt Cache 命中率。
第一個理由,答對率一樣,帳單可以差好幾倍。改版時在 system prompt 開頭放一個每輪都會更新的時間,或是每輪把工具的順序重新排過,模型的回答幾乎不受影響,答對率照樣過關;可是前綴每一輪都不一樣,cache 一路對不上,每一輪都要整段重寫。這份帳拿掉 cache 是 7.1 倍;cache 開著卻每次都對不上更貴,最壞的情況一點都讀不到,送進去的全部用寫入的價錢付,同樣的用量是 12.6 倍。只看答對率的 Eval,這種退步一點都看不出來。
第二個理由比較直接:Eval 本身的錢,也是命中率決定的。上面那張圖,命中率 96% 跟沒有 cache,一版差了將近八倍。
還有一個容易忽略的:Eval 量到的命中率,常常比上線後好看。Eval 一題接一題連著跑,中間沒有人停下來,cache 一直是熱的。真的有人在用的時候,會停下來讀、會去開會,上一節那 159 次停頓,在 Eval 裡一次都不會出現。所以 Eval 的命中率要當成最好的情況看,上線之後還是要盯實際的命中率,或者在 Eval 裡照真實的節奏插入停頓。
命中率不用另外量,每次呼叫 API 回傳的用量裡就有。Anthropic 把送進去的 token 分成沒走 cache 的、從 cache 讀的、寫進 cache 的三個數字,OpenAI 在輸入的用量裡標出 cached token 有多少,它的文件還直接建議把 cached token 總數除以 input token 總數,照使用者、workspace 或每天分組來看。這份帳的命中率是 97.2%。我會在每一版 Eval 的報告裡,把答對率、每題花費、命中率三個數字並排;命中率掉下來,就算答對率一樣,也先查清楚是哪個改動動到了前綴。
Eval 本身也有省錢的辦法。它不用馬上拿到答案,可以走批次 API,Anthropic 的批次處理輸入輸出都打五折,還能跟 cache 的折扣疊在一起。題目也不用每次全跑,改了小地方先跑一小組,命中率和答對率都沒掉,再跑完整的那組。
知道錢花在哪之後,還要擋得住。替花費設上限的工具不少,差在兩件事:管多大的範圍,到了是擋下來還是只提醒。照範圍從小排到大:
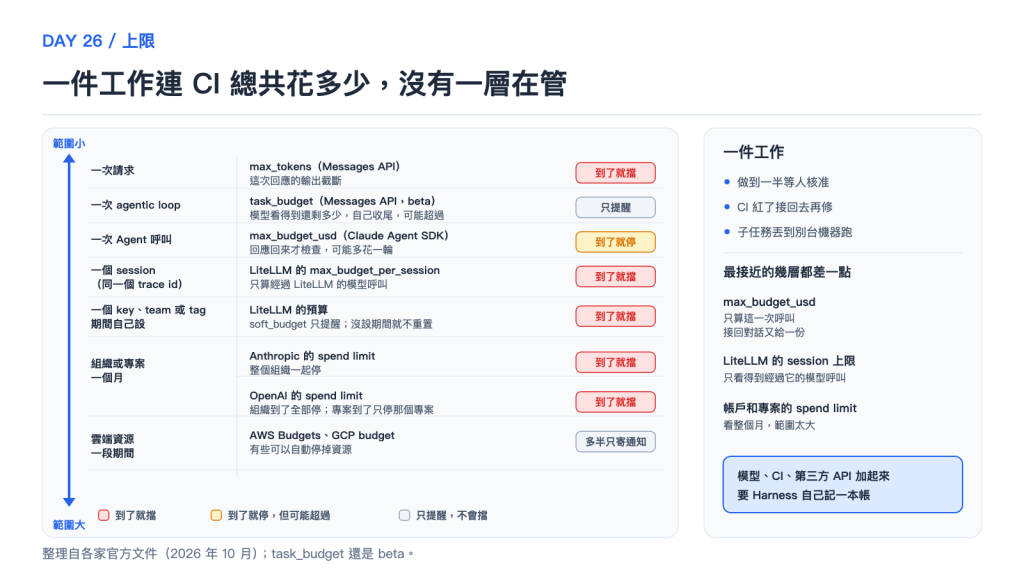
圖:左邊從一次請求排到雲端資源,越往下範圍越大;紅色是到了就擋,橘色是到了就停、但可能超過,灰色只提醒。右邊是一件工作:會跨好幾次呼叫,最接近的幾層都差一點,模型、CI、第三方 API 加起來,要 Harness 自己記一本帳。這只是整理現成的上限,不是每一層都要設。
出處分別是 Anthropic 的 task budget 文件、Agent SDK 的 agent loop 文件、Anthropic 的 rate limits 文件、OpenAI 的錯誤碼說明、LiteLLM 的預算文件、AWS Budgets actions 和 GCP 的 budget 文件。
可是一件工作常常跨好幾次呼叫:做到一半等人核准、CI 紅了接回去再修、子任務丟到別台機器跑。max_budget_usd 只算這一次呼叫,成本追蹤文件寫,接回同一段對話時,之前花掉的不算進這次的上限,等於又給了一份。最接近的是 LiteLLM 替 Agent 設的 session 上限,它用 trace id 把同一個 session 的呼叫串起來;可是它只看得到經過 LiteLLM 的模型呼叫,CI、sandbox、第三方 API 的錢不在裡面。帳戶和專案的 spend limit 看的是整個月,範圍又太大。「這一件工作連模型帶 CI 總共花了多少」,沒有一層在管。
所以我會讓 Harness 自己替每件工作記一本帳,模型、CI、第三方 API 都扣同一本,不管中間接回幾次、跑在哪台機器。舉個例子,一件在 CI 紅燈時讓 Agent 修測試的工作,上限 8 美元:第一次模型花了 6.10、跑三次 CI 花了 0.90,CI 還是紅的,接回去再修時只能給剩下的 1.00,不能又給 8。
平行的子任務比較麻煩,兩個 job 同時來要額度,各自「先查餘額、再扣」,會花到同一份錢。這有現成的做法可以參考:刷卡的預授權。Stripe 的文件舉飯店為例,入住先授權整筆金額扣留在卡上,退房再照實際金額請款,沒用到的放回去。LiteLLM 對模型請求也這樣做,它的 budget reservation 在請求送出前,照請求內容估出最多會花多少,先扣留,回應回來再換成實際費用。搬到一件工作上,就是派子任務、觸發 CI 之前先預留,做完照實際花費結算;「餘額夠才扣」要做成資料庫的一個原子操作,查和扣一起完成,例如 PostgreSQL 的條件更新。
這本帳最少要記這幾樣:
| 欄位 | 例子 | 少了會怎樣 |
|---|---|---|
| 工作編號、上限 | 這件修復,8 美元,模型和 CI 合計 | 沒有可以記帳的單位,只能看整個帳戶 |
| 已花費 | 模型 6.10、CI 0.90 | 接回時算不出剩多少,又給一份新的 |
| 預留 | 給子任務 A 的 2.50 | 兩個平行的子任務花到同一份錢 |
| 結算編號 | 每筆結算一個固定編號 | 結算通知送了兩次,就扣兩次 |
我會設兩條線。到提醒線,Harness 先在它管得到的地方收手:不再觸發新的整套測試,接回時在 prompt 裡寫明還剩多少。到上限就停止新的花費,把做到哪裡、跑過什麼、還沒解決的問題存下來,交給人決定要不要加額度。
最後,算一類工作值不值得交給 Agent,要拿所有工作的花費,成功的和失敗的加起來,除以成功的件數。只看成功那幾件,失敗的錢就從帳上消失了。
除了 cache 和少送一點,比較常見的還有兩種。
便宜的模型先上。 FrugalGPT 讓請求先給便宜的模型答,答得不夠好才往貴的送,論文裡最多省下 98% 的費用,表現跟最貴的那個差不多。RouteLLM 訓練一個分流器,決定每個請求給強的還是弱的模型,部分情況成本降到一半以下,回答品質不變。這兩篇是單次問答的實驗,搬到 Agent 上要自己量。Agent 裡比較直接的做法是讓 subagent 用便宜一點的模型:Anthropic 的研究系統主 Agent 用 Opus、subagent 用 Sonnet,在他們內部的評估上比單一個 Opus 好 90.2%。
失敗了別整段重跑。 整段重跑,整份 context 要再送一次、再付一次。Elastic 那篇也把 retry 列為帳單變大的原因之一。能從失敗的那一步接著做,就別從頭來。
假設你已經做到 Day 25:同一件工作不會被叫起來兩次。下一步是讓 Harness 看得到錢花在哪。
第一步,每次呼叫記下 API 回傳的用量,掛上是哪件工作。 沒走 cache 的輸入、從 cache 讀的、寫進 cache 的、模型產出,四個數字照價目表換成錢,加到這件工作上。有了這份紀錄,命中率、每件工作花多少、subagent 占多少,都算得出來;這篇裡每一個數字,都是從這樣一份紀錄算的。
模型產出這個數字要小心:串流的回應,開頭記下的 output token 只是回應剛開始時的數字,要等回應結束才準,Agent SDK 的成本追蹤文件也特別提醒。我第一次算這份帳只取了每則回應的第一筆紀錄,少算了快 40 美元;到現在還有兩千次左右的 subagent 呼叫只留下開頭的數字,照同類的呼叫估,實際再多 10 美元以內。
第二步,把命中率放進每一版 Eval 的報告,跟答對率並排。 命中率掉了,先找是哪個改動動到前綴,再決定能不能上線。上線之後也看實際的命中率,跟 Eval 量到的比,差很多,多半是使用的節奏跟 Eval 不一樣,回頭看 cache 留多久。
第三步,每件工作一本帳,上限記在帳上。 接回時只給剩下的;派子任務、觸發 CI 之前先預留,做完再結算。
自己一個人用、量不大的,我覺得做到第一步就夠了,至少知道錢花在哪。要給別人用、會一直改版的,第二步不能省。多台機器平行跑子任務、要跟財務對帳的,才需要第三步。
後面三篇,錢還是會一直出現:Agent 自己改 Harness 的時候,每改一輪都要重跑一次 Eval。
可以試著問自己兩題:改了一版 system prompt,Eval 的答對率一樣,命中率卻從 97% 掉到 60%,這版能上線嗎?Eval 量到的命中率是 97%,上線一週後只剩 80%,可能差在哪?
第一題先別上。每次送二十萬 token 的話,命中率 97% 時大部分是讀,60% 時有八萬 token 要重寫;照這套 Harness 的價格,寫一個 token 的錢夠讀四十次,輸入那塊的錢會變成原本的七、八倍。先找出是哪個改動動到前綴。第二題多半是節奏:Eval 一題接一題連著跑,cache 一直熱著;真的使用者會停下來,停得比 cache 留的時間久,就要整段重寫。先看實際兩次呼叫之間隔多久,再決定 cache 要不要留久一點。
Agent 的錢大多花在每一輪把整段對話再送一次,Prompt Cache 命中率決定這筆錢是 1 倍還是好幾倍,所以每一版 Eval,答對率旁邊第一個要看命中率。
明天先來一篇番外:一個人用 Agent 很單純,整間公司幾千人一起用的時候,該從哪一步開始。
cached_tokens,建議用 cached token 總數除以 input token 總數追蹤命中率。SKILL.md,更深的參考資料用到才讀。input_tokens、cache_read_input_tokens、cache_creation_input_tokens,可以拿來算命中率。task_budget 讓模型看到整個 agentic loop 剩多少 token,是建議值、可能超過;max_tokens 才是每次請求的硬上限。目前是 beta。max_turns 和 max_budget_usd 兩個上限,到了回 error_max_turns、error_max_budget_usd;建議正式上線的 Agent 預設設預算;花費在回應回來後才檢查,可能超過一輪回應加上還在跑的 subagent 的花費。max_budget,soft_budget 只提醒;budget reservation 預設開著,請求送出前先扣留估計的最高費用、回來後換成實際費用;沒設 budget_duration 就不重置;Agent 可以設 max_budget_per_session,用 trace id 串起同一個 session,超過回 429。total_cost_usd 是本機估計值;接回的 session 輸出含之前的花費,但 max_budget_usd 只算這次呼叫;assistant message 上的 output_tokens 是回應開始時的數字,完整的要從結果訊息讀。

 iThome鐵人賽
 看影片追技術