

Day24 四位俠客來到府裡,各自報上了名號。
今天老爺請四位到院子裡過過招:
舉左手的「左」,是誰的左邊?同樣看手,Hand、Gesture、Holistic 給的結果一樣嗎?手指比幾,哪一位俠客認得出來?家人一起入鏡,誰能看到每一個人?
哪一位俠客能最細心觀察出動作呢?
讓我們看看這場演武比試!
參數架構大致相同:
人數上限和三種門檻,差別在各自的額外輸出設定。
| 設定 | 在管什麼 | 什麼時候調整 | Hand、Gesture、Pose | Holistic |
|---|---|---|---|---|
| 人數上限 num_hands、num_poses | 最多找幾隻手、幾個人 | 家人一起入鏡 | 1 | 固定 1 人 |
① 找到的門檻 detection |
分數多少才算找到 | 常漏抓調低,常認錯調高 | 0.5 | 臉、身體各一個 |
② 確認的門檻 presence |
標特徵點時再確認一次 | 手一動就不見,試著調低 | 0.5 | 臉、身體、手各一個 |
③ 追蹤的門檻 tracking |
影片裡,下一格還是同一個嗎 | 點常跳掉,試著調低 | 0.5 | 沒有 |
| 執行模式 running_mode | 照片、影片、鏡頭畫面 | App 用鏡頭畫面 | 三種 | 三種 |
| 額外輸出 | 多給其他結果 | 用得到才打開 | Gesture 手勢分類、Pose 人形遮罩 | blendshape、人形遮罩 |
Gesture 的手勢分類:
可以設分數門檻、只認哪幾種(allowlist)、不認哪幾種(denylist);
只需要「讚」和「張開手掌」的話,用 allowlist 只留這兩種。
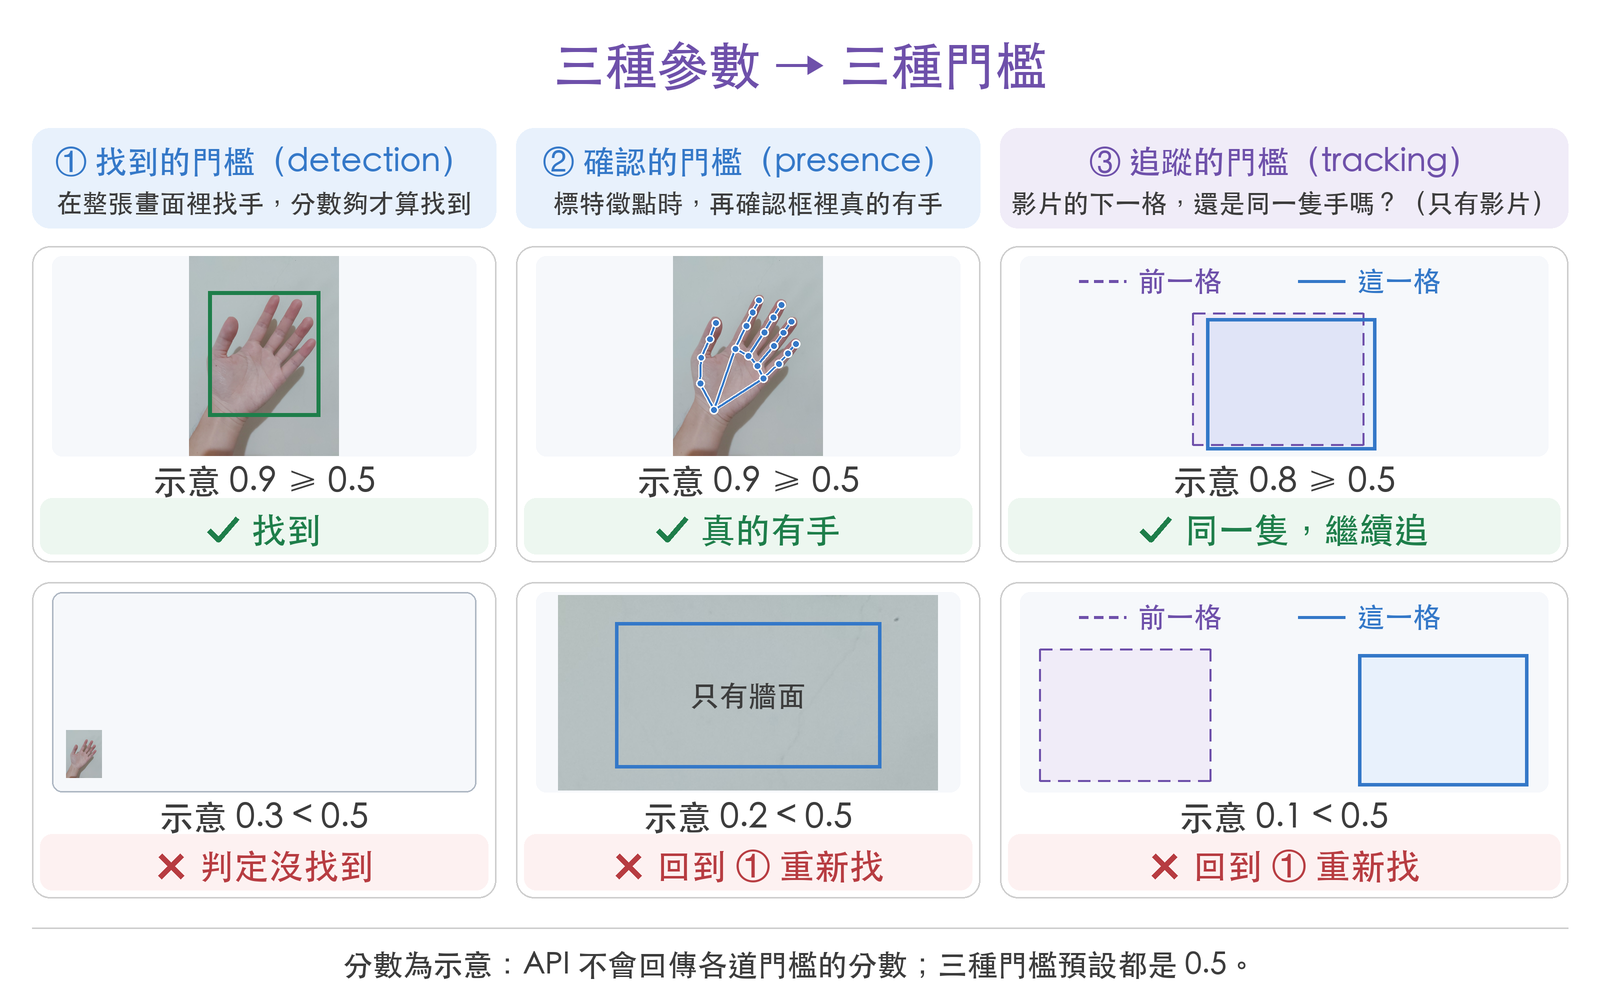
門檻是 0~1 的分數,分數高於門檻,模型才採用這個結果。
① 找到:整張畫面裡有沒有手?看的是信心分數(confidence score)。
② 確認:框起來的地方,真的是手嗎?也是信心分數。
③ 追蹤:下一格的手框,跟上一格重疊得夠不夠?夠才算同一隻手。
實際用 App 時,最常遇到的是手一放下、人往旁邊偏,手就跑出畫面。
這時候把門檻調低,能不能讓模型撐久一點?
拿手掌照片往畫面外平移,用 IMAGE 模式每張各跑一次,
把 ① 找到、② 確認的門檻從 0.1 調到 0.9,看手出框多少時找不到(Hand):
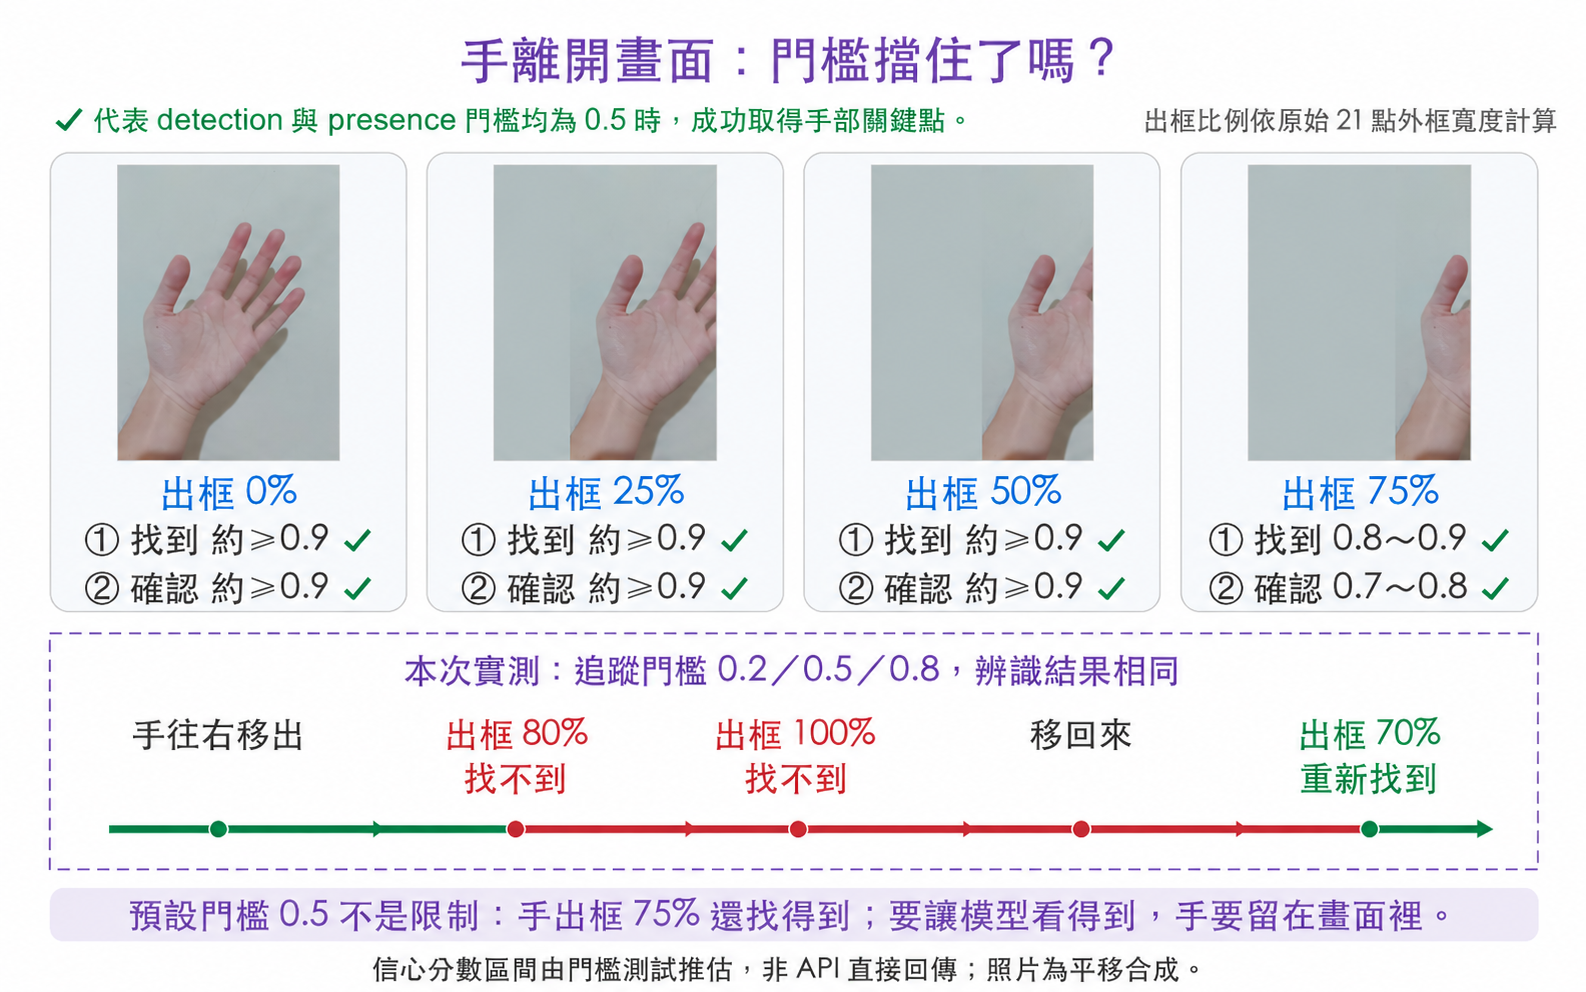
| 手出框 | ① 找到的門檻 | ② 確認的門檻 |
|---|---|---|
| 0%、25%、50% | 調到 0.9 都找得到 | 調到 0.9 都找得到 |
| 75% | 0.8 找得到、0.9 找不到 | 0.7 找得到、0.8 找不到 |
手出框 75%,分數都還有 0.7 以上,比預設的 0.5 高很多。
再用 VIDEO 模式,讓手慢慢移出去、再移回來:
出框 80% 時找不到,回程出框剩 70% 就重新找到;
③ 追蹤的門檻設 0.2、0.5、0.8,結果都一樣。
門檻不是瓶頸:手還在畫面裡,預設 0.5 就找得到;手出框太多,調門檻也救不回來。要讓模型看得到,手要留在畫面裡。
API 不會回傳各道門檻的分數,表中的區間是調門檻推出來的;
這次是一張照片平移合成的結果。
每個點都有兩組座標(Holistic 的臉只有 landmarks):
| landmarks | world landmarks | |
|---|---|---|
| x、y | 0~1,分別除以畫面的寬、高 | 公尺 |
| z | 相對深度,越小越靠近鏡頭 | 公尺 |
| 原點 | x、y 在畫面左上角;z 在手腕(Hand)、臀部中點(Pose) | 手的幾何中心(Hand)、臀部中點(Pose) |
| 適合拿來 | 把點畫在畫面上、看手在畫面哪裡 | 看手、身體本身的形狀 |
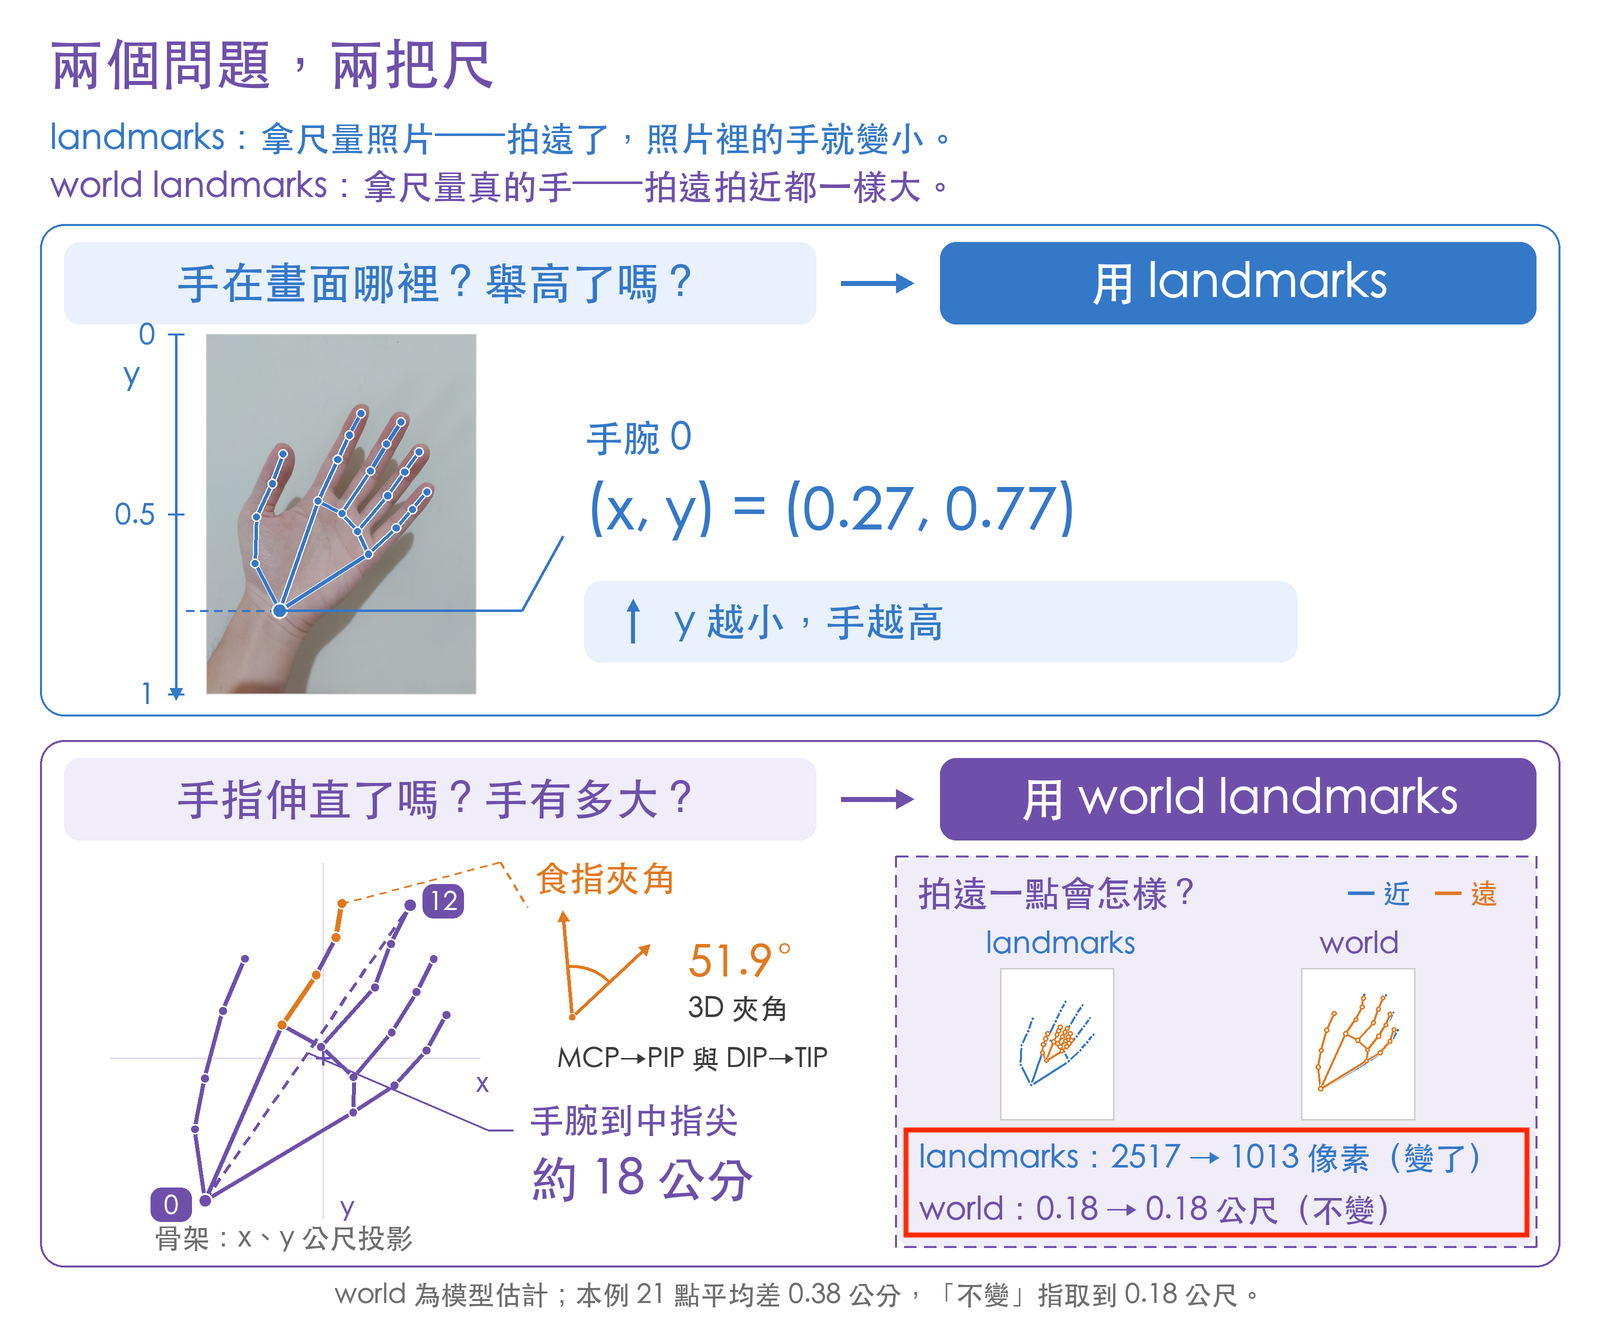
兩組座標,像兩把尺:
拿尺量照片:拍遠了,照片裡的手就變小。拿尺量真的手:拍遠拍近,手都一樣大。所以要回答的問題不同,用的座標也不同:
每偵測到一隻手,給三樣:
handedness(左手還是右手,和判斷的分數)、landmarks、world landmarks。
Android 呼叫 detect() 之後,這樣拿:
val result = handLandmarker.detect(mpImage)

// 第 1 隻手:左手或右手、分數
val handedness = result.handedness()[0][0]

// 21 個點,x、y 是 0~1
val landmarks = result.landmarks()[0]

// 21 個點,單位是公尺
val world = result.worldLandmarks()[0]
Day24 那張手掌照片(3024×4032),A70 實際拿到的結果:
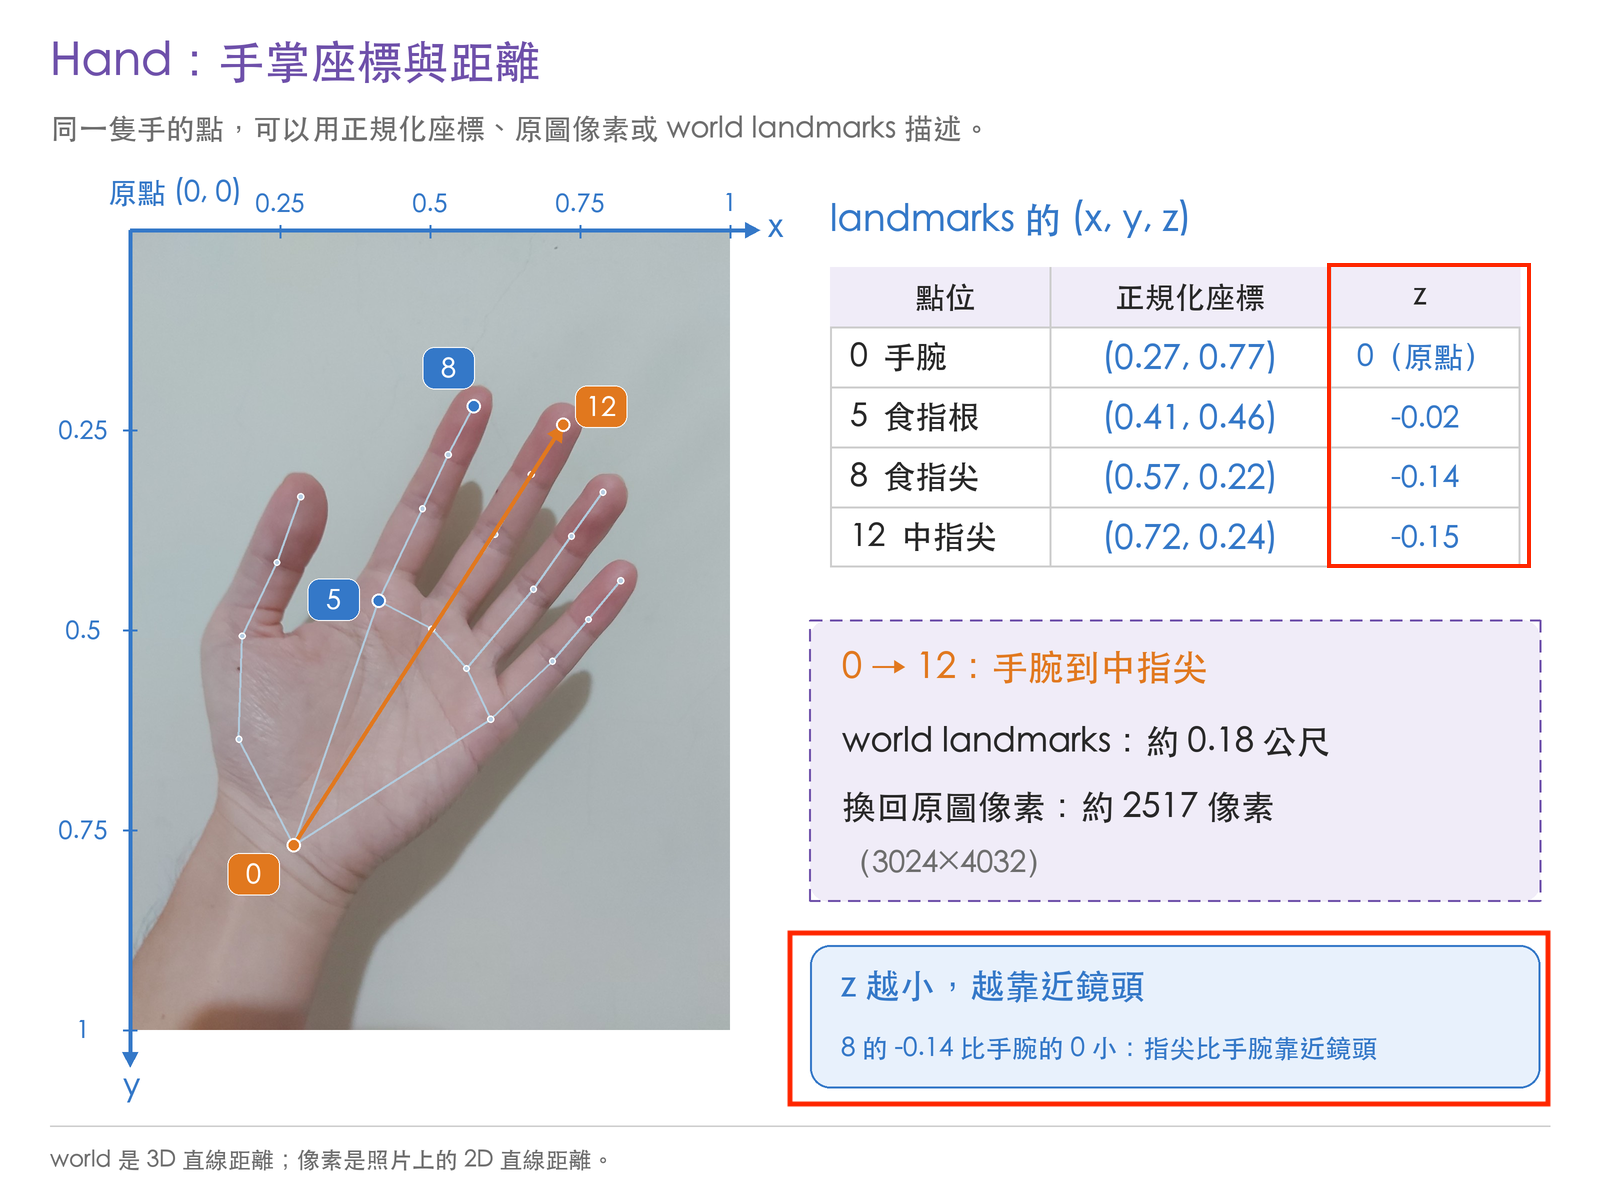
handedness、landmarks、world landmarks跟 Hand 一樣,
但多了 gestures(手勢和分數):
val result = gestureRecognizer.recognize(mpImage)

// 第 1 隻手的手勢:名稱、分數(例如 Thumb_Up、0.73)
val gesture = result.gestures()[0][0]
val name = gesture.categoryName()
val score = gesture.score()
| 值 | 意思 |
|---|---|
| x、y | 0~1,分別除以畫面的寬、高 |
| z | 以臀部中點為原點,越小越靠近鏡頭 |
| visibility | 在畫面裡,而且沒被擋住的機率 |
| presence | 在畫面裡的機率,不管有沒有被擋住 |
可以偵測好幾個人,所以結果是「每個人一組 33 點」:
val result = poseLandmarker.detect(mpImage)

// 第 1 個人的 33 個點:landmarks、world landmarks
val landmarks = result.landmarks()[0]
val world = result.worldLandmarks()[0]

// 15 是左手腕;visibility、presence 是 Optional,沒有值時是 null
val wrist = landmarks[15]
val visibility = wrist.visibility().orElse(null)
val presence = wrist.presence().orElse(null)
上半身那張照片(full 模型),實際拿到的結果(節錄):
lm 15 x=0.7792 y=0.2175 visibility=0.995 presence=0.981
lm 25 x=0.8353 y=0.9462 visibility=0.891 presence=0.559
lm 27 x=0.7369 y=1.0849 visibility=0.265 presence=0.215
Pose、Holistic 這兩段,在 Android 模擬器跑(tasks-vision 1.1.0);
跟電腦 Python 的結果比,四捨五入後最多差最後一位。
畫面外的腳,presence 只有 0.05~0.21:
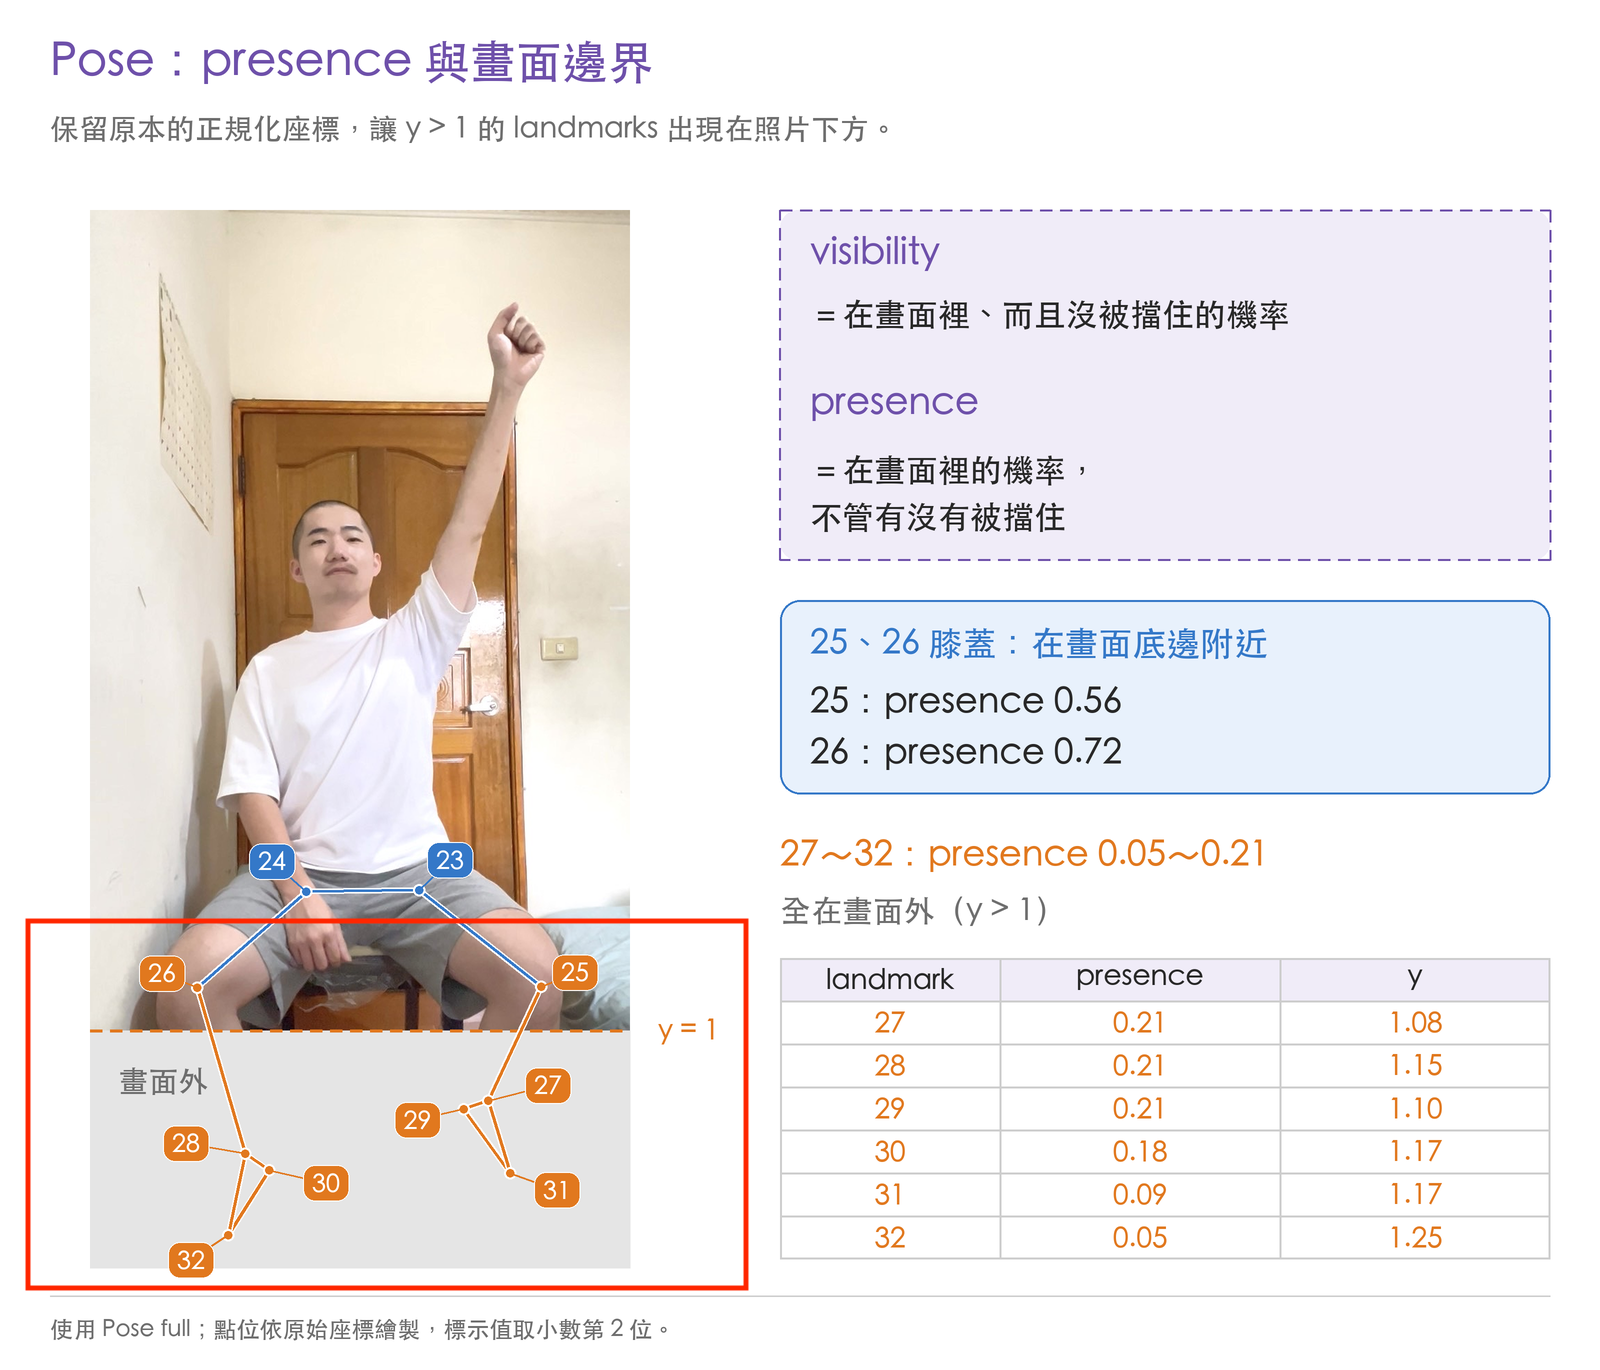
worldLandmarks 的原點是臀部中點;
坐在桌子後面、臀部看不到時,判斷動作先用 landmarks。
| 部位 | 點數 | landmarks | world landmarks |
|---|---|---|---|
| 臉 | 478 | 有 | 沒有 |
| 身體 | 33 | 有 | 有 |
| 左手 | 21 | 有 | 有 |
| 右手 | 21 | 有 | 有 |
臉的 52 個表情分數(blendshapes)、身體的遮罩,預設關閉,要用再打開。
Holistic 只看一個人,所以不用像 Pose 先取 [0]:
val result = holisticLandmarker.detect(mpImage)

// 臉 478 點,只有 landmarks
val face = result.faceLandmarks()

// 身體 33 點,跟 Pose 一樣有兩組座標
val pose = result.poseLandmarks()
val poseWorld = result.poseWorldLandmarks()

// 左手、右手各 21 點;沒找到時是空的 List,不是 null
val left = result.leftHandLandmarks()
val right = result.rightHandLandmarks()
if (left.isEmpty()) return
上半身那張照片,實際拿到的結果:
faceLandmarks        478 點
poseLandmarks         33 點  15 左手腕 x=0.7729 y=0.2174 visibility=0.978
leftHandLandmarks     21 點
rightHandLandmarks    21 點
Holistic 找手時,會參考身體的 15、17、19;
標 21 個特徵點用的是跟 Hand 同一個模型:
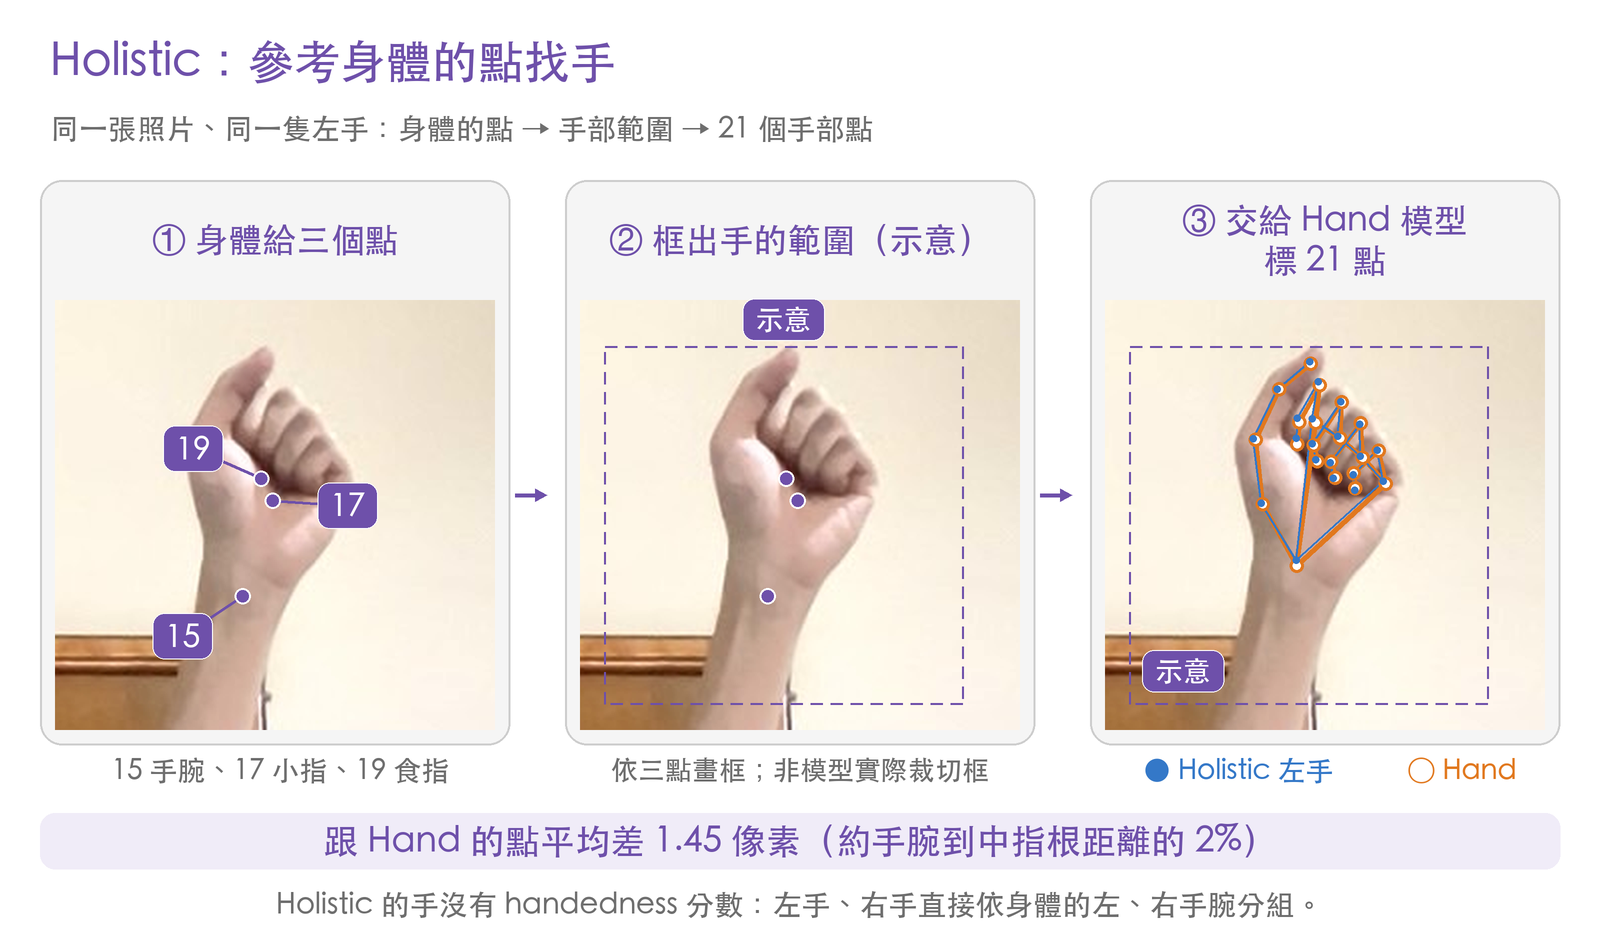
1. Android 請用 tasks-vision 1.1.0
同一張照片,分別用 1.0.0 和 1.1.0 跑:
| 1.0.0 | 1.1.0 | |
|---|---|---|
| 建立 Holistic | 閃退 | 正常 |
| 畫面裡沒有人,又打開額外輸出 | 閃退 | 正常,結果是空的 |
| 有人時的數值 | 一樣 | 一樣 |
建立就閃退,#6348 有人回報過;
第二列是照官方 Holistic 範例改了 protobuf 設定、能建立之後測的。
2026/10/07 剛發布的 v1.1.0,release notes 寫了這兩個問題已修正。
2. 手只有「有」或「沒有」
手的 21 個特徵點,本來就沒有 visibility、presence,Hand、Gesture 也一樣。
Hand、Gesture 的 handedness 分數,
是「左手還是右手」判斷得多確定,不是「有沒有手」。
Holistic 沒有 handedness,
要判斷有沒有手,就看左手、右手那兩組有沒有標記出特徵點。
這次測下來:
模型的左右,都是「畫面裡那個人自己的左右」(依身體結構分的左手、右手)。
送進模型的影格沒有鏡像 → Left 就是使用者本人的左手。
影格鏡像後 → 左右對調。
跟 Day11 Face Landmarker 的 *Left/*Right 是同一個規則。
上半身那張照片(後鏡頭、沒有鏡像,舉起的是我的左手),
原圖和左右翻轉各跑一次:
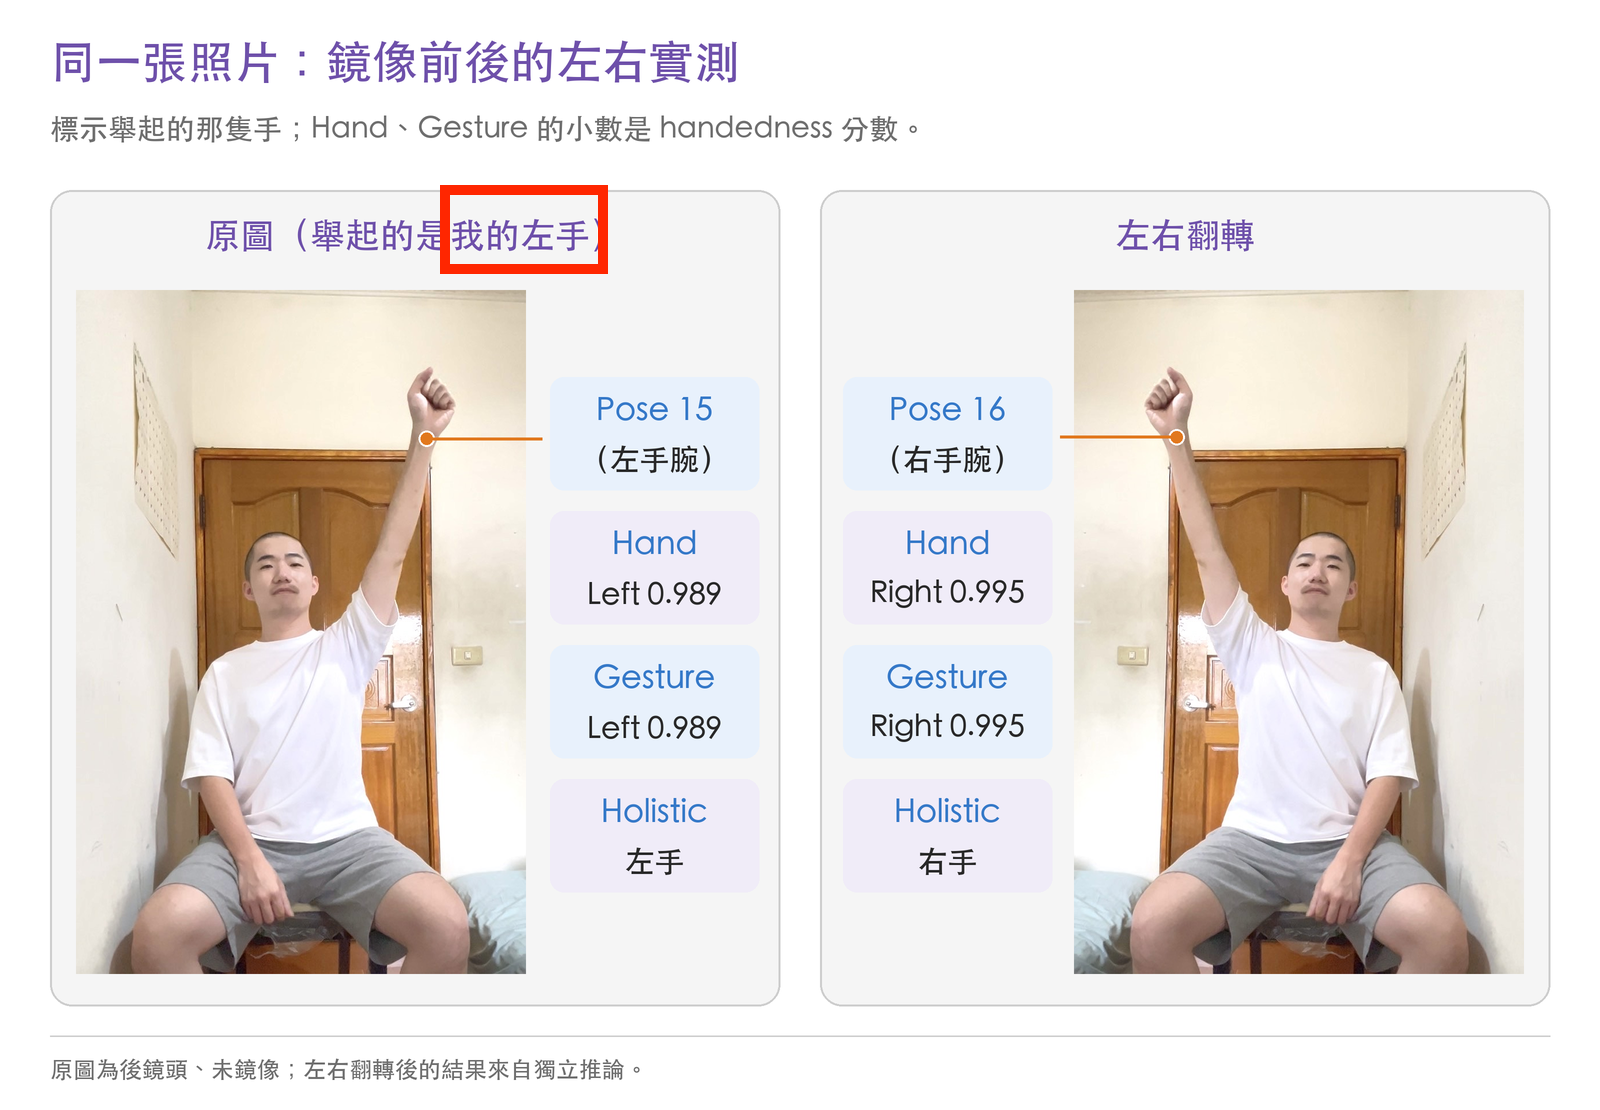
| 輸入 | Pose 舉起的手腕 | Hand | Gesture | Holistic |
|---|---|---|---|---|
| 原圖 | 15(左手腕) | Left 0.989 | Left 0.989 | 左手 |
| 左右翻轉 | 16(右手腕) | Right 0.995 | Right 0.995 | 右手 |
再用 A70 的前鏡頭,跑官方 Hand 範例(加了印出結果的版本),
每 0.5 秒記一筆左右手(只算有偵測到手的紀錄):
| 送進模型的影格 | 我舉左手 | 我舉右手 |
|---|---|---|
鏡像(官方範例的做法) |
Right 6/6 筆 |
Left 14/14 筆 |
不鏡像 |
Left 8/9 筆 |
Right 14/14 筆 |
不鏡像那組有 1 筆是 Right,那一筆的手腕在畫面底邊外。
官方的 Android 範例,相機的畫面送進模型之前,會先左右翻轉:
- Hand:用前鏡頭時翻轉,
註解寫「flip image if user use front camera」。- Gesture:相機的每一格都翻轉,
註解寫「flip image since we only support front camera」。
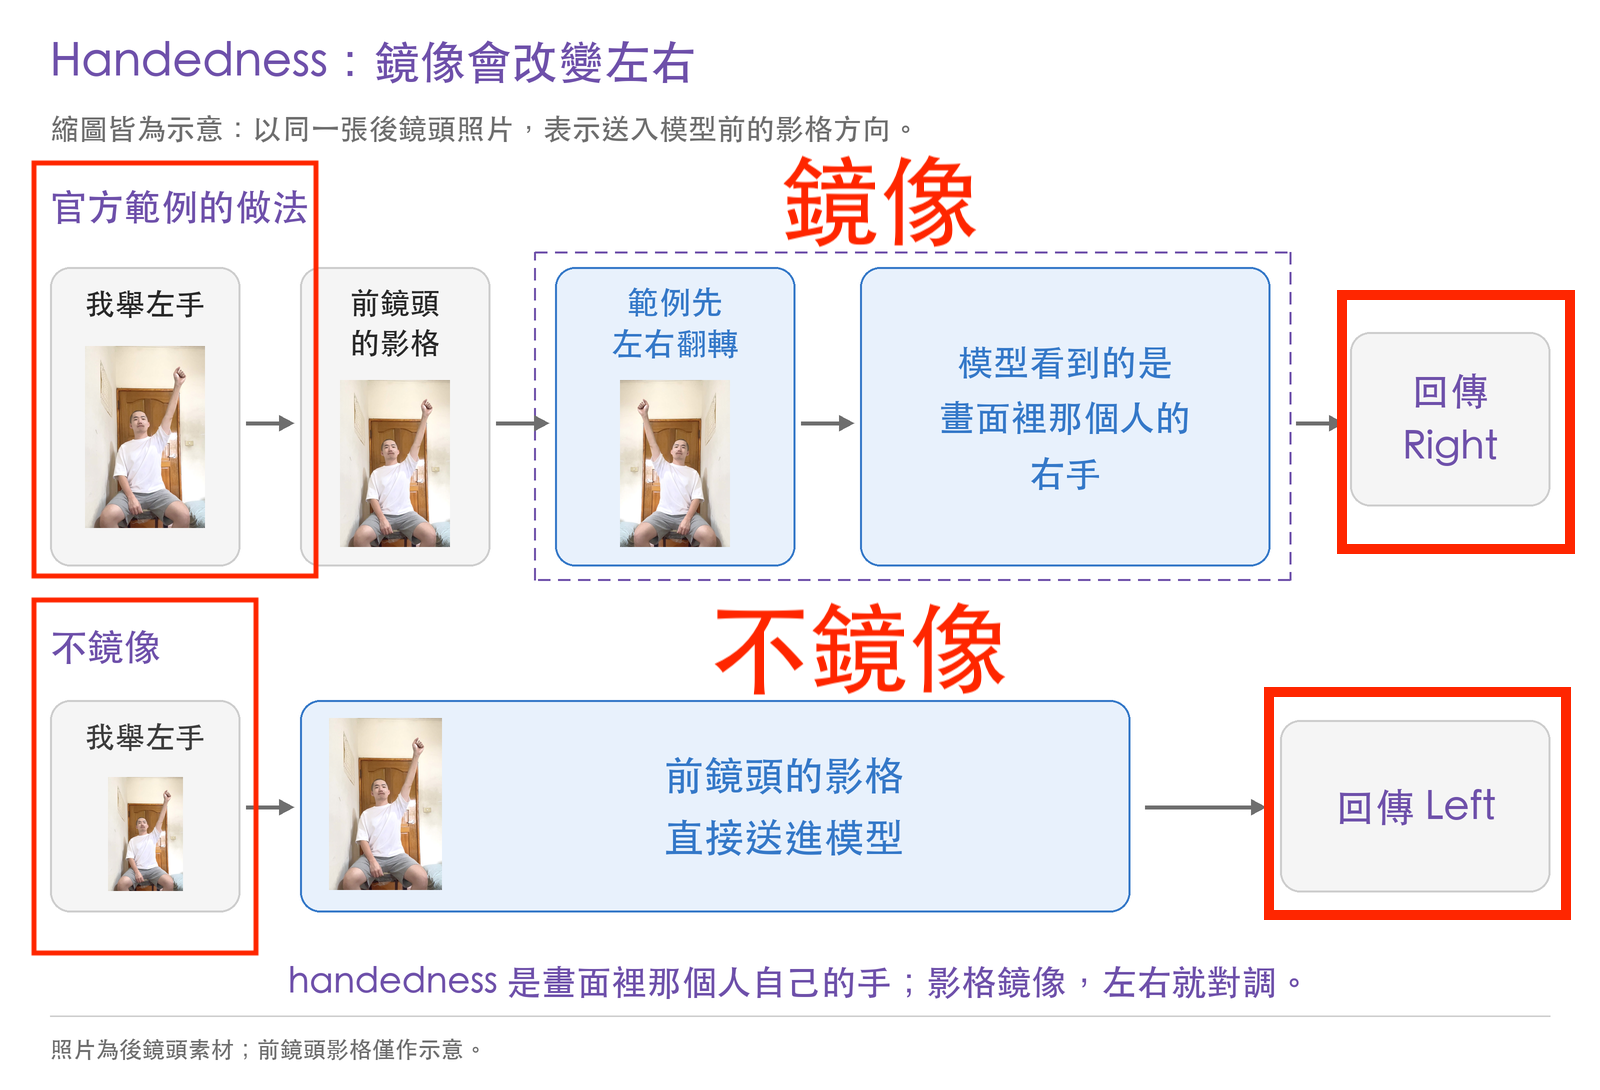
兩個範例的畫面都不顯示左右手,範例本身沒有問題;從範例開始、自己加上左右手判斷時,拿到的會跟使用者本人相反。
Hand、Gesture 指南只寫了
「Handedness represents whether the detected hands are left or right hands.」
沒有說左右以誰為準,也沒有說鏡像會不會讓左右對調。
Day11 提的 #6368,官方已經採納,
在 Face Landmarker 指南的總覽和各平台頁補上了說明。
這次也嘗試提 Documentation issue:建議在指南加一句:handedness 指的是畫面裡那個人自己的手;鏡像輸入會讓左右對調。
並附上重現腳本、原圖與翻轉的結果,以及 A70 鏡像、不鏡像的對照。
Issue 連結:#6376
Hand、Gesture、Holistic 都會給每隻手 21 個點。
同一張照片給三位看,結果並排:
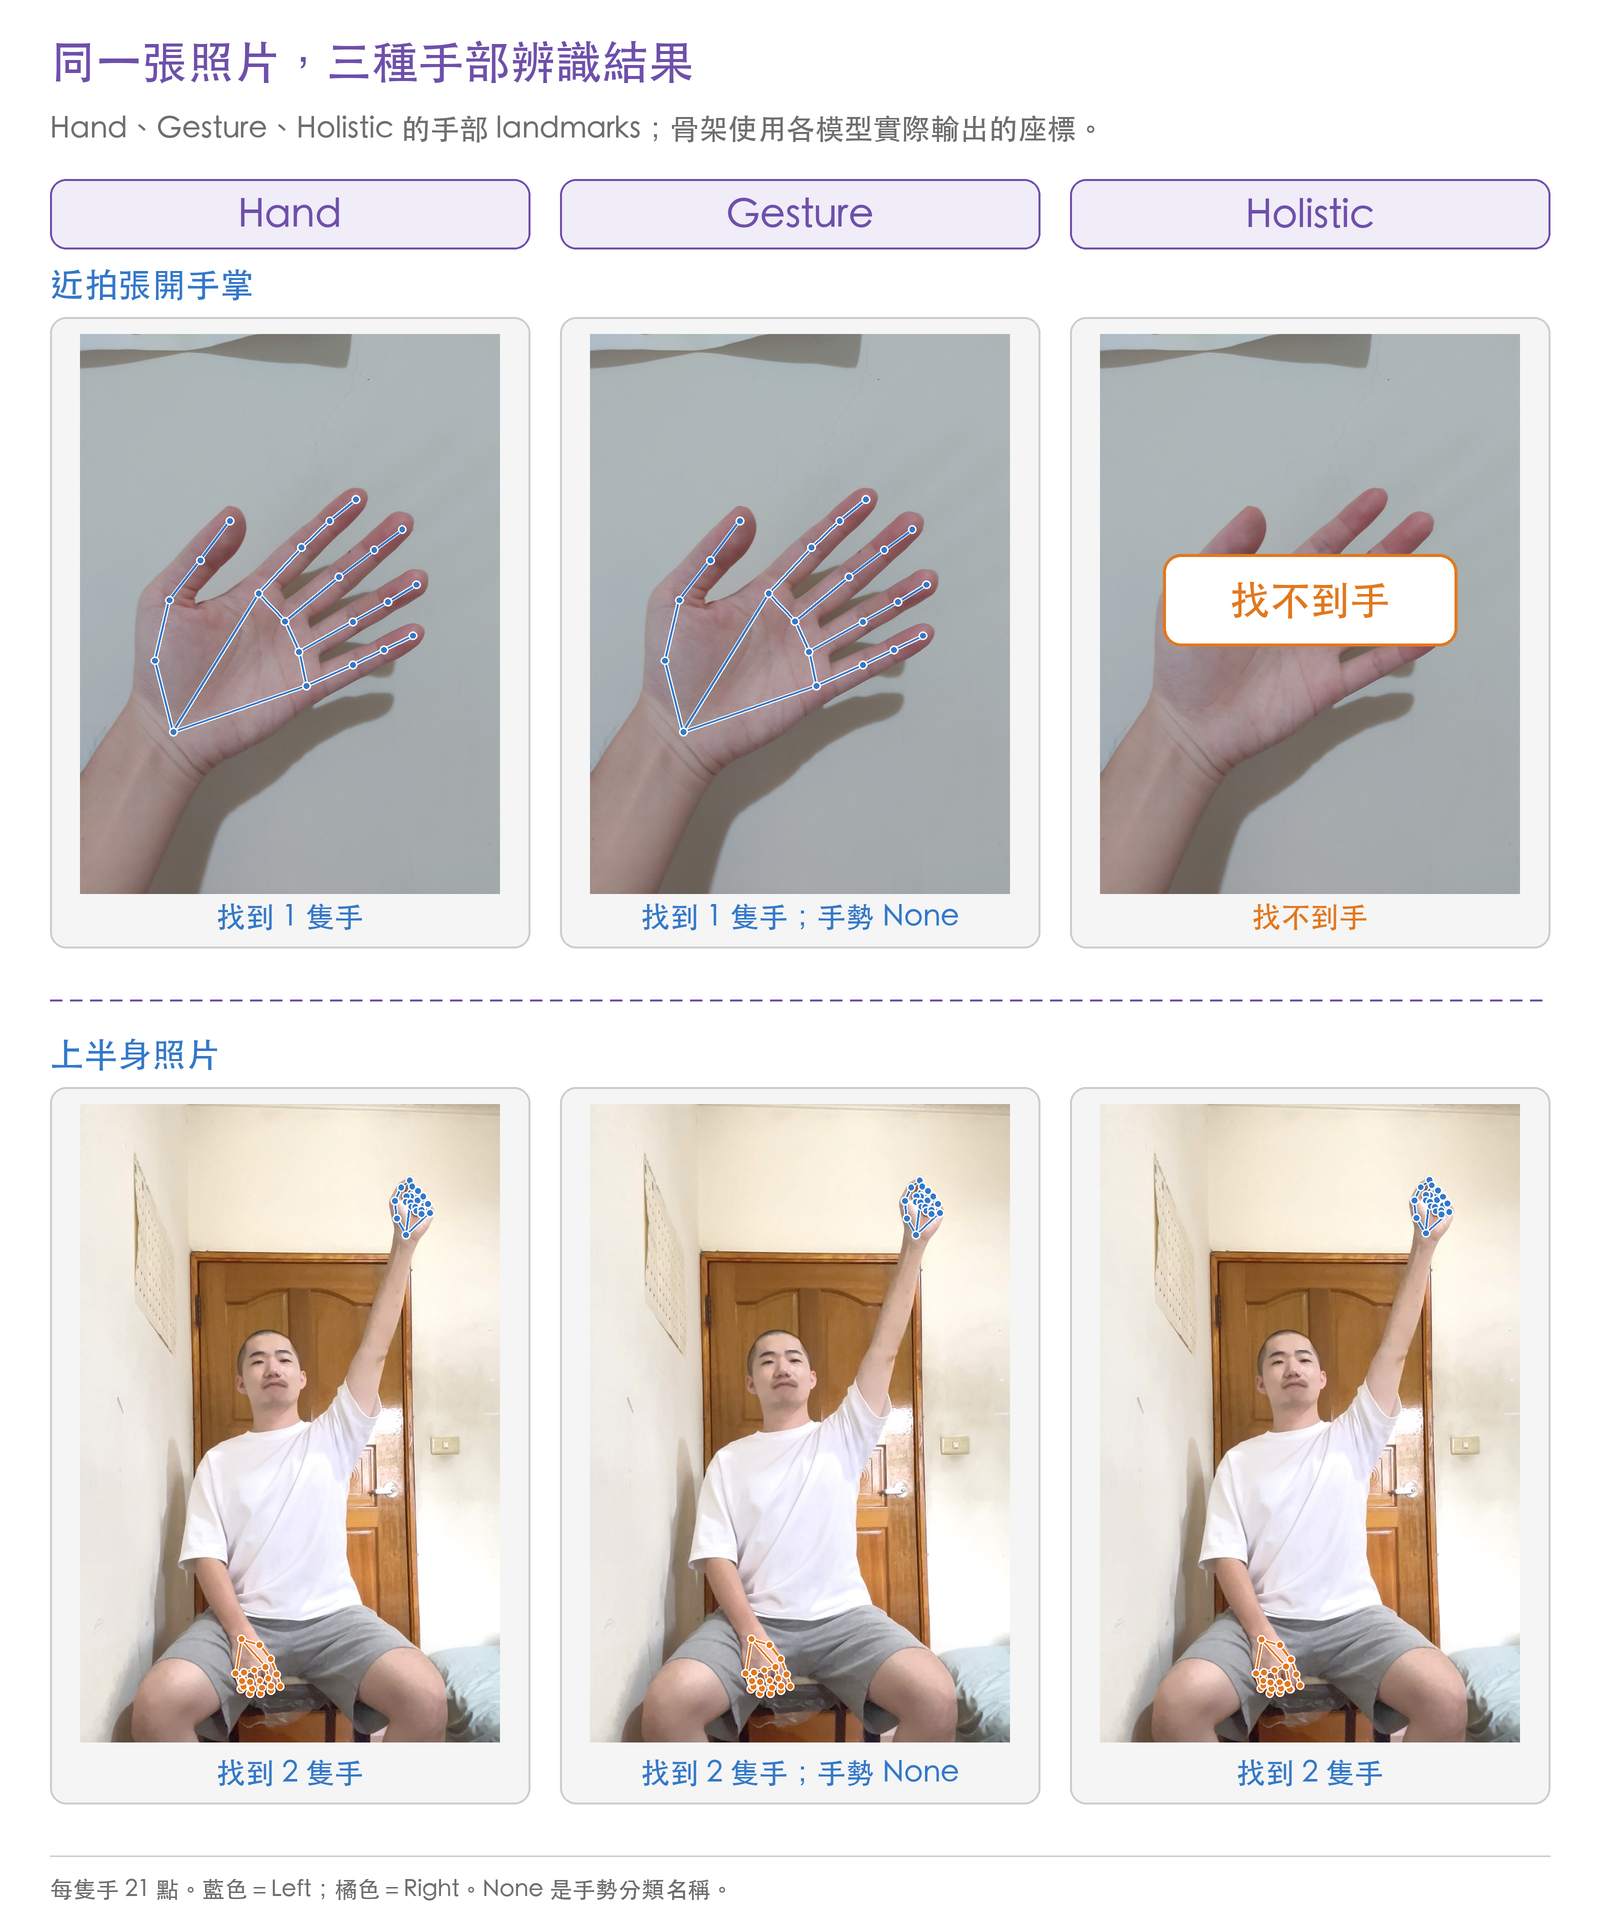
| 照片 | Hand | Gesture | Holistic |
|---|---|---|---|
| 近拍:張開手掌(2 張) | 找到 | 找到,手勢 None | 找不到 |
| 近拍:比讚(3 張) | 找到 | 找到,手勢 Thumb_Up | 找不到 |
| 上半身:舉左手 | 找到 2 隻 | 找到 2 隻,手勢 None | 找到 2 隻 |
7 隻手的 21 個點(landmarks、world landmarks)、左右手、分數,
兩位給的數值相同,差距是 0。
Day24 提過,Gesture 的手部特徵點模型跟 Hand 是同一套;
只要點,用 Hand;要手勢名稱,用 Gesture,點會一起給。
近拍的 5 張,Holistic 一隻手都沒找到。
Holistic 找手時會參考身體的點(Day24);
這次近拍只有手,看不到身體,Holistic 就找不到手。
Day24 留了一題:影片中途才遮住手腕,Holistic 還找得到嗎?
拿上半身那張照片,遮住舉起那隻手的手腕,比三種情況:
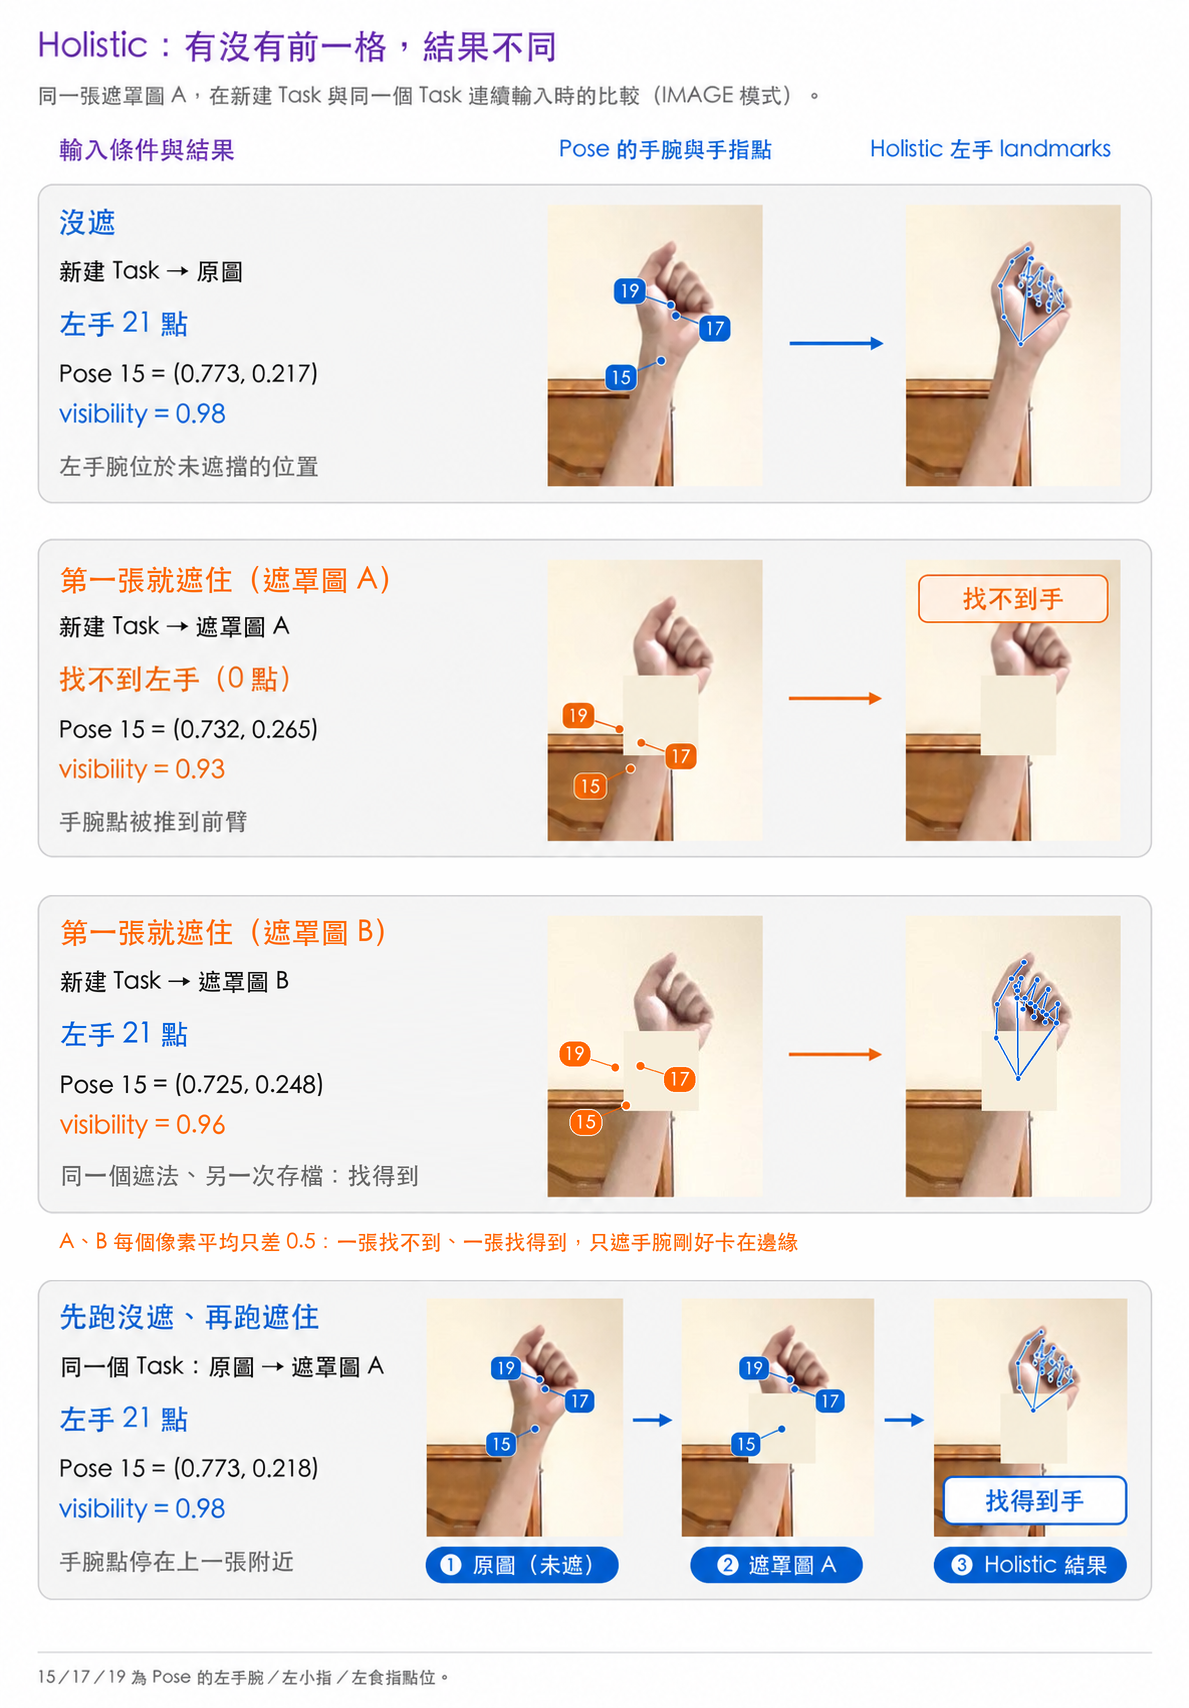
| 情況 | 遮罩圖 A | 遮罩圖 B |
|---|---|---|
| 第一張就遮住(新建 Task) | 找不到 | 找到 21 點 |
| 先跑沒遮的,再跑遮住的(同一個 Task,IMAGE) | 找到 21 點 | 找到 21 點 |
| VIDEO 模式:先送沒遮的,再送遮住的 | 找到 21 點 | 找到 21 點 |
遮罩圖 A、B 是同一個遮法,遮住的位置也相同,只是分兩次存成 JPEG,
存檔雜訊讓每個像素平均差 0.5。
中途才遮住:
A、B 都找得到,身體的手腕點(Pose 15)停在上一張的位置(0.773, 0.218);
新建 Task 時,這個點則被推到前臂(約 0.73, 0.26)。看起來 Holistic 會沿用上一格,IMAGE 模式用同一個 Task 時也一樣。
第一張就遮住:
A 找不到、B 找得到。
我把「確認有手的門檻」從 0.1 調到 0.9 各跑一次:差別不在門檻:A 降到 0.1 還是找不到,B 拉到 0.9 還找得到。
看起來是存檔的些微雜訊,讓 Pose 猜的手腕位置不同
(A 在 0.732, 0.265、B 在 0.725, 0.248),
Holistic 框出來的手部範圍跟著不同,結果就一個找不到、一個找得到。
Day24 提過,Pose 每隻手只有 3 個指根關節的點,
看不出哪根手指伸直,所以數不了手指。
Gesture 的 7 種手勢裡沒有數字。
我比 1~5、握拳各拍一張(手指朝上、掌心朝鏡頭),用 A70 跑官方 Gesture 範例:
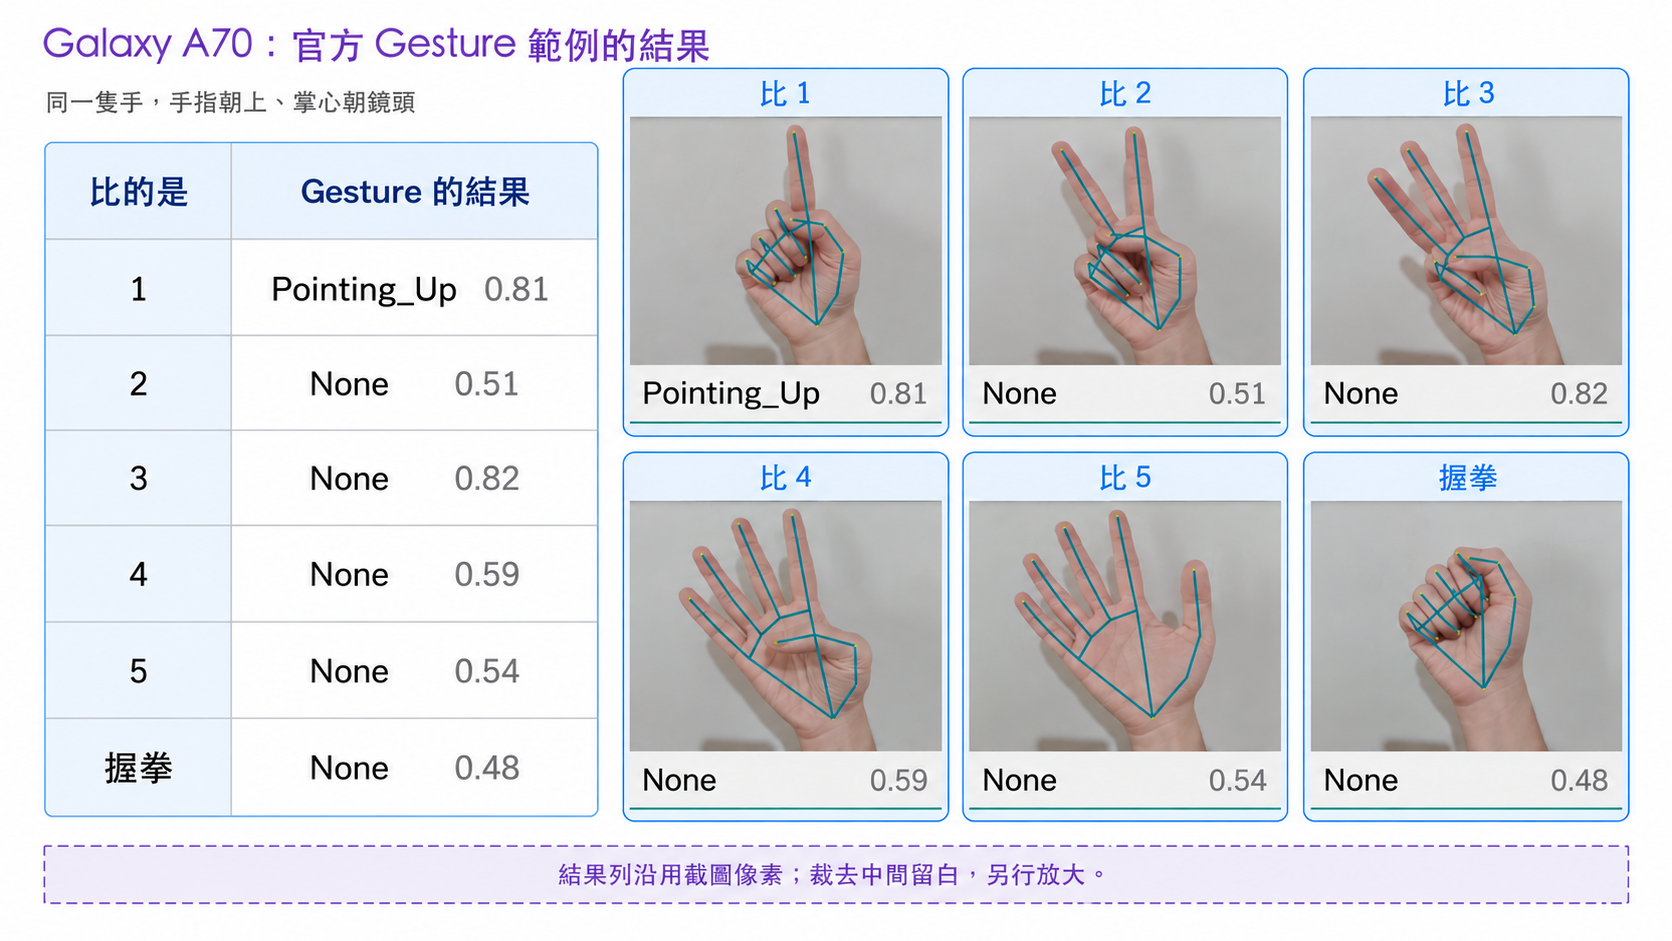
6 張裡,只有比 1 認成 Pointing_Up;比 2、張開手掌、握拳都回 None。
把 Day24 那張張開手掌的照片轉幾個角度再跑:
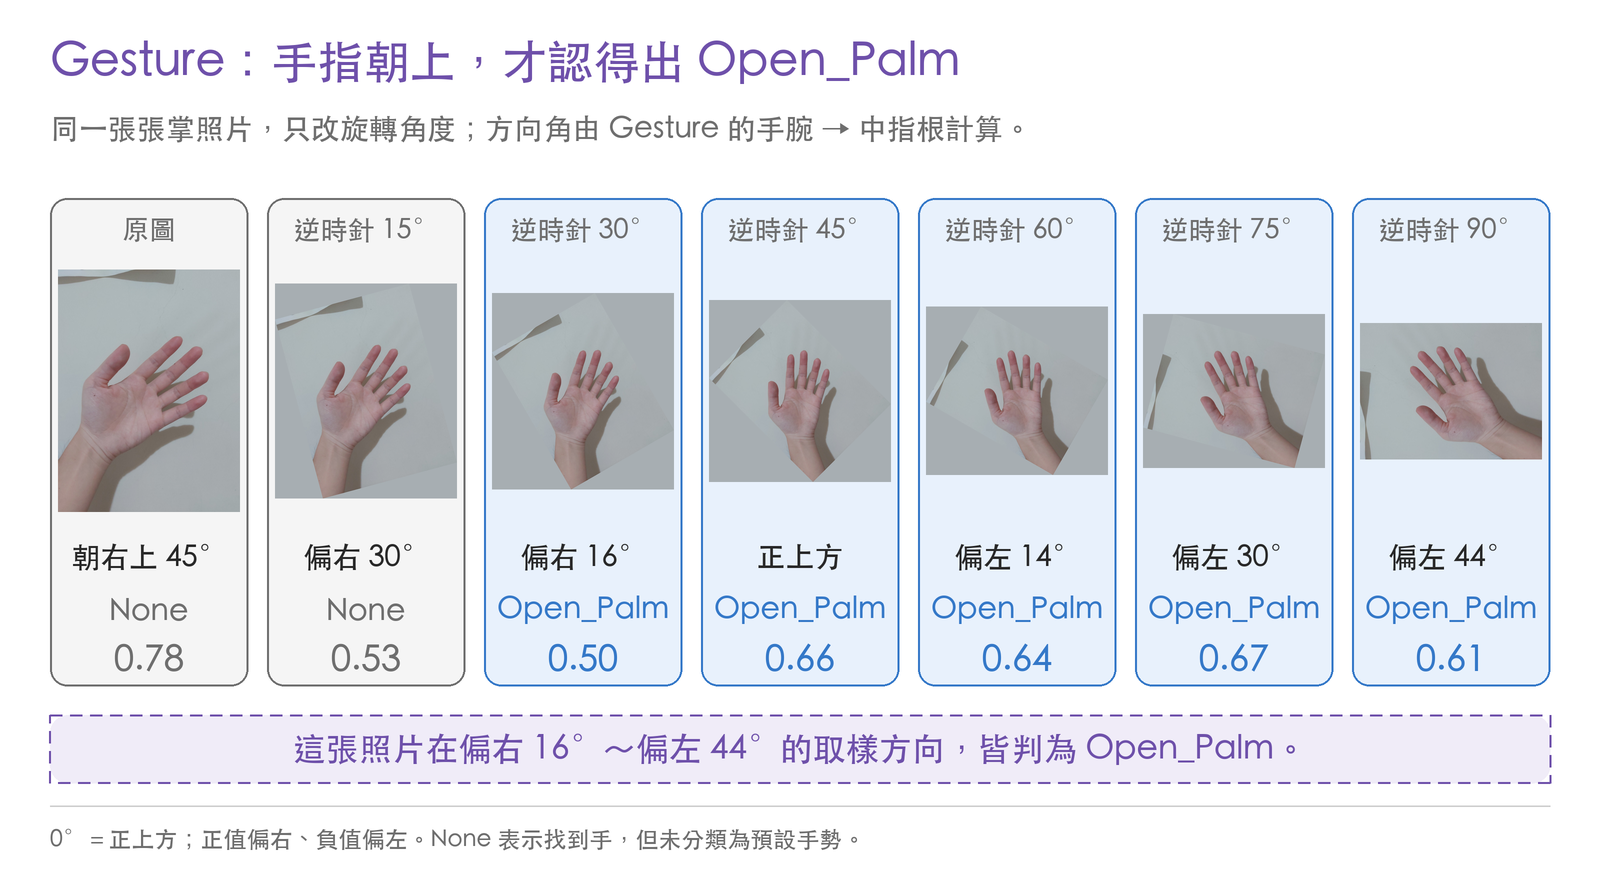
13 個角度裡,Open_Palm 有 5 個,都在手指朝上附近(偏右 16° 到偏左 44°);
原圖朝右上 45°、偏右 30°,都是 None。同一張照片左右翻轉後,認得出來的角度也不同;
比讚也一樣,13 個角度裡有 6 個認得出 Thumb_Up。每個角度 Hand 都找到了手,
None 是「認不出手勢」,不是沒找到手。
手的方向可能會影響結果;
但上面那張手指朝上的張開手掌,還是回 None。用 Gesture 的手勢,要先拿自己要用的手勢實測。
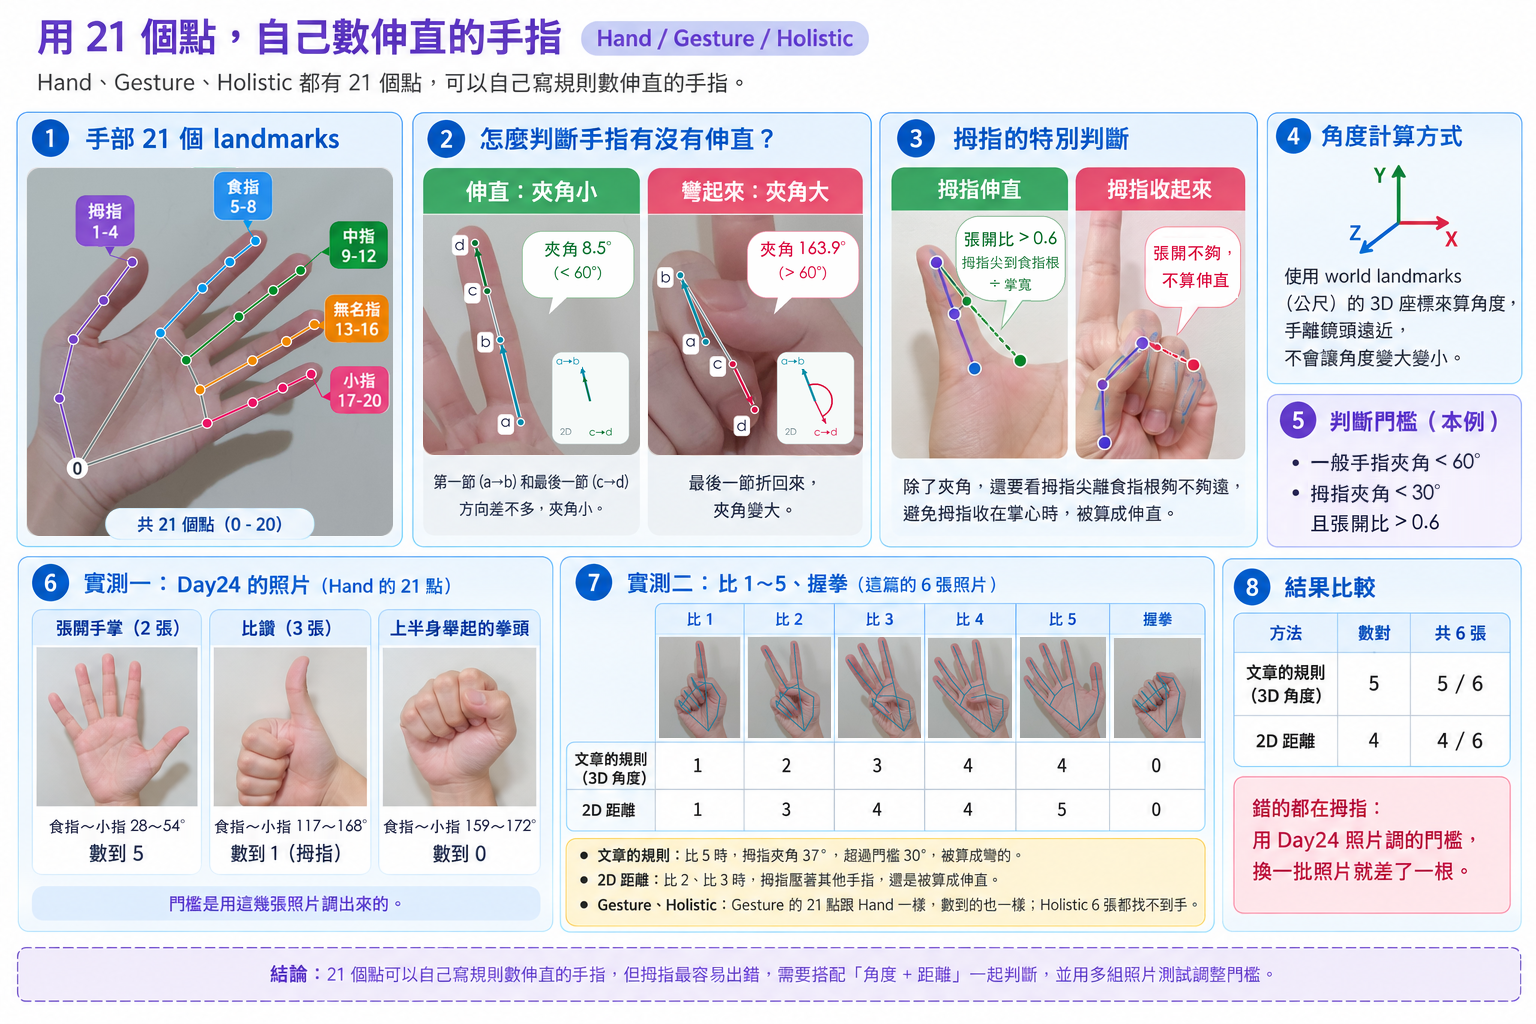
Hand、Gesture、Holistic 都有 21 個點,可以自己寫規則數伸直的手指。做法是看每根手指「第一節」和「最後一節」的方向:
角度用 world landmarks(公尺)的 3D 座標算,手離鏡頭遠近,不會讓角度變大變小。
import numpy as np

# 伸直的門檻:手指 60 度、拇指 30 度、拇指張開比 0.6
FINGER, THUMB, SPREAD = 60, 30, 0.6

# 每根手指的 4 個點:根部 → 指尖
JOINTS = [(1, 2, 3, 4), (5, 6, 7, 8), (9, 10, 11, 12),
          (13, 14, 15, 16), (17, 18, 19, 20)]

def angle(u, v):
    cos = np.dot(u, v) / (np.linalg.norm(u) * np.linalg.norm(v))
    return np.degrees(np.arccos(np.clip(cos, -1, 1)))

# world:一隻手的 21 個 world landmarks,形狀 (21, 3)
def count_fingers(world):
    p = np.asarray(world)
    # 拇指尖到食指根的距離,除以手掌寬(食指根到小指根)
    spread = (np.linalg.norm(p[4] - p[5])
              / np.linalg.norm(p[5] - p[17]))
    count = 0
    for i, (a, b, c, d) in enumerate(JOINTS):
        # 第一節(a→b)和最後一節(c→d)的夾角
        bend = angle(p[b] - p[a], p[d] - p[c])
        if i == 0:
            straight = bend < THUMB and spread > SPREAD
        else:
            straight = bend < FINGER
        count += int(straight)
    return count
家人陪長輩一起做時,畫面裡會有兩、三個人。
我只有一個人,所以把上半身那張照片複製並排,合成兩人、三人的畫面。
| 設定 | 兩人 | 三人 |
|---|---|---|
| Pose,num_poses=1 | 抓到 1 人 | 抓到 1 人 |
| Pose,num_poses=人數 | 都抓到 | 都抓到 |
| Hand、Gesture,num_hands=2 | 只抓到兩人舉起的手 | 0 隻 |
| Hand、Gesture,num_hands=人數×2 | 4 隻都抓到,左右正確 | 0 隻 |
| Holistic | 抓 1 人 | 抓 1 人 |
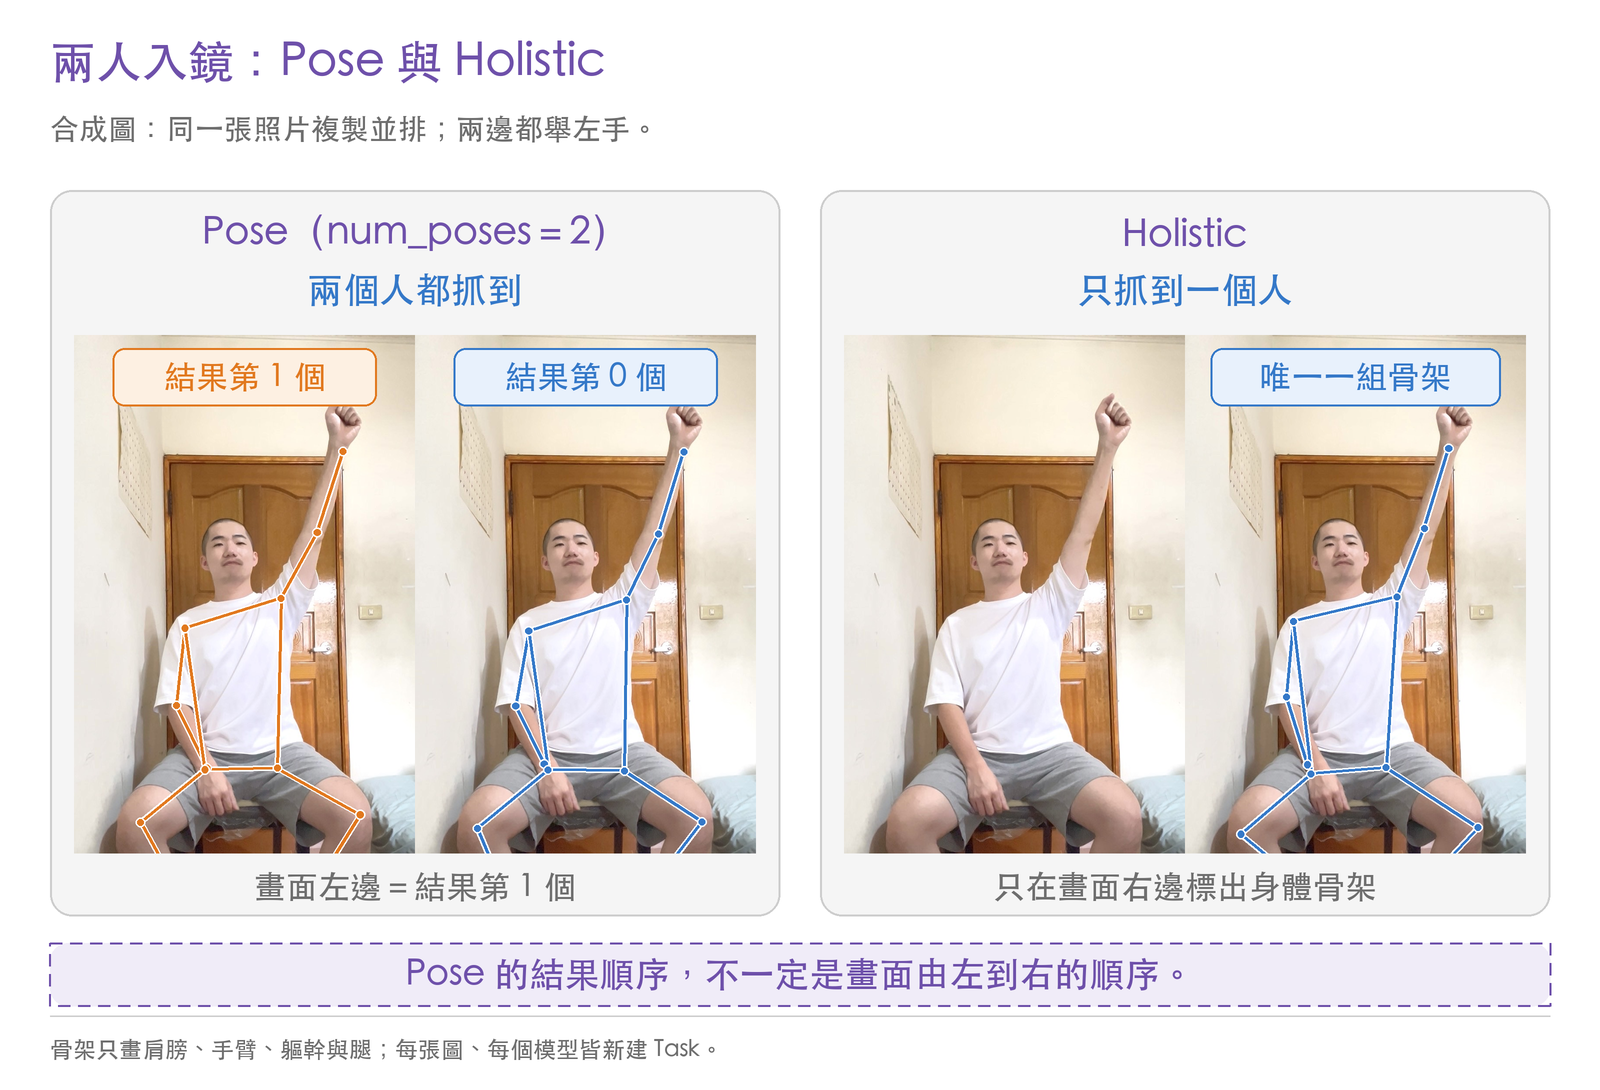
結果的順序不是照畫面左右排:第 3、1、2 個人,要自己依位置排序。最多只抓 1 個人;三人時抓過最右邊,也抓過中間那位。第 2 個人左右翻轉、變成舉右手時,兩個人舉起的拳頭剛好靠在一起;
Pose 給的兩個手腕點,都往兩人中間偏。
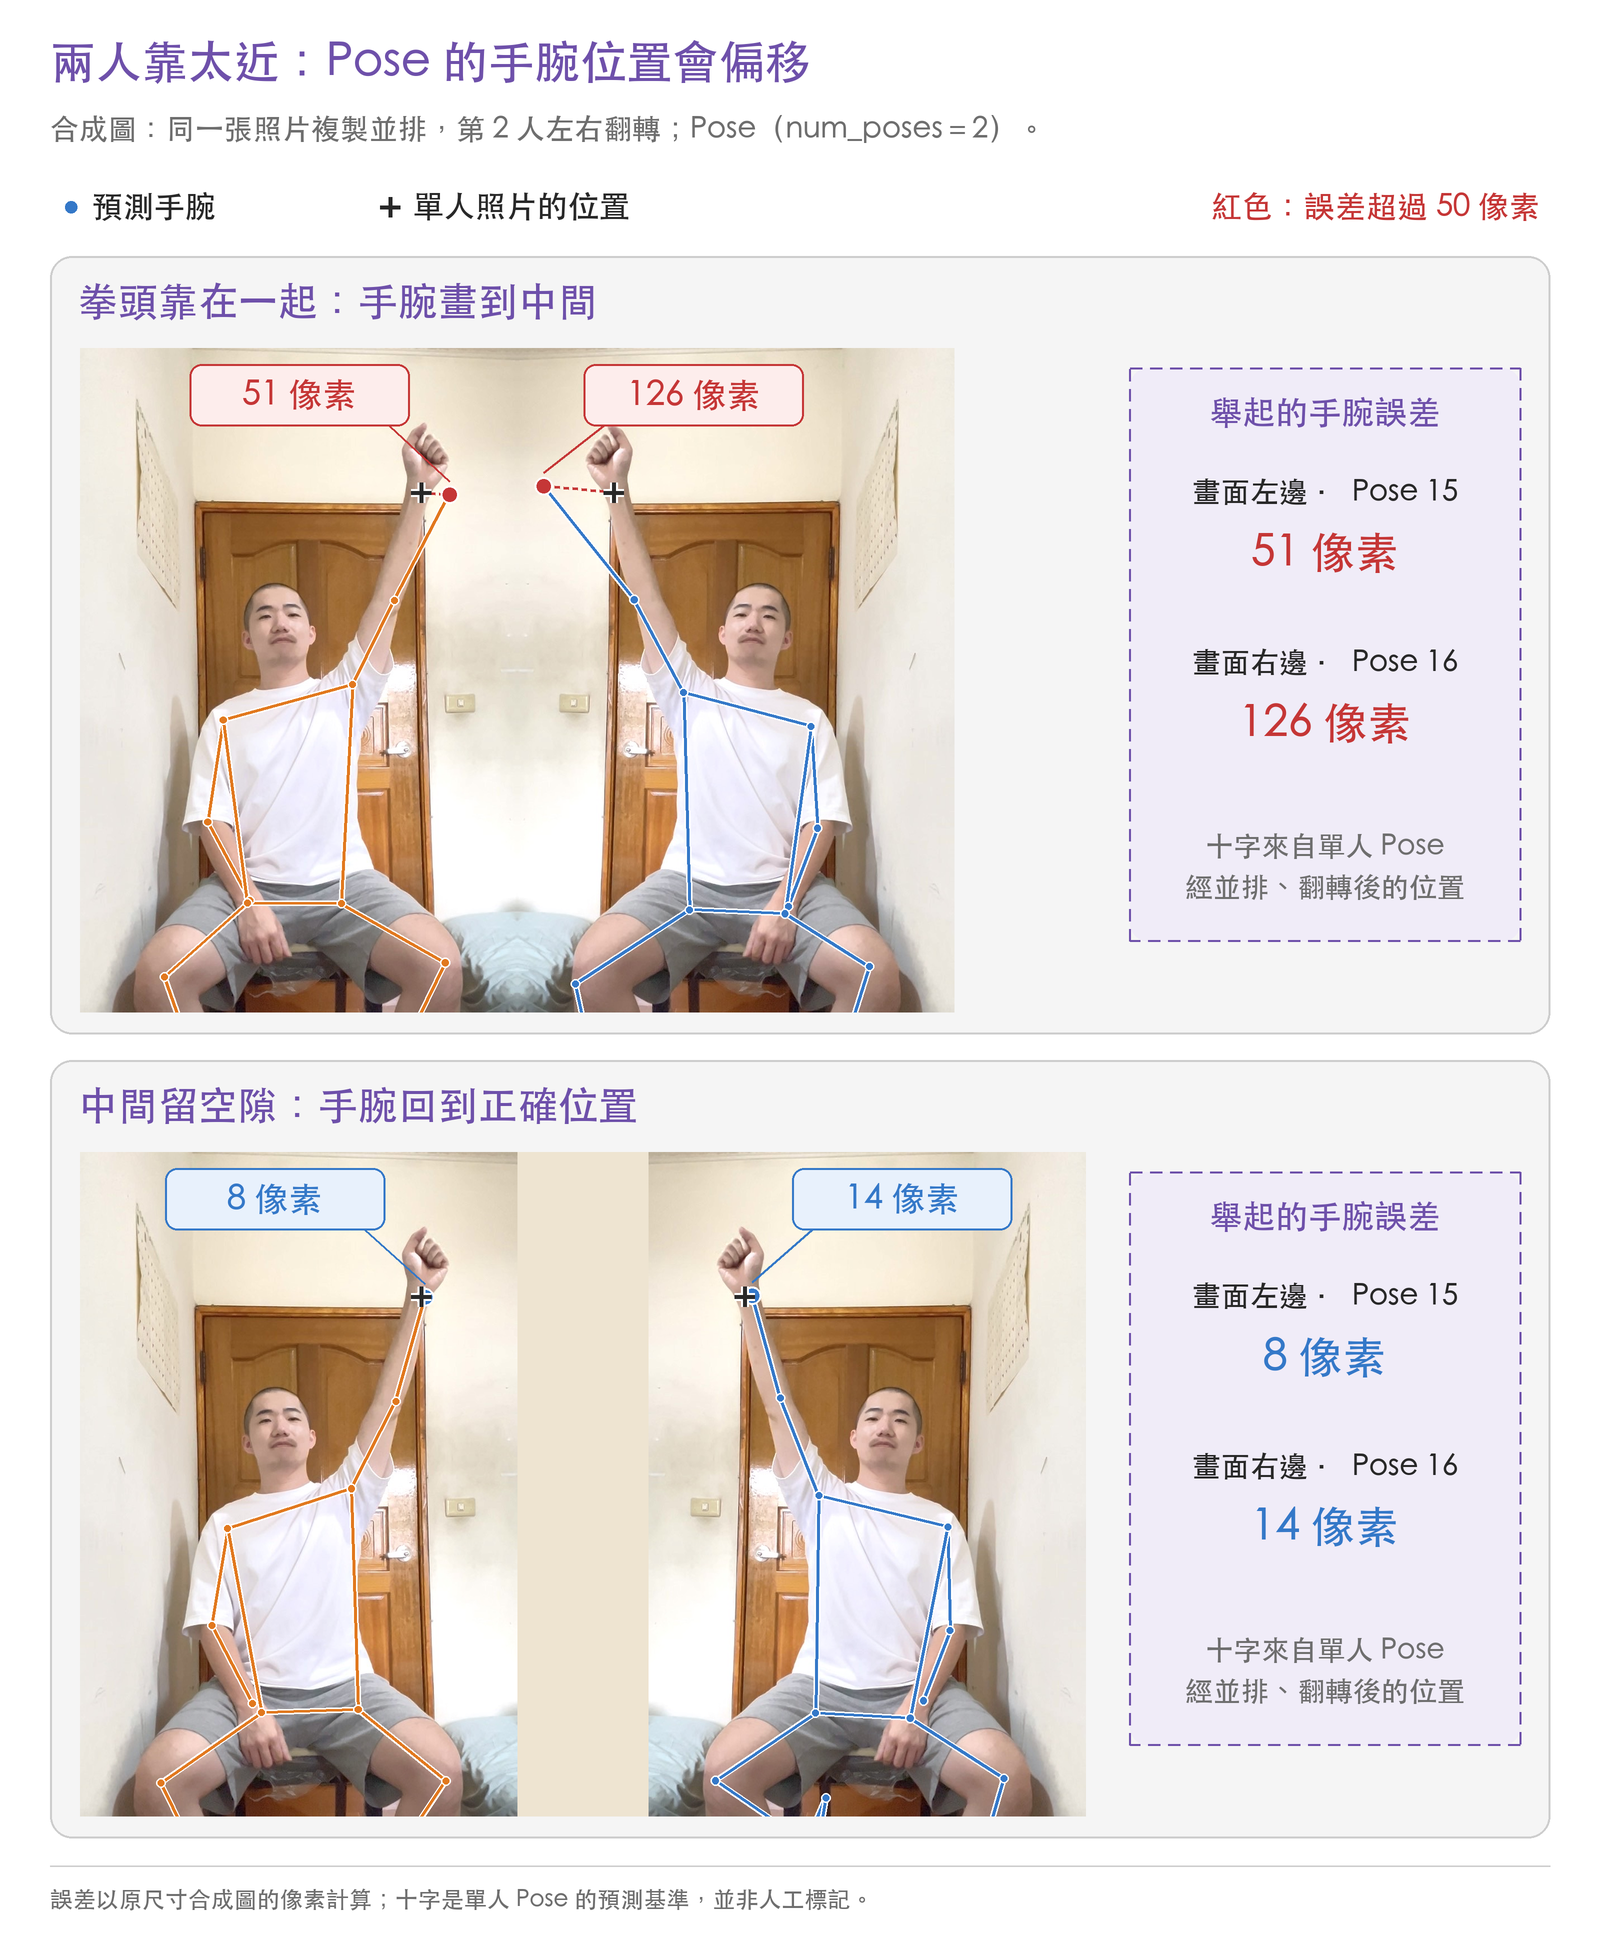
| 兩人合成 | 舉起的手腕,跟單人照片的位置差 |
|---|---|
| 拳頭靠在一起 | 51、126 像素 |
| 中間留空隙 | 8、14 像素 |
| 兩人都舉左手(拳頭分開) | 12、12 像素 |
三人並排的畫面寬 2343 像素,Hand、Gesture 一隻手都沒找到;
把每個人左右多餘的背景裁掉(寬 1407 像素),就找到 5 隻手。
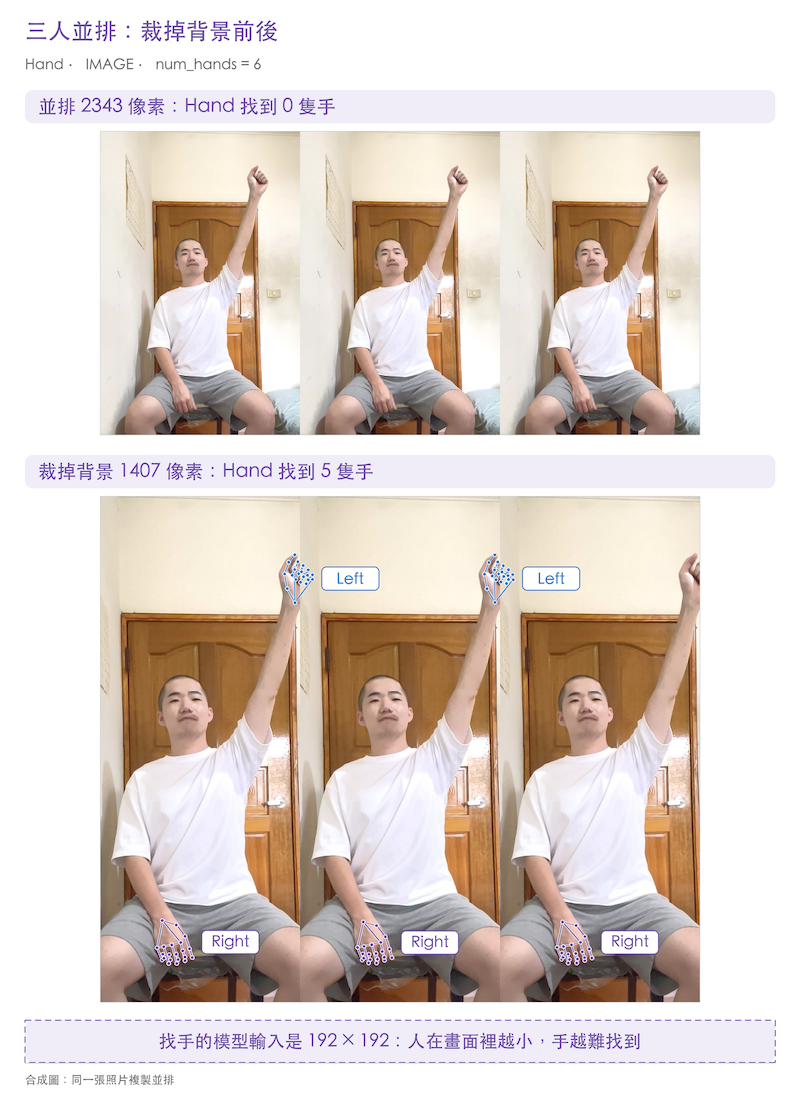
手部模型說明:找手的模型,輸入是 192 x 192。
整張畫面縮成 192 x 192,手在模型看到的畫面裡也跟著縮小,
看起來是手在整張畫面裡只占一小塊,縮小後就找不到了。
家人一起入鏡:彼此坐開一點,每個人在畫面裡要夠大。
要看的東西不同,適合的俠客也不同。
明天,請俠客進府:
把 Pose 放進健口動一動,帶長輩「暖身動一動」和「跟著音樂動一動」!
模型的輸出如何變成「舉左手」「拍手」?家人和長輩一起做,App 怎麼判定誰沒跟上動作?
讓我們明天繼續看下去~
感謝有緣看到這邊的你~
希望佛菩薩也祝福你:🌟幸福平安 健康順遂🌟
南無觀世音菩薩🍀 南無地藏菩薩🏠 南無阿彌陀佛☀️


 iThome鐵人賽
 看影片追技術