
到昨天為止,GPU 的 Triton 和 CPU 的 C++ 兩條 codegen 都走完,整條產線看似完工。但有個問題一直沒問,同一個 op 常常不只一種生法,生哪一種才最快。編譯器用紙筆推不出來,答案跟 shape、dtype、GPU 型號全都有關,唯一可靠的辦法是每一種都真的跑一次,讓碼表說話。今天就來看 Inductor 的 autotune 機制,以及把它火力全開的 mode="max-autotune",順便看看這張門票錢花在哪裡、值不值得。
正文開始!
拿 matmul 當主角。同一顆 matmul,Inductor 手上有兩種生法。
哪一種快沒有公式。tile 切大了裝不進 shared memory,切小了吃不滿算力,平衡點跟 shape、dtype 和 GPU 的硬體規格全部糾纏在一起,換一個條件就換一個結局。所以 Inductor 在 lowering aten.mm 時不直接生 kernel,而是先開一張候選名單。cuBLAS 包成 extern 候選放進去,再從預先寫好的 config 清單逐一往模板填參數,一個 config 一個候選,實測有 19 條,還會依 shape 篩掉沒意義的組合。名單開好,交給 AlgorithmSelectorCache 裁決,這場實測就是 autotune。
不過預設模式下這場比賽根本不會開打。模板不進場,Triton 候選全體缺席,名單上只剩 cuBLAS 一個人,只有一個候選就直接回傳,計時都省了。實驗在 Modal 的 L40S 上跑(torch 2.8.0,完整程式在 code/day23/),拿 2048x2048x2048 的 fp16 matmul 編一次,產物很乾脆。
[default] compile time: 1.0 s
    extern_kernels.mm(...)
這就是預設模式的哲學,matmul 交給 cuBLAS 準沒錯,編譯快,效能也不差。
torch.compile(f, mode="max-autotune") 只是一組設定的別名,實際打開的開關可以直接印出來。
max-autotune options: {'max_autotune': True, 'triton.cudagraphs': True, 'coordinate_descent_tuning': True}
三個開關各有分工。
同一顆 matmul recompile 一次,log 裡多了一張計分表(節錄)。
AUTOTUNE mm(2048x2048, 2048x2048)
strides: [2048, 1], [2048, 1]
dtypes: torch.float16, torch.float16
  mm 0.0848 ms 100.0%
  triton_mm_16 0.0870 ms 97.4% ACC_TYPE='tl.float32', ALLOW_TF32=False, BLOCK_K=32, BLOCK_M=128, BLOCK_N=128, EVEN_K=True, GROUP_M=8, USE_FAST_ACCUM=False, num_stages=3, num_warps=4
  triton_mm_17 0.0932 ms 91.0% ACC_TYPE='tl.float32', ALLOW_TF32=False, BLOCK_K=64, BLOCK_M=128, BLOCK_N=128, EVEN_K=True, GROUP_M=8, USE_FAST_ACCUM=False, num_stages=3, num_warps=4
  triton_mm_9 0.1004 ms 84.5% ACC_TYPE='tl.float32', ALLOW_TF32=False, BLOCK_K=32, BLOCK_M=64, BLOCK_N=128, EVEN_K=True, GROUP_M=8, USE_FAST_ACCUM=False, num_stages=3, num_warps=4
SingleProcess AUTOTUNE benchmarking takes 0.7160 seconds and 2.7616 seconds precompiling for 20 choices
每一列是一個候選,後面是實測的毫秒數和相對冠軍的百分比。20 個候選先各自編譯成真的 kernel,再拿一批同 shape、同 stride 的隨機 tensor 逐一計時,取最快的定案。表頭印出 strides 和 dtypes 不是裝飾,這場比賽的答案只對這一組條件成立。同一份模板只是參數不同,成績就差出三成。
比賽中還有人當場出局。
OutOfMemoryError: out of resource: triton_mm Required: 131072 Hardware limit:101376 Reducing block sizes or `num_stages` may help..
Ignoring this choice.
有些 config 要求的 shared memory 超過 L40S 的上限,這種候選直接被踢出名單,比賽照常進行。跑不起來的方案自己淘汰,也是實測的好處。
結局有點反高潮,冠軍是 mm 本人,cuBLAS 贏了,生成的程式碼跟預設模式一樣是 extern_kernels.mm,三方 benchmark 也印證了這件事。
eager           0.0697 ms
default         0.0699 ms
max-autotune    0.0700 ms
方正的 2048 fp16 matmul 是 cuBLAS 的主場,這結果合理。autotune 不是 Triton 必勝的儀式,它是實測,意思是 cuBLAS 該贏的時候就讓它贏,花掉的編譯時間買到的是一句「確認過了」。
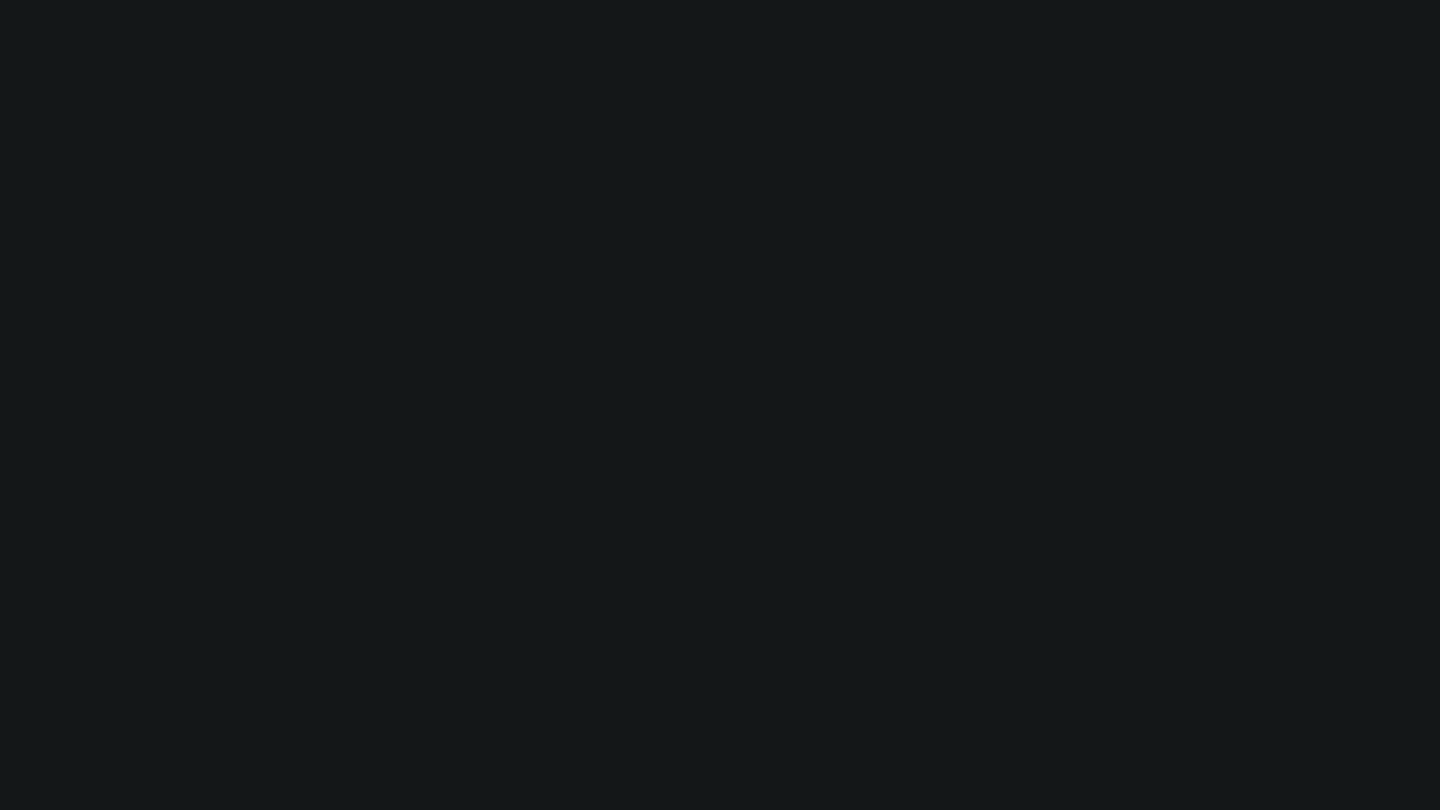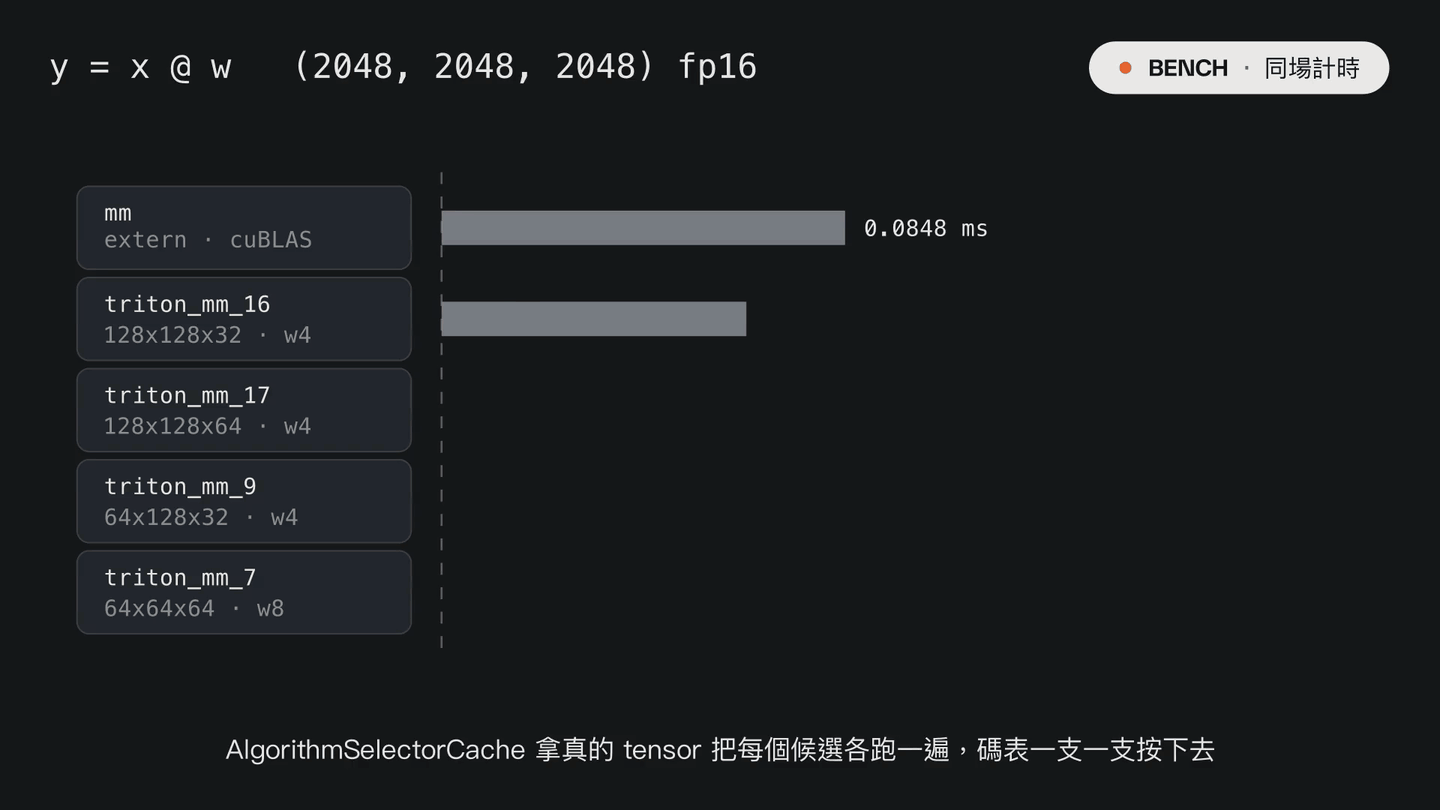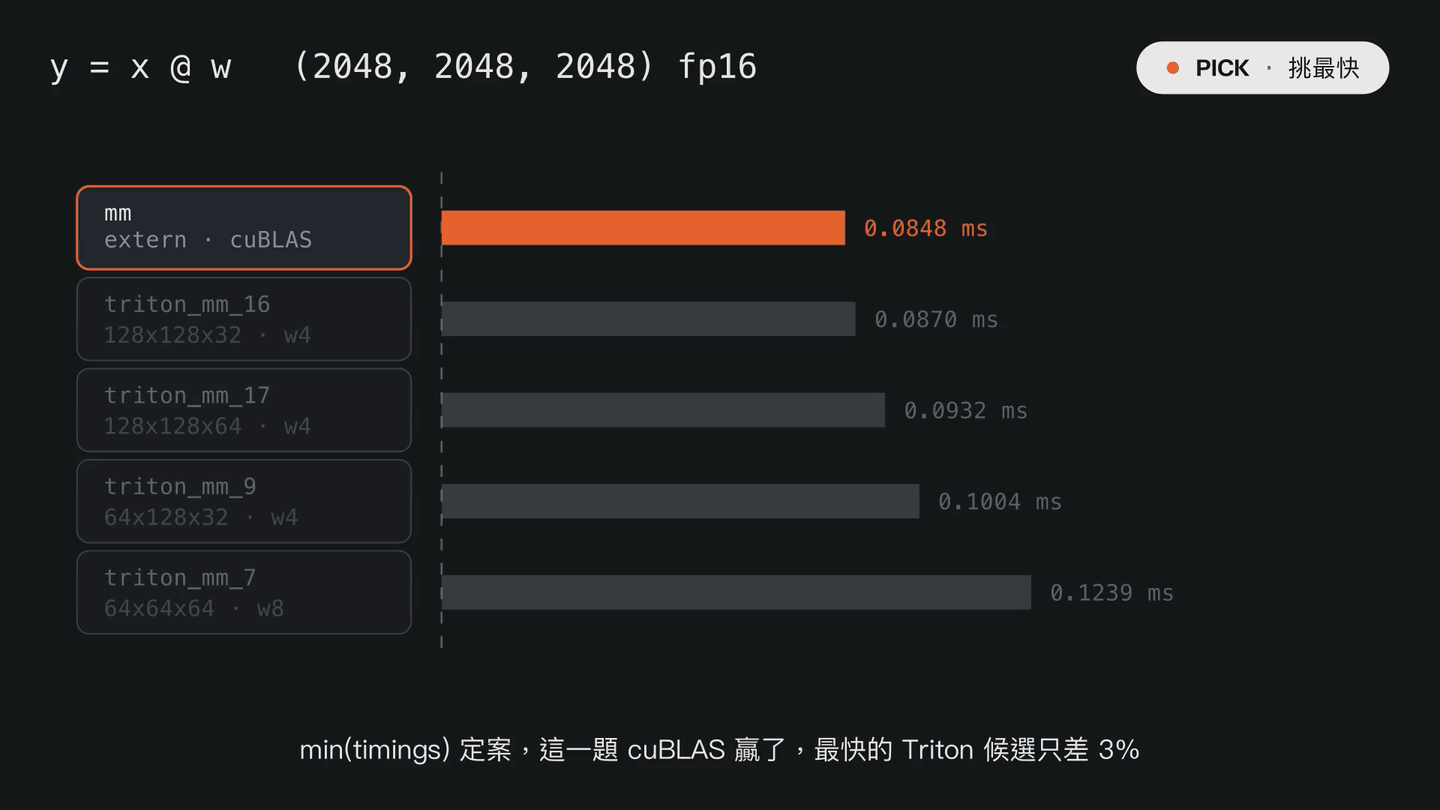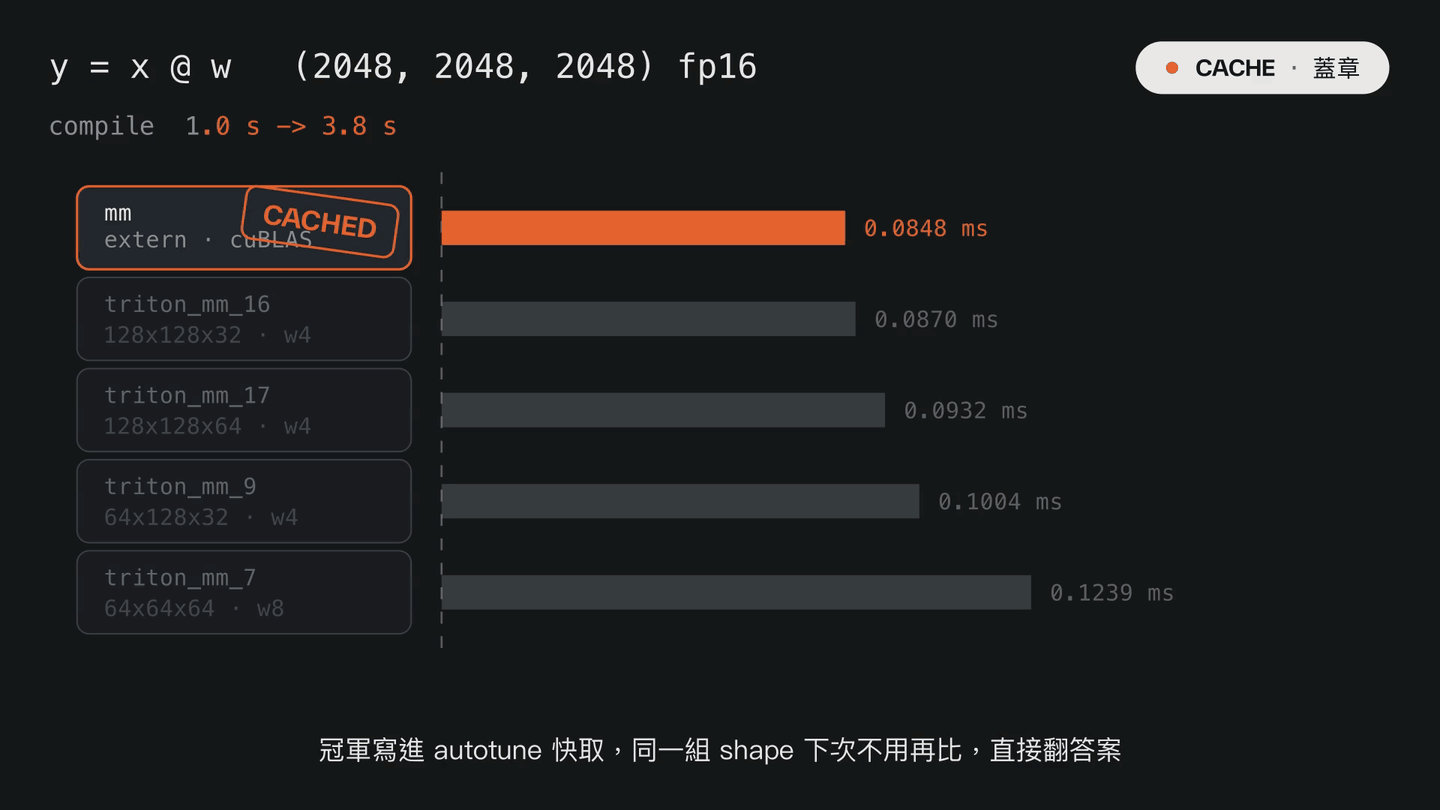
圖一:autotune 的一生。lowering 碰到 aten.mm 先開出候選名單,extern 的 cuBLAS 加上不同 BLOCK 配置的 Triton template,AlgorithmSelectorCache 拿真的 tensor 同場計時挑出冠軍,代價是編譯時間從 1.0 秒漲到 3.8 秒,答案蓋上 cached 收進快取。
把矩陣換成 16x4096 乘 4096x4096 這種瘦長條,再比一次(節錄)。
AUTOTUNE mm(16x4096, 4096x4096)
  triton_mm_35 0.0655 ms 100.0% ACC_TYPE='tl.float32', ALLOW_TF32=False, BLOCK_K=64, BLOCK_M=16, BLOCK_N=128, EVEN_K=True, GROUP_M=8, USE_FAST_ACCUM=False, num_stages=5, num_warps=8
  triton_mm_30 0.0666 ms 98.5% ACC_TYPE='tl.float32', ALLOW_TF32=False, BLOCK_K=64, BLOCK_M=16, BLOCK_N=128, EVEN_K=True, GROUP_M=8, USE_FAST_ACCUM=False, num_stages=3, num_warps=4
  mm 0.0676 ms 97.0%
這次 cuBLAS 掉到第三,冠軍是 Triton 候選,它的 tile 高度剛好貼著 16 列的輸入,一格都不浪費。名單也跟著 shape 變了,篩出來的全是瘦版模板。生成的程式碼第一次出現 Triton 版的 matmul,benchmark 的差距也是真金白銀。
[max-autotune] compile time: 1.6 s
    triton_tem_fused_mm_0.run(...)
eager           0.0295 ms
default         0.0296 ms
max-autotune    0.0200 ms
1.48 倍。cuBLAS 對這種瘦長 shape 沒有特調,模板搜出來的 kernel 就有利可圖,LLM 推理裡大量的小 batch matmul 正是這種體質,max-autotune 的口碑也多半是這樣賺來的。同一段程式碼,兩種 shape,兩個相反的冠軍,這就是為什麼只能實測。
講 fusion 時撞過一面牆,matmul 是 extern kernel,前後的 pointwise 融不進去。當時留了一句話,想拆牆得讓 Inductor 自己生 matmul,現在條件湊齊了。拿 relu(x @ y) 對照,預設模式是標準的牆內牆外。
[default] compile time: 0.3 s
    extern_kernels.mm(...)
    triton_poi_fused_relu_0.run(...)
max-autotune 之下,matmul 由模板生成。relu 這種接在後面的收尾運算叫 epilogue,可以縫進模板尾巴,兩顆 kernel 變一顆。
[max-autotune] compile time: 1.5 s
    triton_tem_fused_mm_relu_0.run(...)
名字說明了一切,tem 是 template,mm 和 relu 同居一顆 kernel。模板生成的 matmul 有 Inductor 自己的 loop,pointwise 就掛得上去,中間那份 2048x2048 的結果不用再落地。不過 benchmark 潑了盆冷水,default 0.0716 ms,max-autotune 0.0731 ms,牆拆了,時間卻只是打平。融合省下的那趟 relu 讀寫,剛好抵掉模板輸給 cuBLAS 的部分。誰勝出全看這筆帳的正負,而這筆帳一樣要靠實測。
coordinate_descent_tuning 管的是 template 之外的日常 Triton kernel。這些 kernel 的 launch 參數平常由啟發式一次定案,沒有現成的候選名單,所有組合全部枚舉會爆炸。coordinate descent 就是解法。以啟發式的答案當起點,一次只動一個參數,往上、往下各調一格,量到有進步就搬過去再從新位置繼續,直到四面八方都沒有更快為止。指數級的枚舉被壓成每個軸各走幾步,代價是可能停在局部最佳。拿 softmax 實測,log 把爬山的腳印全印了出來(節錄)。
= Do coordinate descent tuning for triton_red_fused__softmax_add_0 =
Baseline Config XBLOCK: 8, R0_BLOCK: 512, num_warps: 16, num_ctas: 1, num_stages: 1, maxnreg: None, baseline timing 0.013312
Try config XBLOCK: 16, R0_BLOCK: 512, num_warps: 16, num_ctas: 1, num_stages: 1, maxnreg: None
Try config XBLOCK: 4, R0_BLOCK: 512, num_warps: 16, num_ctas: 1, num_stages: 1, maxnreg: None
Try config XBLOCK: 8, R0_BLOCK: 1024, num_warps: 16, num_ctas: 1, num_stages: 1, maxnreg: None
Improve from XBLOCK: 8, R0_BLOCK: 512, num_warps: 16, ... 0.013312 -> XBLOCK: 8, R0_BLOCK: 512, num_warps: 16, ... 0.013312, 1.000x
每個參數都往上下各試了一步,這一題鄰居都沒有更快,最後的 1.000x 表示原配就是最佳解。碼表說不用改,也是一種答案。
把三場實驗的編譯時間排在一起,2048 方陣從 1.0 秒漲到 3.8 秒,瘦長條從 0.1 秒漲到 1.6 秒,mm 加 relu 從 0.3 秒漲到 1.5 秒。一顆 matmul 就要精編二十個候選再逐一計時,真實模型裡幾十顆 shape 各異的 matmul 會把這筆帳乘上去,編譯拉長到幾分鐘並不稀奇。這是一筆用編譯時間換執行時間的交易。模型定型後要跑成千上萬次 inference 或訓練 step,攤下來穩賺,改兩行就 recompile 一次的開發階段則未必划算。
好消息是這筆錢不用重複付。AlgorithmSelectorCache 名字的後半段就是重點,比賽的計時結果會存下來,同樣的比賽第二次直接翻答案。這整個系列的每個實驗背後,都有一套快取體系默默接住所有編譯產物,從 kernel 原始碼、編好的整張圖到今天的計時表。它怎麼分層、存在哪裡、什麼時候會失效,明天就來把它攤開。
收攏一下今天的機制。同一個 matmul 有 cuBLAS 和填了不同參數的 Triton template 這些候選。預設模式只有 cuBLAS 一人,開了 max-autotune 才全員進場,實測計時挑出冠軍。方正的 shape 讓 cuBLAS 贏,瘦長的 shape 讓模板贏出 1.48 倍,帶 epilogue 的比賽則是拆掉那面牆再用碼表裁決,pointwise 這邊由 coordinate descent 一格一格爬。結論都來自實測,代價是編譯時間翻了幾倍,結果會進快取。
明天來看接住這一切的快取體系,torch.compile 為什麼第二次跑這麼快。那我們明天見!


 iThome鐵人賽
 看影片追技術