
昨天看了 autotune 怎麼幫一顆 kernel 海選出最快的寫法,答案很準,帳單也很驚人。不只 autotune,整條編譯流程都是拿啟動時間換執行速度,如果每次重開 process 都得再付一次,這筆交易就很難划算。好消息是 torch.compile 把快取做得相當徹底,而且分了好幾層。今天就來看編譯成果存在哪裡、開櫃子的鑰匙是用什麼打出來的、什麼時候會突然開不了鎖、又要怎麼確認自己有沒有拿到便宜。
正文開始!
先量一下多貴。實驗照舊在本機 CPU 上跑(torch 2.8.0),拿一個 matmul 加 gelu 加 sum 的小函式當實驗品,完整程式在 code/day24/。
def f(x, y):
    return torch.nn.functional.gelu(x @ y + 1).sum(dim=1)
把快取目錄整個刪掉,從全新狀態編一次,log 節錄如下。
[run 1: fresh cache dir, n=512]
  first call (compile):   3.75 s
  second call (cached):   1.03 ms
  fxgraph_cache_miss=1 fxgraph_cache_hit=0
第一次呼叫的 3.75 秒裡疊著整個系列講過的每一站,從 trace 一張圖開始,一路展開、最佳化、生出程式碼,最後還要請把生成的 C 編成 .so。這還只是三行的玩具函式,真實模型有幾百張圖要走這條流水線,冷編譯輕鬆上到分鐘級。而付錢的場合比想像中多,訓練 job 重啟一次付一次,推論服務 rolling update 又付一次。
同一個 process 裡的第二次呼叫只要 1.03 ms。process 就是一次程式執行,關掉再開就是另一個 process。這 1.03 ms 靠的是講 Guard 時說過的那層記憶體內快取,不是今天的主角。真正的問題是 process 一關,這層就跟著蒸發。
同一個快取目錄,重開一個 process,編同一個函式。
[run 2: same cache dir, n=512]
  first call (compile):   0.79 s
  second call (cached):   0.73 ms
  fxgraph_cache_miss=0 fxgraph_cache_hit=1
3.75 秒變 0.79 秒,這就是存在磁碟上的 FXGraphCache 在接手。它守在 Inductor 的正門口,拿到一張圖後先不急著編,而是把圖和輸入的資訊拼成一把鑰匙,也就是 cache key,再拿這把鑰匙去磁碟上找現成的貨。找到了叫 hit,成品直接搬出來掛上,整段編譯跳過。找不到叫 miss,只好走完全程,最後用這把鑰匙把成品存進去,留給下一個 process。
log 裡的 fxgraph_cache_hit=1 是確認快取有沒有吃到最直接的辦法。要看更細可以開 TORCH_LOGS="+torch._inductor.codecache",log 會直接把鑰匙印給你。
fx graph cache hit for key fih5y2v32k3xkqrqilffnjrj36iym4ih5wnqc46hpvqv4bwj3hgr
值得注意的是 0.79 秒沒有歸零。新 process 還是得重新 trace 一次、重建 guard,磁碟快取救的是後半段,最佳化、codegen 和 C++ 編譯全部變成一次磁碟讀取。
快取目錄預設在 /tmp/torchinductor_<user>,可以用 TORCHINDUCTOR_CACHE_DIR 改位置。跑完上面兩輪之後,把門打開,裡面長這樣。
  3b/c3b5dchwczelzcuy6vgbf56y5ycgcs5f5imcnyqztbduxgwcqnhj.py  (5 KB)
  aotautograd/ae7ovyzz7gtp7s2l7imxtwrtul3tnk5iyrsuzsv7iofjnwjn4nfi/pvjhno2m3ulqefopwlqu7hl7wg5vewnw7m5vtofyduifarxr4ry  (42 KB)
  b7/cb7wkkioof5pkquoovazf5u7tubwi65tnzsp6psbxafpkeexwd2w.main.so  (53 KB)
  dq/cdqdltvbalg3t3on3nulfqdrac4xhwkkplet7ypqfruiazm33qkc.so  (49 KB)
  fxgraph/ih/fih5y2v32k3xkqrqilffnjrj36iym4ih5wnqc46hpvqv4bwj3hgr/3wllna56mmhxckjexy2lg7vlpok73hgbfrkepzzttbtcfkf4mzv  (47 KB)
櫃子裡住著幾種東西。
**fxgraph/**:FXGraphCache 的本體,存的是整份編譯成品,第一層目錄名就是那把鑰匙。**aotautograd/**:把圖展開成 ATen 的結果也存了下來,hit 的時候連這段都不用重跑。**.py 和 .so**:生成的程式碼,以及 g++ 編好的動態庫。檔名是原始碼的 hash,也就是把一段內容壓成一串固定長度的字串,內容一樣就得到同一串。**locks/**:多個 process 同時編譯時上的鎖,免得搶著寫同一格櫃子。GPU 上還會多一種住戶。autotune 海選出的 best config 會存在 kernel 旁邊,下一次直接讀答案,不再重新 benchmark。昨天燒掉的那些海選時間,就是靠這格櫃子只付一次。順帶一提,這整個目錄可以放心刪掉,最壞的結果就是下次啟動回到冷編譯的價錢。
一把能跨 process 使用的鑰匙,必須保證「鑰匙相同就代表編譯結果相同」,所以材料比直覺想的多。
這些材料全部串起來做一次 hash,就是那串 key。材料裡任何一項變了,鑰匙齒形就變了,打開的會是另一格空櫃子。
整個機制用動畫走一遍。
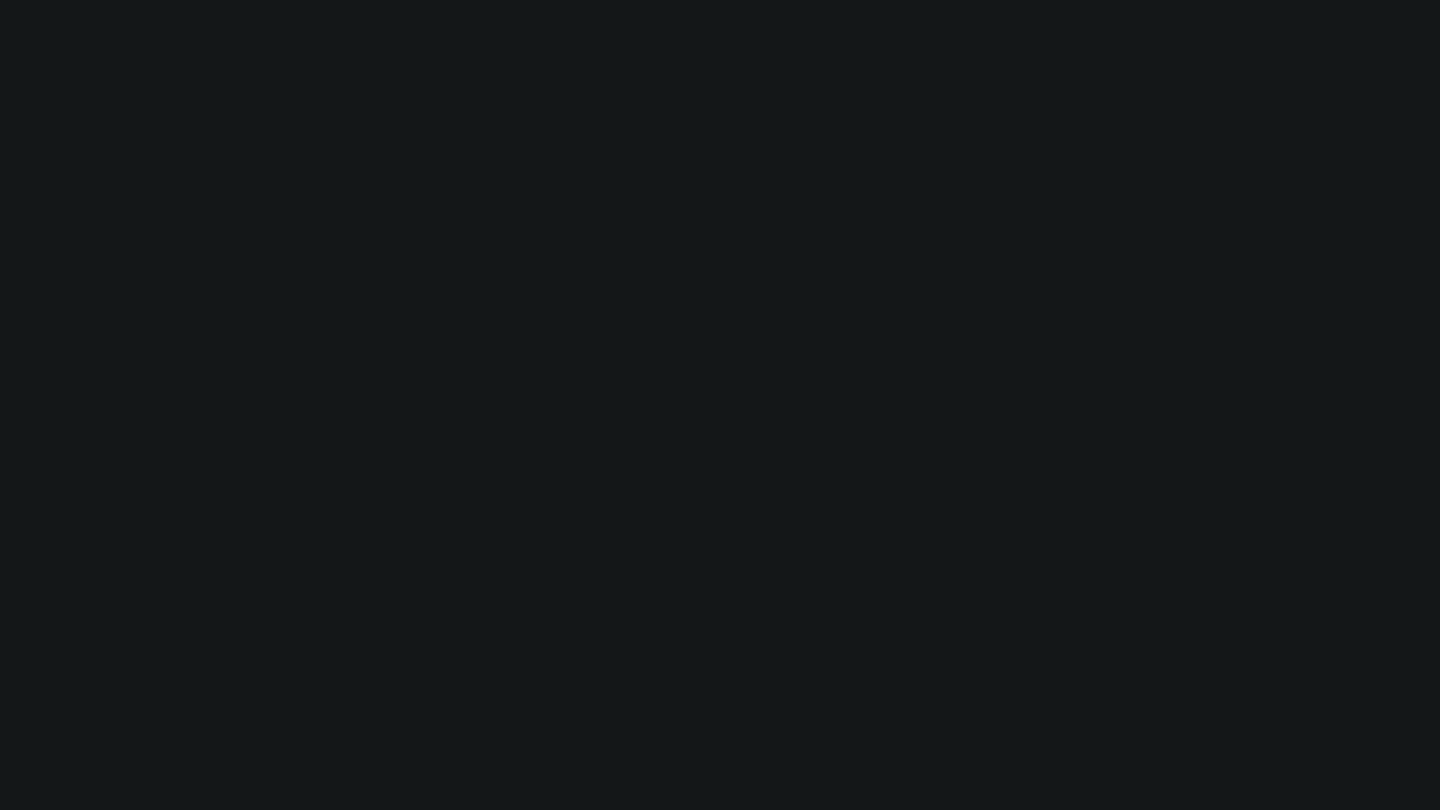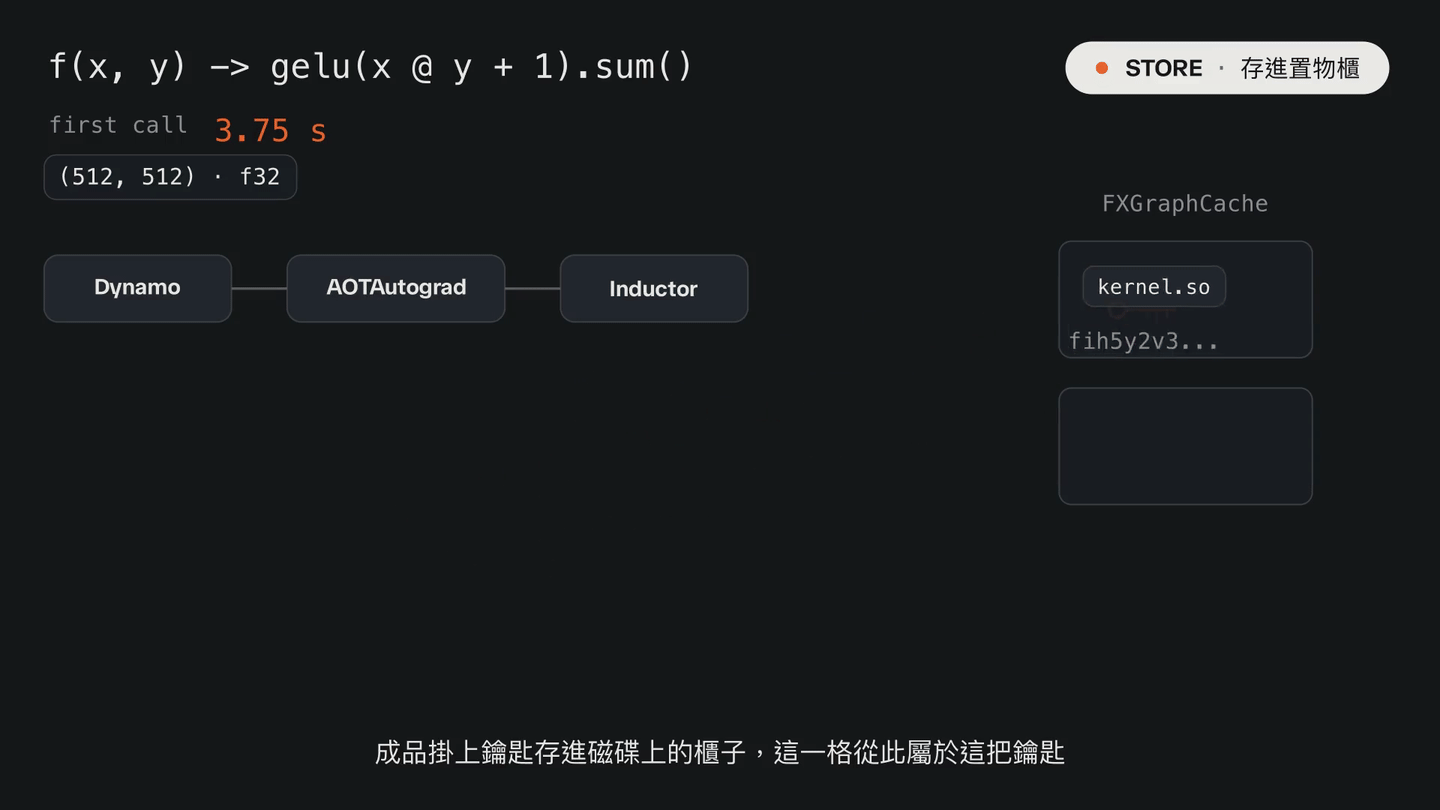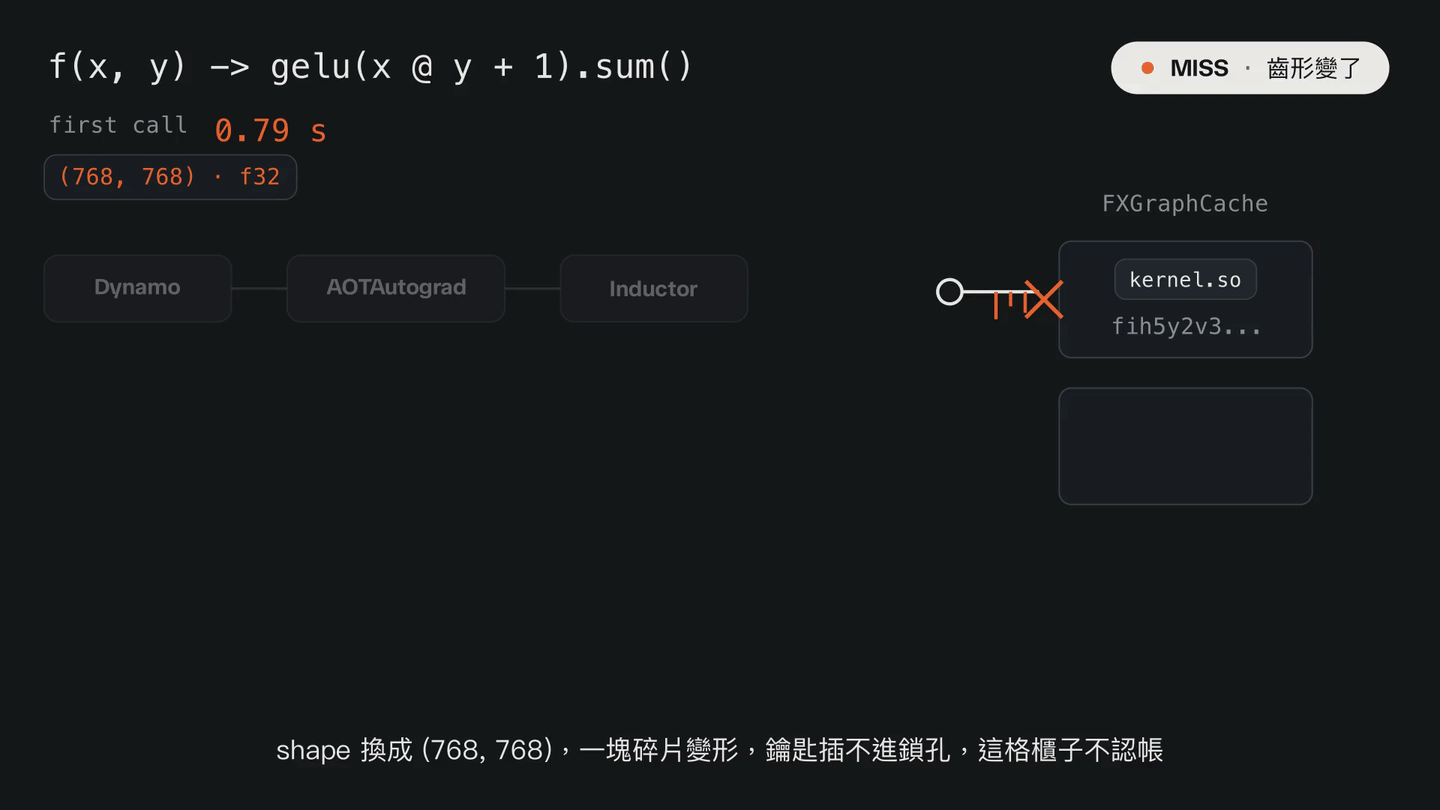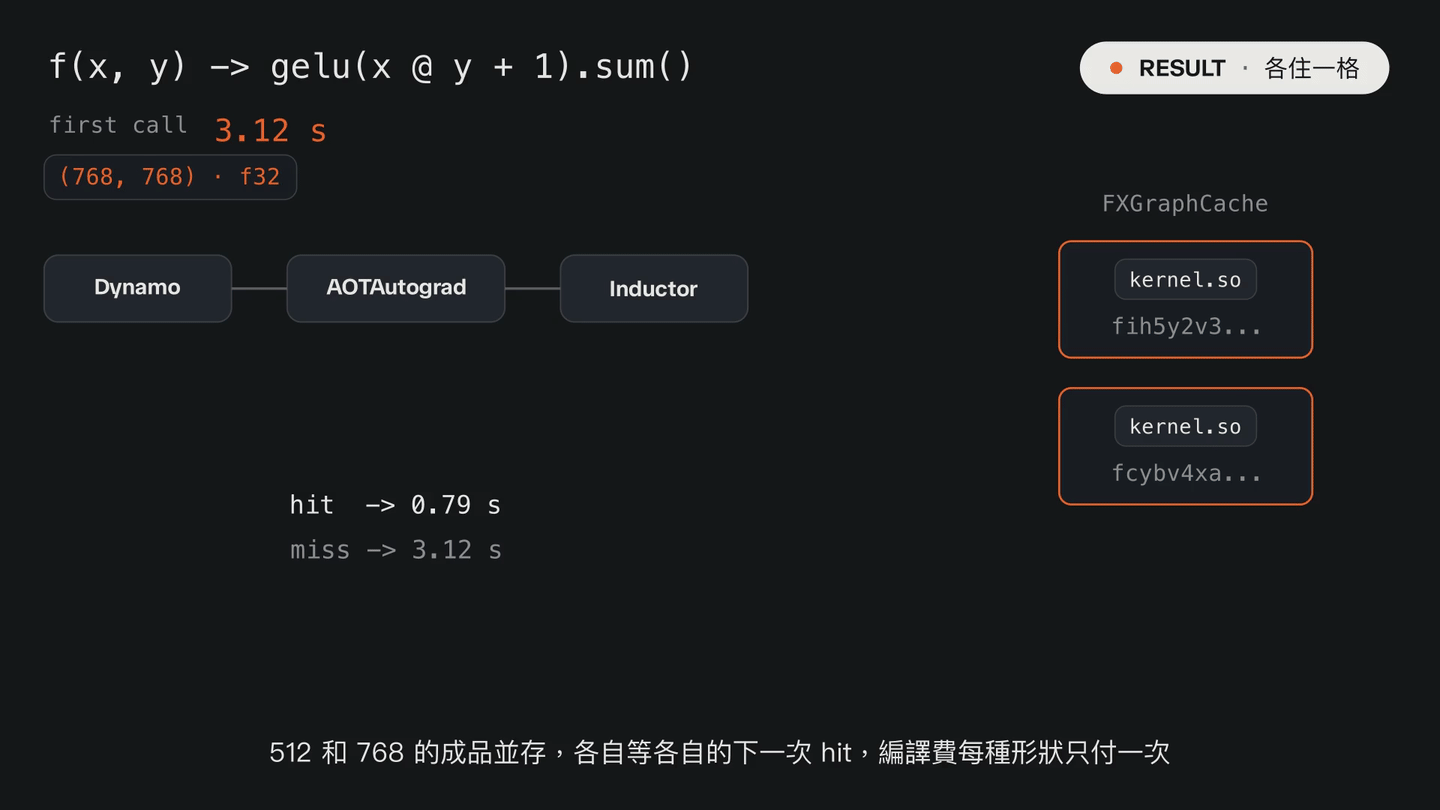
圖一:第一次編譯走完整條慢路,成品存進置物櫃,鑰匙由 graph、shape、dtype、config、torch 版本五塊碎片熔成。第二次同樣的請求打出同一把鑰匙,直接開櫃取貨。shape 一換,其中一塊碎片變形,鑰匙插不進鎖孔,只好重走慢路,再打一把新鑰匙。
拿實驗驗證兩種失效。第一種是換 shape,輸入從 512 改成 768 再開一個 process。
[run 3: same cache dir, n=768]
  first call (compile):   3.12 s
  fxgraph_cache_miss=1 fxgraph_cache_hit=0
靜態圖的鑰匙裡嵌著具體的 shape,768 打出來的就是另一把,整段編譯重付。如果這張圖已經被 automatic dynamic 標成動態,shape 會以符號的形式進鑰匙,這種 miss 就不會發生。第二種是改 config,開 TORCHINDUCTOR_CPP_WRAPPER=1 再跑一次原本的 512。
[run 5: same cache dir, n=512, TORCHINDUCTOR_CPP_WRAPPER=1]
  first call (compile):   3.19 s
  fxgraph_cache_miss=1 fxgraph_cache_hit=0
函式沒動、shape 沒動,只是 config 變了,一樣 miss。config 改變真的會改變生成的程式碼,鑰匙必須誠實。同理,升級 PyTorch 會讓版本這塊材料整個換掉,一櫃子存貨瞬間全數作廢,這是部署時最常見的「怎麼今天啟動特別慢」的原因。懷疑快取沒吃到的時候,先看 log 是 hit 還是 miss,再把兩次的鑰匙印出來比對,log 會告訴你是哪塊材料變了。另外 miss 不是錯誤,新成品會用新鑰匙再存一格,舊的那格也還留著,代價只是櫃子越住越滿。
最後一個對照組把 FXGraphCache 關掉,看少了它會退化到哪。
[run 4: same cache dir, n=512, TORCHINDUCTOR_FX_GRAPH_CACHE=0]
  first call (compile):   2.02 s
  fxgraph_cache_miss=0 fxgraph_cache_hit=0
hit 和 miss 兩邊都是 0,這層被整個跳過,編譯的活全部重做。有趣的是 2.02 秒介於冷的 3.75 和熱的 0.79 之間,因為下面還有一層活著。重新生成的 C++內容一模一樣,hash 一樣,.so 直接複用,省下的正是 g++ 那段。這個數字把分層結構講得很白,上層存整份編譯成品,下層存一顆一顆的產物,打翻上層,下層還會接住能接的部分。
出了這台機器,同一套鑰匙還能再往外延伸。設 TORCHINDUCTOR_FX_GRAPH_REMOTE_CACHE 可以把 FXGraphCache 接上 Redis,整個 cluster 共享一格櫃子,一台機器編過的圖其他機器直接取貨。另一條路是 torch.compiler.save_cache_artifacts(),把這次編譯碰過的快取打包起來,在 CI 裡先熱好,部署機啟動時載回來直接開跑。
把今天的帳算一遍。一次冷編譯 3.75 秒,跨 process 靠磁碟上的 FXGraphCache 降到 0.79 秒。鑰匙由圖、shape、dtype、config、torch 版本熔成,任何一項變動都是一次誠實的 miss。櫃子裡分層放著各階段的成品,關掉一層還有另一層接著,整櫃還能搬上 Redis 共用。
不過快取省下的都是編譯期的錢,模型跑起來之後還有一種執行期的零碎開銷在偷時間,每呼叫一次 kernel 就要付一次 launch 手續費,模型越碎付得越多。明天來看 CUDA Graph 怎麼把一整串 kernel launch 錄成一卷帶子直接重播,mode="reduce-overhead" 背後就是這件事。那我們明天見!


 iThome鐵人賽
 看影片追技術