
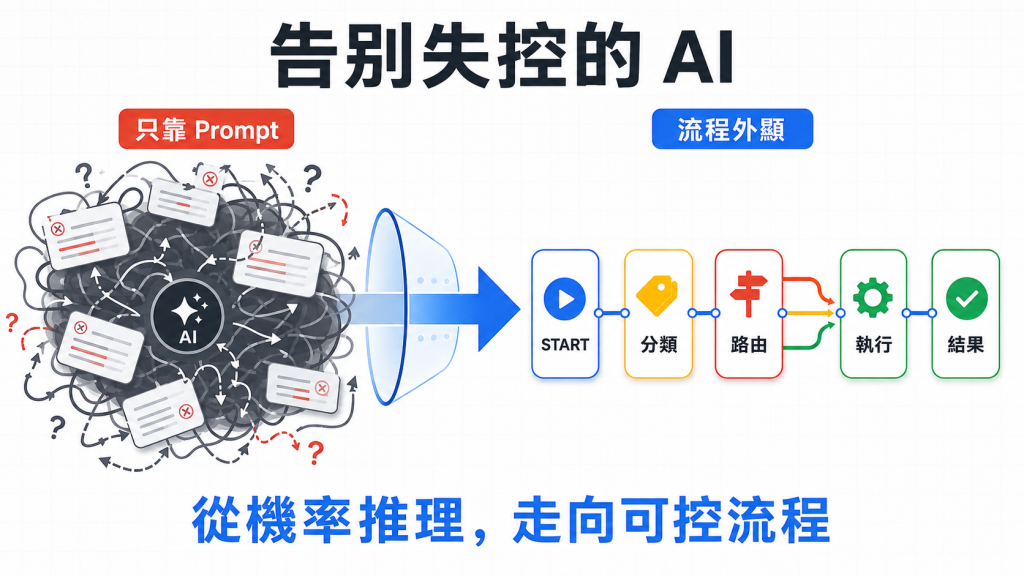
主張:指令寫得再長,也换不来「一定照著做」——想要確定性,就得把流程外顯成一張圖。
讀完能做到:用Workflow畫出含條件分支、fan-out/join、巢狀 workflow 的 agent 流程,並知道 JoinNode 什麼時候會卡死。
Day 12 講完 Plugin 與 Callback,你手上已經有了攔截、修改、guardrail 這些「事件驅動」的武器。但還缺一塊:流程本身怎麼被定義?如果你的 agent 邏輯只寫在一長串 instruction 裡,那不管掛多少個 callback,流程的骨架仍然是「AI 自己看著辦」。今天要處理的,就是骨架本身。
先講一個很多人都踩過的坑:你有一個多步驟流程——分類使用者訊息、依分類轉交給不同處理邏輯、最後彙整結果。第一直覺是把整個流程寫進一個 agent 的 instruction:「第一步做 A,如果符合條件 B 就做 C,否則做 D……」。
短期內看起來會動。但 instruction 越寫越長、條件越疊越多,agent 是不是每次都精準照著步驟走,你其實沒有把握——LLM 終究是在做機率推理,不是在跑一個確定性的狀態機。
Graph-based workflows 的解法,是把流程外顯成一張由執行節點(node)與邊(edge)組成的圖。每個節點可以是 AI agent、工具,或你自己寫的一段確定性程式碼,彼此之間怎麼銜接、什麼條件下走哪條路,全部寫在圖的結構裡,而不是塞進 prompt 裡賭 LLM 會不會照做。
官方列出四個具體優點:
在往下之前,先把座標定位清楚。ADK 提供三種互補的多步驟編排方式:
三者不是互斥的競爭關係,而是同一組編排思維在不同抽象層級的落地方式。
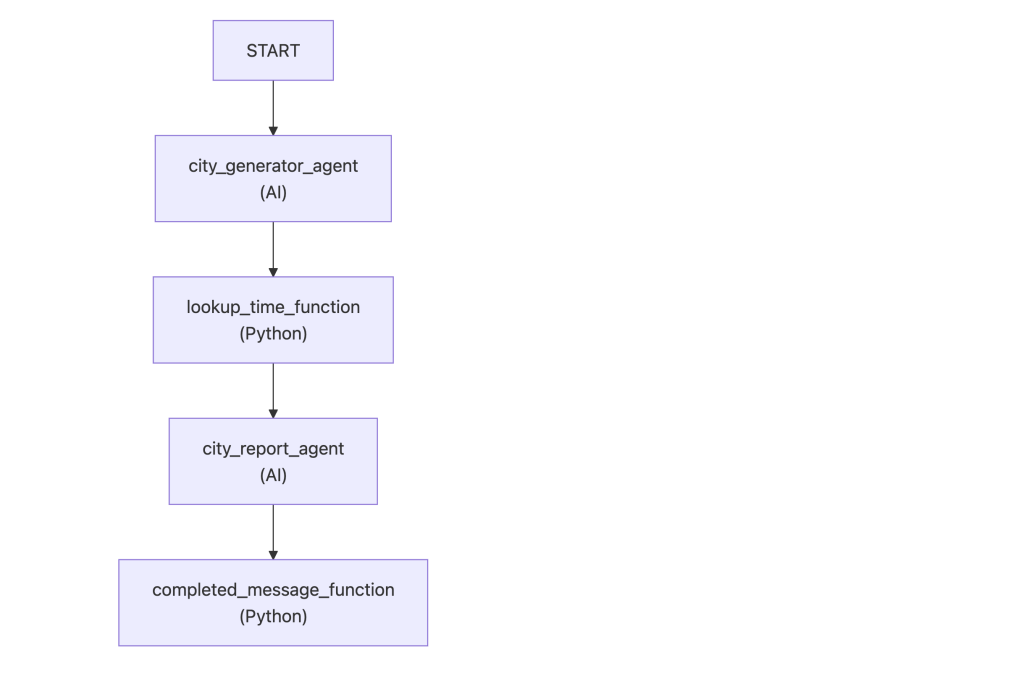
官方的入門範例,示範了一個順序執行的圖:先生成一個城市名稱,再用一段確定性程式碼查那個城市的時間,最後由 agent 把結果組成一句話回報。這條鏈同時混用了 AI 推理(城市生成、報告生成)與純程式碼(查時間),彼此透過 edges 接起來。這裡只示範怎麼把流程畫成圖(建構出 Workflow 物件),安裝套件與實際跑起來(adk run/adk web)沿用 Day 2 教過的做法,這裡不重複:
from google.adk import Agent
from google.adk import Workflow
from google.adk import Event
from pydantic import BaseModel

city_generator_agent = Agent(
    name="city_generator_agent",
    model="gemini-flash-latest",
    instruction="""Return the name of a random city.
      Return only the name, nothing else.""",
    output_schema=str,
)

class CityTime(BaseModel):
    time_info: str  # time information
    city: str       # city name

def lookup_time_function(node_input: str):
    """Simulate returning the current time in the specified city."""
    return CityTime(time_info="10:10 AM", city=node_input)

city_report_agent = Agent(
    name="city_report_agent",
    model="gemini-flash-latest",
    input_schema=CityTime,
    instruction="""Output following line:
    It is {CityTime.time_info} in {CityTime.city} right now.""",
    output_schema=str,
)

def completed_message_function(node_input: str):
    return Event(
        message=f"{node_input}\n WORKFLOW COMPLETED.",
    )

root_agent = Workflow(
    name="root_agent",
    edges=[
        ("START", city_generator_agent, lookup_time_function,
          city_report_agent, completed_message_function)
    ],
)
看 edges 那個 tuple 就懂了整個語法骨架:("START", a, b, c, d) 就是 START→a→b→c→d 的順序鏈。這條鏈裡 city_generator_agent 和 city_report_agent 是會呼叫模型的 AI 節點,lookup_time_function 和 completed_message_function 是純 Python 函式節點。
換成沒有 Workflow 的世界,這條鏈得自己手動接起來:寫一段程式碼把 city_generator_agent 吐出來的文字,轉成 lookup_time_function 看得懂的參數;函式跑完,再把結果包裝成下一個 agent 讀得懂的格式。這種「純粹為了讓上一段接得上下一段」而寫、跟業務邏輯本身無關的轉接程式碼,工程師習慣叫它膠水邏輯(glue code)——就像兩段口徑不合的水管,管子本身都沒壞,但得另外找一節變徑接頭才能黏起來。
Workflow 的 edges 把這節接頭內建了:每個節點的回傳值會自動包成 Event,傳給下一個節點當輸入,你只要照順序把節點名字排進 tuple。同一張圖裡,AI 推理與確定性程式碼就能自由交錯,不用再自己寫一行轉接程式碼。
edges 的 tuple 除了順序鏈,第二個元素若是 dict,就變成條件分支。以下範例先用一個 agent 把使用者訊息分類成 BUG、CUSTOMER_SUPPORT、LOGISTICS,再由一個 router 函式把分類結果轉成路由 key,對應到 dict 裡不同的處理函式:
process_message = Agent(
    name="process_message",
    model="gemini-flash-latest",
    instruction="""Classify user message into either "BUG", "CUSTOMER_SUPPORT",
      or "LOGISTICS". If you think a message applies to more than one category,
      reply with a comma separated list of categories.
   """,
    output_schema=str,
)

def router(node_input: str):
    routes = node_input.split(",")
    routes = [route.strip() for route in routes]
    return Event(route=routes)

def response_1_bug():
    return Event(message="Handling bug...")

def response_2_support():
    return Event(message="Handling customer support...")

def response_3_logistics():
    return Event(message="Handling logistics...")

root_agent = Workflow(
   name="routing_workflow",
   edges=[
       ("START", process_message, router),
       ( router,
           {
               "BUG": response_1_bug,
               "CUSTOMER_SUPPORT": response_2_support,
               "LOGISTICS": response_3_logistics,
           }
       )
   ],
)
router 函式回傳 Event(route=[...]),edges 裡的 dict 就依這個值決定要走哪一條分支。
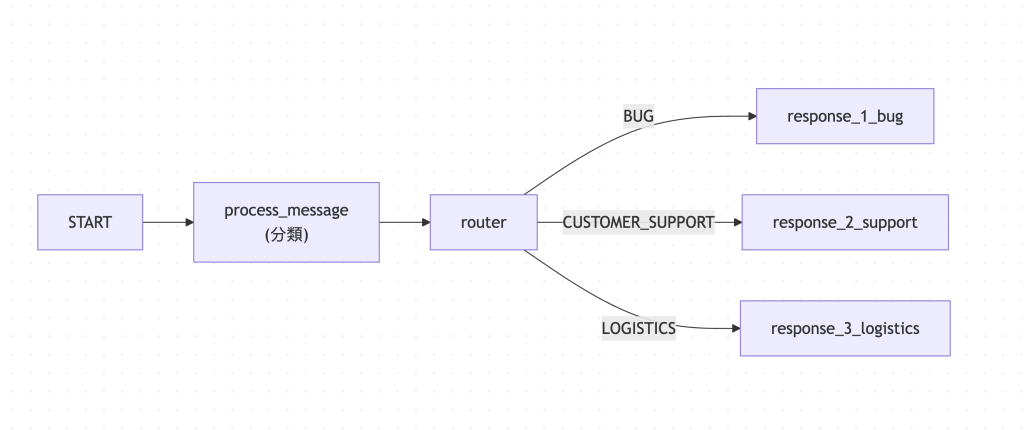
這個例子也順便回答了「資料怎麼在節點間流動」的問題——節點的回傳值會自動包進 event.Output 傳給下一個節點,細節留到 Day 14 展開,今天先記住一件事:graph 裡的資料流預設是靠 Event.Output,不是靠 session state,這跟等一下要學的模板 workflow agents(SequentialAgent 那一套)是兩條不同的路。
graphs/routes 這頁文件涵蓋了四種更進階的圖形結構,每一種都值得記住,因為都對應到真實場景會遇到的需求。
Fan-out 與 join:當你需要平行跑多個獨立任務、再彙整結果時,用 JoinNode 收攏平行分支。以下是官方文件的示意片段,parallel_task_A、parallel_task_B、parallel_task_C、final_task_D 都只是佔位名稱,換成你自己定義的 agent 或函式即可,不能直接複製執行:
from google.adk.workflow import JoinNode

my_join_node = JoinNode(name="my_join_node")

edges=[
    ("START", parallel_task_A, my_join_node),
    ("START", parallel_task_B, my_join_node),
    ("START", parallel_task_C, my_join_node),
    (my_join_node, final_task_D),
]
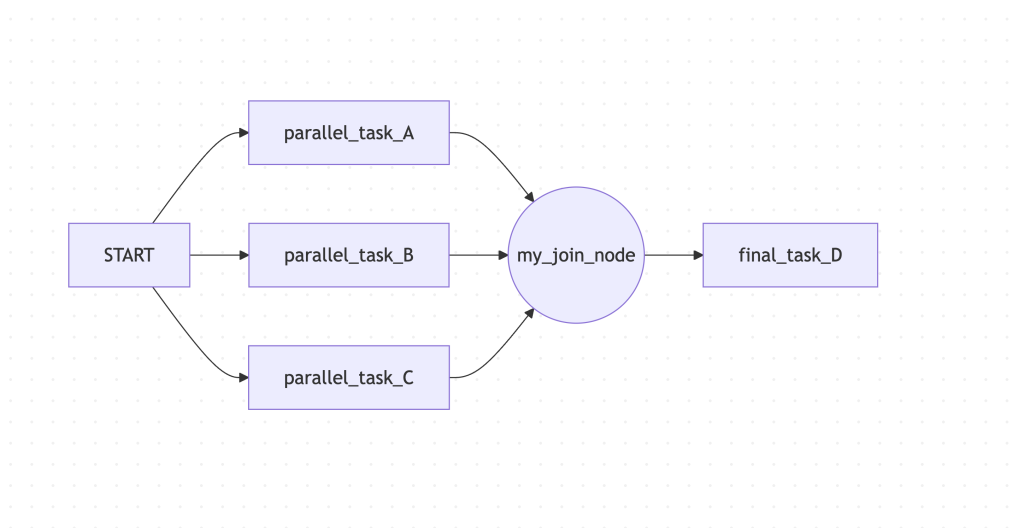
JoinNode 是靠「上游全部節點都吐出 output」才會繼續往下走。只要有一個上游節點失敗、忘記回傳、或卡在某個例外裡沒有正常結束,整個 workflow 就會卡死在那裡,不會有任何 timeout 或錯誤訊息主動告訴你發生了什麼事——你只會看到流程停在那裡不動。官方的建議是每個接到 JoinNode 的節點都要確保有失敗時的保底輸出路徑。
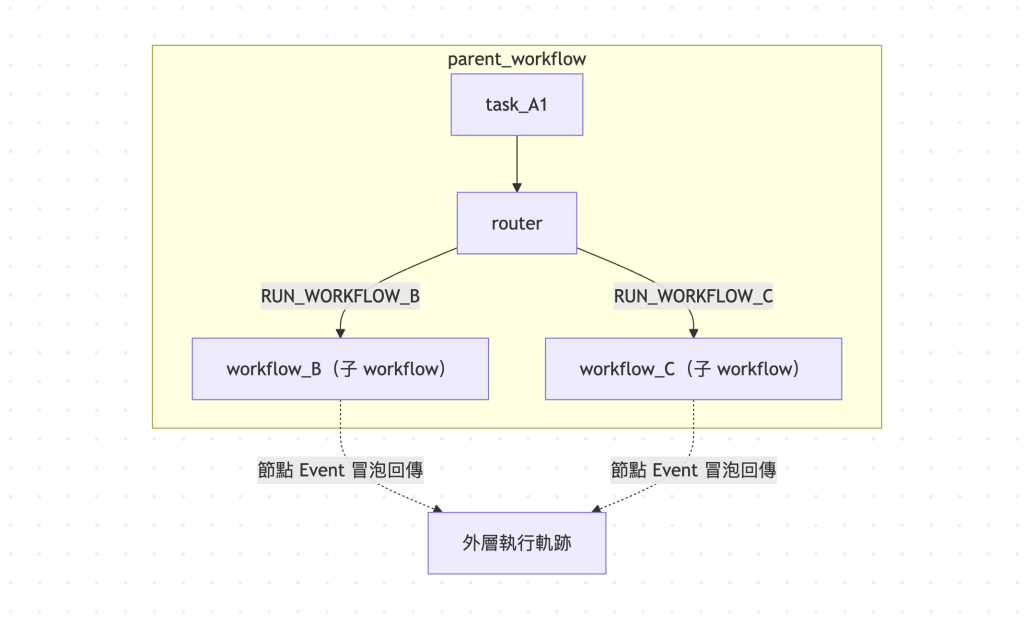
巢狀 workflow:一個或多個 workflow agent 可以當成另一個 workflow 的子節點使用,把複雜任務拆成可重用的子流程。同樣地,以下 task_A1、router、workflow_B、workflow_C 都是示意名稱,不是可執行的完整範例:
from google.adk import Workflow

root_agent = Workflow(
    name="parent_workflow",
    edges=[
       ("START", task_A1, router),
       (router, {
            "RUN_WORKFLOW_B": workflow_B,
            "RUN_WORKFLOW_C": workflow_C,
            },
       ),
    ],
)
巢狀 workflow 的輸出行為跟一般節點不太一樣:當內層 workflow 跑完它自己圖裡的某個節點,資料一方面照常傳給內層圖的下一個節點,另一方面這個 Event 會冒泡回傳給外層 workflow,方便追蹤整個流程的執行軌跡。等內層 workflow 的最後一個節點跑完,外層節點會從那些葉節點抽取資料,當成整個巢狀 workflow 的輸出。
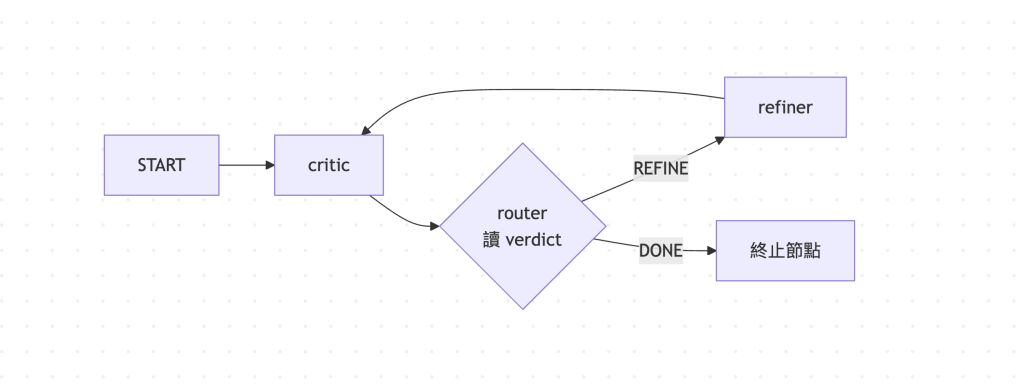
Loop 與 escalation exit:迴圈在 Python 端是圖上的一條反向邊(back-edge),把路由指回較早的節點即可。「escalation exit」不是另一個獨立的事件機制,而是同一個 router 節點除了能路由回上游做迴圈,也能路由到一個終止節點直接跳出——官方範例裡的 critic/refiner loop 就是這樣:router 讀到 verdict 是 REFINE 就走回 critic 繼續迴圈,讀到 DONE 則路由到終止節點結束整個 workflow,不再繼續反向邊。
這本質上跟 Day 16 要講的 LoopAgent(用 Escalate 事件跳出迴圈)是同一個問題:誰來決定何時停,只是 graph 版本用路由條件在結構層解決,LoopAgent 則是用模板參數。
graph-based workflows 不相容於部分第三方 integrations。另外一個容易漏掉的細節:能放進 graph 的 LlmAgent 必須設定成 single_turn 或 task 模式(見 Day 18)——放進 Workflow 的 agent 會被框架自動改成這兩種模式之一,不用手動指定。如果你的 graph 節點打算用一個會跟使用者多輪對話的 agent,這個限制目前行不通。
補充一點:早期版本的文件曾提過 task 模式在 graph workflow 裡一度不能用,但用目前的套件版本實測,建構期並沒有看到這個限制的跡象——這塊行為可能還在調整,實際用之前建議自己拿當下版本測一次再依賴它。
今天畫出了圖的骨架,但還沒仔細講資料真正是怎麼在節點之間傳遞的——output、message、state 三個參數各自負責什麼、Event.output 為什麼一次只能發一份、schema 又是怎麼約束節點輸入輸出的。Day 14 把這塊資料流攤開講清楚,順便介紹 graph 的彈性版本:完全用程式碼控制流程的 Dynamic Workflows。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術