

根因分析(RCA)小組開會,白板上要畫一棵樹。
第一層很順:這次事件是什麼? 某一份必要的確認在流程中被跳過了。事實,寫下去。
第二層也很順:為什麼會被跳過? 因為那個時段同時進來三件事,執行的人一忙就先做別的。有紀錄可查,時間戳對得上。寫下去。
第三層,筆停了。
停了大概十秒。然後有人說:「因為同仁對這個步驟的重要性認知不足。」
全場點頭。寫下去。
第四層順著滑下來:「因為新人訓練不足。」第五層:「因為訓練制度需要檢討。」
二十分鐘,五層完成,收工。
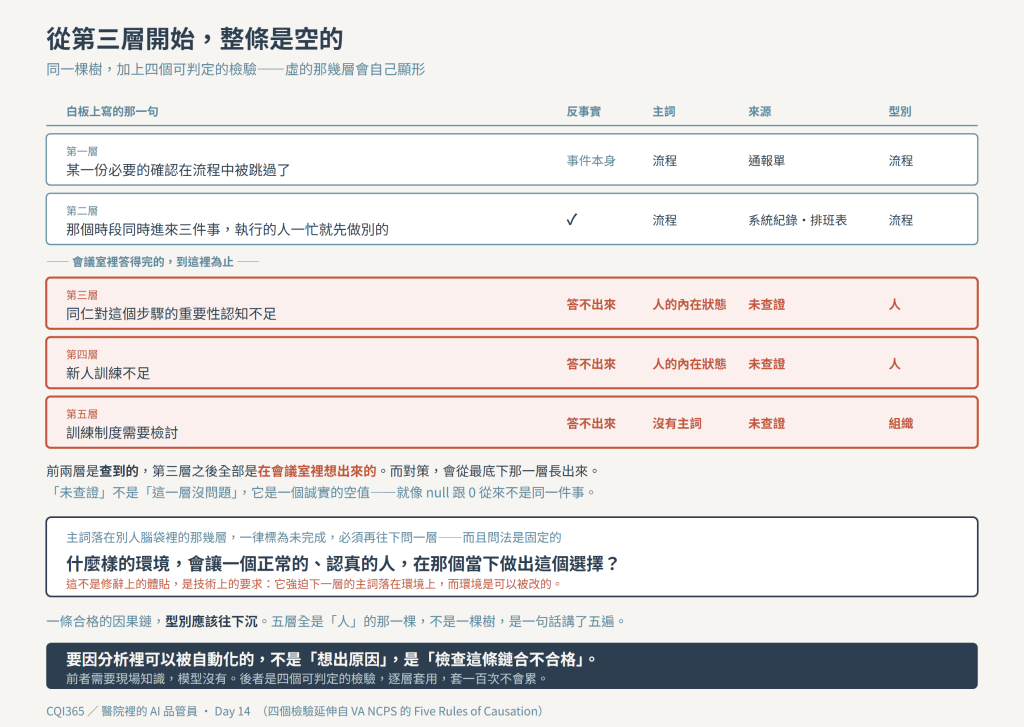
那張圖看起來很完整。但如果你把它拆開看,第一層是查到的,第二層是查到的,第三層之後全部是在會議室裡想出來的。
而對策,會從最底下那一層長出來。所以那一案的對策欄,寫的就是昨天那句話。
五個為什麼的本意其實很謙虛:它不是要你剛好問五次,是要你別停太早。「五」是一個提醒——如果你只問了兩次就覺得找到原因了,那多半只是找到了一個比較深的現象。
所以關鍵是分清楚兩件事:
而崩塌之所以固定發生在第三層,有一個結構性的理由:
前兩層可以在會議室裡完成,第三層開始不行。
第一層是事件本身,寫在通報單上。第二層通常也還在紀錄範圍內——時間戳、排班表、系統的 log,開會的人手上就有。
從第三層開始,你要回答的是「為什麼那個時段會同時進來三件事」「為什麼這件事在忙的時候是可以被跳過的」。要回答這種問題,得去看排班怎麼排的、去看系統在那個狀態下長什麼樣子、去問當天在場的人。
那需要時間。而會議只有一小時,下週要交結案報告。
於是大家伸手去拿一個隨時都在的東西:對人的歸因。
它便宜——不用查。它安全——沒有人能反駁「認知不足」。它還很像一個原因——句型完全正確,主詞動詞受詞都在。
但它有一個致命的性質,而且這個性質直接連到昨天那篇:
一條寫在人身上的原因,只能長出一條寫在人身上的對策。
你沒有辦法對「認知不足」寫一條強效對策。你不能替「不夠警覺」加一個型別。所以那棵樹一旦滑進人的腦袋裡,對策就註定停在強度階層最弱的那一級——不是因為寫對策的人偷懶,是因為上游的分析已經把出路封死了。
五個為什麼不是問五次,是逼你在第三次的時候承認自己沒有證據。
把場景換掉。
線上炸了,事後檢討。時間軸拉出來,第一層:某個 config 的值是錯的。第二層:那個值是上週某次變更帶進來的。
第三層:「因為當時交付壓力大,工程師沒有仔細檢查。」
一模一樣的第三層。一模一樣的十秒鐘停頓,一模一樣的全場點頭。
Blameless postmortem 這個做法之所以被發明出來,很多人以為是為了保護當事人、為了不要獵巫。那只是副作用。真正的理由是:指向人的原因會終結調查。
一旦白板上寫下「他沒有仔細檢查」,後面就沒得問了。你不能對「沒有仔細檢查」做任何工程上的處置,於是行動項目自然變成「加強 code review 的落實」——然後三個月後同一類事故再來一次。
而真正該問的下一句是:為什麼一個錯的 config 可以一路上線?
這一句一問出來,出路就打開了:沒有 schema 驗證、沒有環境間的 diff、沒有 canary、變更視窗跟值班交接重疊。每一條都是可以在系統上擋住的東西。
同一棵樹,第三層往人身上走還是往環境上走,決定了這次事故最後留下的是一份文件,還是一段程式碼。
這就是我想寫這篇的原因。
「這一層是現象還是原因」,在會議室裡是靠資深的人皺一下眉頭來把關的。那是典型的「規則寫不下來的那一半」——沒有人說得清楚判準,但有經驗的人一看就知道這條鏈虛了。
不過它其實比我原本以為的更接近可以形式化,而且不必從零開始。美國退伍軍人醫院體系的病人安全中心(VA NCPS)有一套 RCA 訓練教材在用的 Five Rules of Causation——講的是一條因果陳述要怎麼寫才算合格,例如不可以用負面的評價字眼、不可以拿「違反規定」當原因。那五條是下面這四個檢驗的原型;我做的事是把它們改寫成逐層可判定、而且可以交給機器逐條套用的形式。
四個檢驗,每一個都可判定:
檢驗一:反事實。 如果這一層不成立,事件還會不會發生?
答「還是會」,那這一層不是原因,是伴隨現象。這一條可以刷掉大量看起來很像原因的東西——「當天病人數較多」「當天是連假前」,這些常常是背景,不是原因。
檢驗二:主詞落在哪裡。 這一句的主詞,是不是一個人的內在狀態?
不熟、疏忽、警覺性不足、經驗不夠、認知不足——這一類詞有一個共同性質:不可觀測、不可介入、也不可驗證。 凡是主詞落在別人腦袋裡的,一律標為「未完成」,必須再往下問一層,而且問法是固定的:
什麼樣的環境,會讓一個正常的、認真的人,在那個當下做出這個選擇?
這個問法很重要。它不是修辭上的體貼,它是一個技術上的要求——它強迫下一層的主詞落在環境上,而環境是可以被改的。
檢驗三:這一層是查到的還是想到的。 每一層強制標註來源:系統紀錄、排班表、訪談、現場觀察、或者——未查證。
這一條看起來最無聊,實務上殺傷力最大。因為一張標了來源的因果鏈,一眼就看得出來從第幾層開始整條是空的。回頭看開場那張圖:前兩層有來源,第三層之後六個字重複三次——未查證、未查證、未查證。
未查證 不是「這一層沒問題」,它是一個誠實的空值——就像 null 跟 0 從來不是同一件事,而把兩者混在一起的系統遲早會出事。
檢驗四:這一層屬於哪一類。 每一層標型別——人/流程/系統/組織。
一條合格的因果鏈,型別應該往下沉。如果五層全是「人」,那不是一棵樹,是一句話講了五遍——就像一份 incident 紀錄的根因欄永遠只寫著「人為疏失」。
而這四個檢驗(反事實、主詞、來源、型別)合起來,就是這篇的整合點:
要因分析裡可以被自動化的,不是「想出原因」,是「檢查這條鏈合不合格」。
前者需要現場知識,模型沒有。後者是四個可判定的檢驗,逐層套用,而且套一百次不會累。
那交給 AI 做要因分析會怎樣?
我試過。給一段自己編的事件描述,要它做五個為什麼。前兩層通常不錯——但那沒什麼好高興的,因為前兩層本來就寫在事件描述裡,它做的是重述,不是分析。
第三層開始,它穩定地滑向對人的歸因。而且用詞比人寫的還漂亮:「執行人員對標準作業流程之熟悉度不足」「跨班別溝通機制未臻完善」。
第一個理由跟昨天那篇同源:語料裡的因果句型就長這樣。結案報告、檢討紀錄、事故分析範本,寫到第三層之後,絕大多數就是往人身上收。
第二個理由比較深,而且我覺得它解釋了很多事:
指向人的原因是不可否證的。
「同仁警覺性不足」——你要怎麼證明它是錯的?沒有辦法。它沒有可以被檢驗的斷言,所以它永遠不會被判錯。
而模型在訓練過程中,被反覆獎勵的是「聽起來對」。一個永遠不會被判錯的句子,在這個標準下是完美答案。
模型不是在找原因,是在找一個不會被判錯的答案。而最不會被判錯的答案,通常就是最沒有用的那一個。
這跟昨天「模型偏好在任何情境下都成立的對策」是同一個偏誤的兩個長相。上游往不可否證的原因塌,下游就往不需要協調的對策塌。兩層是連動的,這也是為什麼只修下游沒有用:在 pipeline 的最後一關加檢查,擋不住上游餵進來的東西。
還有一種更難察覺的,而且開場那張白板上就有。
你要求五層,它一定給你五層。但仔細看第三、四、五層:
這是同一件事的三種說法。深度沒有增加,字數增加了。
它滿足的是格式,不是深度。
這也是為什麼「請追問到第五層」這種指令幾乎沒有效果——層數是形式,而形式它一定給得出來。你以為你要到了深度,你要到的是縮排。
換掉指令的著力點:不要求它問幾層,要求它每一層都交代型別與來源。
未查證,而且明確告訴它:填 未查證 是被允許的、是正確的行為第二條的效果比我預期的好,但好的方式不一樣。
我原以為它會因此變得謹慎、少講幾句。並沒有——它不會拒絕回答,照樣把五層鋪滿,只是誠實地在來源欄位填了一整排 未查證。
而那張鋪滿 未查證 的表,本身就是產出——它不是一份分析,是一張 backlog。它等於幫我把「這場會議還缺哪些證據」列成了清單:要調哪天的排班表、要看哪個系統在那個狀態下的畫面、要找誰談十分鐘。
原本 RCA 小組開會是先想原因、再回頭補證據,而通常補到一半就沒力氣了。現在順序反過來:先拿到一張候選鏈與一張缺證清單,會議變成分工去查。
AI 不會拒絕回答,所以你要給它一個誠實的欄位可以填。填滿「未查證」的那幾格,就是這場會議真正該做的事。
寫到這裡,我對這件事的分工判斷已經跟一開始不一樣了。
我一開始想用 AI 做要因分析。後來覺得,更值錢的用法是讓它當檢查者:小組討論完的那棵樹丟進去,讓它逐層跑那四個檢驗——反事實、主詞、來源、型別——然後回報「這條鏈從第幾層開始沒有證據支撐」「哪幾層的主詞落在人的內在狀態上」。
這個分工我還沒讓它變成常態,是我打算這樣做。理由很直接:找原因需要它沒有的東西(現場、走廊、去年那次被否決的提案),檢查合格與否需要的只是把那四個檢驗套一百次不出錯。後者才是它強的地方,也剛好是我們花最多時間、又最容易因為疲倦而放水的地方。
明天談另一個方向:不是事情出錯之後往回追,而是在它出錯之前先把整條流程想過一遍。而那件事的第一個難題,出乎意料地不是「有什麼風險」。


 iThome鐵人賽
 看影片追技術