

白板上是那條給藥流程的失效模式清單。品管圈的圈長帶著會議,單位主管在場,四位第一線同仁,我們品管室兩個人在旁邊記。
進行到評分那一步,有兩條卡住了:「藥袋標籤與醫囑不符」,跟「輸液幫浦的速率設定錯誤」。
嚴重度,兩條都可能造成需要額外處置的傷害;發生頻率,依大家的印象也差不多。分數幾乎一樣,優先順序不分軒輊。
然後 7B 病房的陳護理長說了一句話:
「這兩個怎麼會一樣?標籤貼錯,給藥的時候核對就會看到。幫浦設錯,除非病人有反應,不然沒有人會發現。」
會議室安靜了兩秒。因為她是對的,而我們的算式裡沒有一欄裝得下她那句話。
給藥前的核對程序,功能上就是部署前的 checklist——重點不在幾項,在於它是一個下游還會再看一次的關卡。而幫浦的速率設定沒有這樣的下游:設定完就開始跑,跑到病人有反應為止。
同樣糟的兩件事,一件會被自己的系統攔下來,一件不會。這個差別,比嚴重度和發生率加起來還重要。
FMEA 傳統上是三個維度相乘:嚴重度、發生率,還有第三個——可偵測性。三個乘起來叫 RPN,風險優先指數。
醫療版的 HFMEA(Day 15 那一套)不用這個乘積,改用嚴重度 × 發生率的危害計分矩陣排優先順序。
這裡有一件常被講錯的事,而它正好是這一篇的支點:HFMEA 並沒有把可偵測性丟掉,它是把它降級了。
可偵測性從一個有刻度、會進乘積的維度,變成危害分析決策樹上的一道是非題。那棵樹依序問三件:這是不是一個單一弱點(單獨失效就足以造成後果)?現有的管制措施擋不擋得住?這個失效偵測得到嗎?三題答完才決定要不要往下做——三個問題、一條 boolean 路徑,在你的世界裡是一段守門的 if,不是一個分數。
所以精確的講法是:它從一把尺,變成一道閘門。
而降級是有理由的:人評不準。 一個人在會議上腦子裡同時穩住三把尺,差不多就是上限;即使只有三把,評分者之間的一致性在文獻上也長期偏低(Day 20 整篇談這件事)。而可偵測性又格外難評:你得同時知道下游有哪些關卡、那些關卡實際上有沒有在執行、以及——最麻煩的——沒被發現的那些你根本數不到。
這是一次「因為刻度量不準,所以只留是非題」的撤退,而且是合理的:一把量不準的尺放在算式裡,會讓整個分數更不可信。這跟「與其留一個會亂叫的 alert,不如把它關掉」是同一個決定——你不是不在乎那件事,你是不相信那個訊號。
但撤退有代價,而代價就是會議室裡那兩秒的安靜。一道是非題裝不下陳護理長那句話:「給藥的時候會被核對到」跟「要等病人有反應才知道」,在決策樹上是同一個答案——偵測得到。
(跟 Day 2 區隔:那一篇問的是有沒有裝監控,是非題;今天問的是下一層的計算題——這一欄該佔多少權重、由誰打分。)
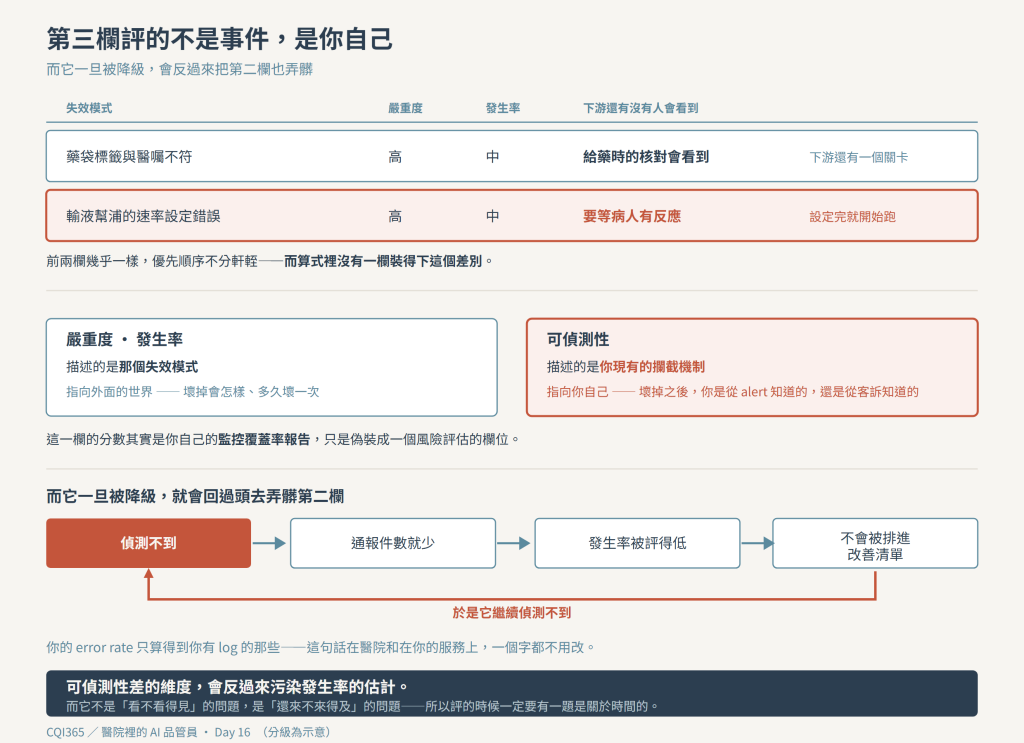
嚴重度和發生率評的是那個失效模式。可偵測性評的是你的系統。
同一條「幫浦速率設定錯誤」,在一家有雙人複核與設定回讀的醫院,跟在一家沒有的醫院,嚴重度一樣、發生率可能也一樣,可偵測性完全不同。
這一欄的分數其實是你自己的監控覆蓋率報告,只是偽裝成一個風險評估的欄位。不用翻譯:
而排優先度的時候,第三欄常常沒有進到算式裡。你會說「這個 bug 影響大又常發生,先修」,很少會說「影響普通、也不常發生,可是它發生的時候我們完全不知道,所以先修」。
第二種其實更該先修。
還有一個更麻煩的連動關係。發生率那一欄的資料哪裡來?異常事件通報、稽核發現、系統紀錄。全部都是已經被偵測到的那些。
於是形成一個閉環:越難偵測,通報件數就越少;通報越少,發生率就被評得越低;發生率越低,越不會被排進改善清單;於是它繼續不被偵測。
可偵測性差的維度,會反過來污染發生率的估計。 把它從算式降級成一道是非題,不是中立地少算一項,而是把一個有方向的系統性低估留在原地。
你的 error rate 只算得到你有 log 的那些——這句話在醫院和在你的服務上,一個字都不用改。
我得承認一件事,因為那是我對這一欄特別有意見的原因。
幾年前我參與過一個預測系統,題目是洗腎病人的透析中低血壓——病人躺在那裡做幾個小時的血液透析,中途血壓可能掉下來。這件事本來靠人看:護理師巡到、機器的告警響了、或者病人自己說不舒服。我們做的,本質上就是把可偵測性做成產品:在它變成事件之前先讓系統知道。說白了就是一個 alert,只是被告警的對象是一位躺在那裡的病人。
回看曾參與的預警案例,當時注意的是模型指標:準確率 87%、ROC AUC 超過 95%,以當時的我來說,那組數字回答了全部的問題。
後來真的走到床邊,我才看見另一個問題,而它不在混淆矩陣上:
看得見,跟來得及,不是同一件事。
一個預警提前的那一段時間如果短到不夠把處置做完,它跟一個提前得夠久的預警長得一模一樣:precision 一樣、recall 一樣、AUC 也一樣。但在病人床邊,它們是兩個完全不同的系統。
那組數字到底回答了什麼、又漏掉了什麼,第四週有一整篇要處理。今天只留跟這一欄有關的那一半:可偵測性不是「看不看得見」的問題,是「還來不來得及」的問題。 所以下面那組問題裡,一定要有一題是關於時間的。
那要怎麼評,才不會回到憑印象打分?不要求任何人直接給 1 到 5 的分數,改成先回答四個事實性的問題:
四個答案出來之後,分數才由一組固定的對照規則映射出來。這是整篇最重要的那個接縫:把一個主觀評分,拆成幾個可查證的事實,加上一段公開的映射規則。 事實那一半是資料,映射那一半是規則,分開放——就像 lint 規則跟被 lint 的檔案本來就不該住在一起。
分數本身沒有變得比較客觀,但它變得可以被爭論。單位主管可以說「第三題我們其實是隔天對帳,不是同一班」,然後分數自己會動。原本那種評法你只能爭論結論;現在你爭論的是前提。
HFMEA 把可偵測性降級的理由是「人評不準」。那就要問:人為什麼評不準?三個原因,而三個都不是「這件事本質上無法判斷」:
三個原因指向同一件事:問題出在評分者,不在這個維度。 而評分者是可以換的。
模型不會累。第三十條和第一條用的是同一份判準,也不會因為前一條給了 4 分就把這一條往 3 分拉。這正是它在這個位置的價值——不是它比陳護理長懂現場,是它在重複中不會漂移。
但要立刻補一個但書:不會漂移,不等於判得對。 一個穩定地錯的評分者比隨機錯的更危險,因為它看起來很可靠——它不是 flaky,是校準錯了,而校準錯的東西每一次都給你同一個安心的答案。所以這一步從一開始就得配一組驗證,那是第四週整週的主題。
那四個問題是為人設計的,但也正好是餵給模型的形狀。模型只回答那四個問題,不給分數;分數由一段人看得懂的規則從答案算出來。
省事的替代方案當然存在——直接問模型「這條的可偵測性是幾分」,一步到位。不選它,兩個理由:
第一,直接給分,你無法審查它。 它說 4 分,你只能回「我覺得是 3 分」,又回到憑印象。拆開來之後,你反駁的是「第二題答錯了,我們那一關已經取消一年了」——這種爭論會收斂。
第二,量尺是會變的。 哪天委員會把「隔天對帳」從 3 分改成 4 分,映射規則若活在 prompt 裡,你得重寫 prompt、跑一次 full regression、再解釋舊分數跟新分數為什麼對不起來;規則放在外面,你改一行對照表,昨天抽出來的事實照樣重算。
判斷交給模型,量尺留在外面。 這條界線我後來到處都用上了。
傳統 HFMEA 的產出是一份表格:做完、簽核、歸檔,下次評鑑前再翻出來。但可偵測性評的是「現有系統」,而現有系統一直在動。這個月上線了藥品條碼刷讀,一整批失效模式的第一題答案從「沒有」變成「有」;某個單位人力調整,第四題從「每次都執行」變成「忙的時候會跳過」。
一份 HFMEA 表格做完就歸檔,但它那一欄的正確值,每天都在變。
所以這一步真正的自動化價值不在「幫我打分數快一點」,是它讓這份表格可以重跑。輸入兩份:交接點清單,加上一份「現有攔截機制清單」——後者由資訊單位維護,本來就存在,只是沒有人把它當成風險評估的輸入。系統一改,清單改一行,整份風險排序重算一次,把變動最大的那幾條送到委員會。
到這一步,HFMEA 就不再是一份文件,是一個會隨系統狀態變動的視圖。而你的風險評估表本身,也是一個需要被監控的東西。
我最擔心的不是模型答錯,是它往哪一邊答錯。
第一到第三題問的是「有沒有攔截機制」,這些寫在 SOP 裡,模型讀得到。第四題問的是「實際上會不會執行」——這件事沒有寫在任何地方。一個只讀過應然版本的評分者,回答實然問題時會偏向哪一邊,方向是可以預期的。
所以第四題不讓模型答,它只能標記「需要單位確認」,由那個單位的人填。這不是不信任模型,是這一題的資訊不在它拿得到的任何文件裡。
而這正好是這個系列的軸心句在這一篇的形狀:規則寫得下來的那一半,是攔截機制的清單;寫不下來的那一半,是那些機制在忙碌的星期一早上,到底有沒有真的被執行。


 iThome鐵人賽
 看影片追技術