

一張每條對策都標了強度、還多一欄「為什麼上不去」的對策表。一棵因果鏈,來源那一欄從第三層開始整排寫著 未查證——那是 null,不是 0。六張寫著交接點的便利貼。一份可偵測性的事實抽取草稿,第四題全空著等現場回覆。還有一份被刪掉一半的失效模式清單,每條旁邊都有一句為什麼刪。
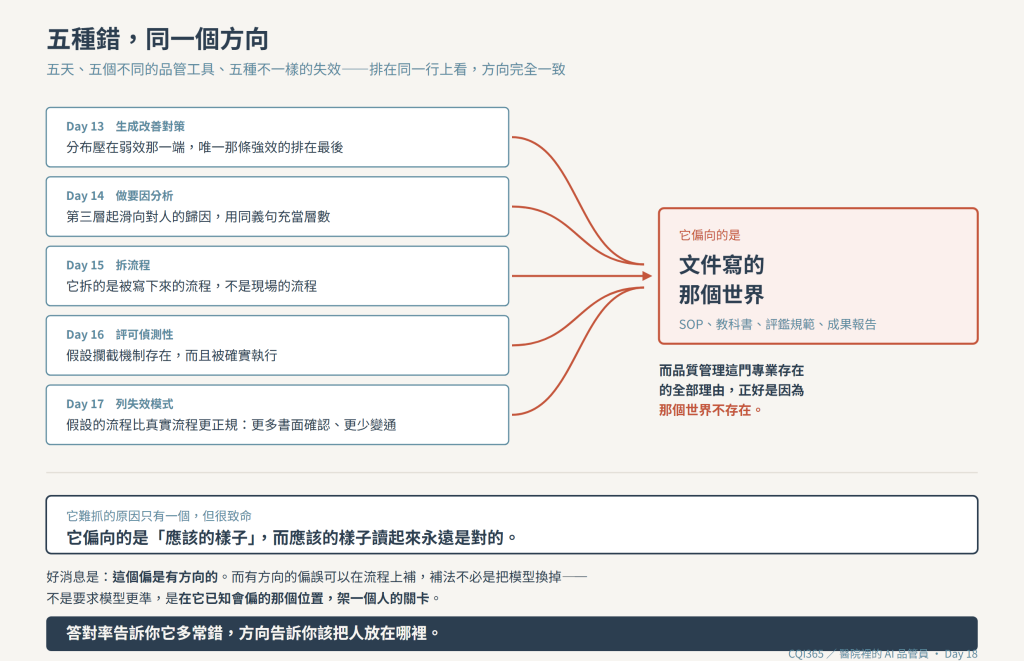
五天,五個不同的品管工具。但排在同一行上看,有一件事很難不注意到:這五天 AI 偏的方向是同一個。
| Day | 它做了什麼 | 偏的方向 |
|---|---|---|
| 13 | 生成改善對策 | 分布穩定壓在弱效那一端,而唯一那條強效的,穩定被排在最後 |
| 14 | 做要因分析 | 第三層起滑向對人的歸因,還會用同義句充當層數 |
| 15 | 拆流程 | 不給約束就給教科書版本,一說「詳細」就崩到動作級——它拆的是被寫下來的流程 |
| 16 | 評可偵測性 | 傾向假設攔截機制存在,而且被確實執行 |
| 17 | 列失效模式 | 假設的流程比真實流程更正規:更多書面確認、更少臨時變通 |
五件事看起來沒什麼關係,並排之後方向卻完全一致:
它偏向文件寫的那個世界。
原因不難推。它讀過的醫療流程文字,主要來自 SOP、教科書、評鑑規範、期刊論文、改善成果報告,寫的全部是應然。
沒有一份 SOP 會寫「這一步在人多的時候會被跳過」,也沒有一份改善成果報告會寫「我們最後選了加強教育訓練,因為改流程要跟三個單位協調,而我們協調不動」。於是模型學到的是一個 SOP 被確實執行、每個關卡都在運作的世界。
而品質管理這門專業存在的全部理由,正好是因為那個世界不存在。
它讀過的 code,是 repo 裡的那一份——不是 production 上實際在跑的那一份,那一份有兩個 hotfix 從來沒有回到主線。
它讀過的架構圖,是畫給人看的那張——不是實際的呼叫關係。
它讀過的 README,是寫下來的那一天的樣子。
它讀過的 test,是會通過的那些。那些被 skip 掉的、被註解掉的、因為 flaky 而被默默移出 CI 的,沒有在任何地方留下文字。
所以你問它「這個服務可能怎麼壞」,它會給你一份很完整的清單——而那份清單描述的是架構圖上的那個服務。真正會出事的那幾個地方:那個沒有人敢動的分支、那個 retry 沒有上限的 client、那個大家都知道該做但永遠排不進去的 migration、那個只有一個人知道要先手動跑一次的部署步驟——它一條都想不到,因為沒有人把它們寫下來過。
我需要一個詞來指它,姑且叫它正規化偏誤——它假設世界照著文件跑。(這不是正式術語。病安領域有一個相近但方向相反的詞叫 normalization of deviance:現場一再走捷徑,久了大家覺得那就是標準。那是現場往下漂,這是模型往上假設。)
它難抓的原因只有一個,但很致命:
它偏向的是「應該的樣子」,而應該的樣子讀起來永遠是對的。
一份寫著「藥師調劑後應核對三次」的失效模式清單,你逐條讀不會皺眉頭——每一條都符合規範、每一條都站得住。你要到真的走進那個藥局、看見尖峰時段實際上核對幾次,才會發現那份清單描述的是另一家醫院。
這跟 Day 14 那個「聽起來對」是同一族的失效,只是換了一層:那一篇講的是因果句型聽起來對,這一篇講的是整個世界模型聽起來對。而後者更難察覺,因為它不在任何一個句子裡,它在所有句子的預設值裡。
如果 AI 的錯是隨機的,這一週的結論會很難看——隨機的錯只能靠人逐條檢查,自動化就沒有價值了,就像一支每次紅在不同地方的 test,你最後只會把它關掉。
但這五種錯的方向都是穩定的。而穩定的偏誤可以在流程上補,補的方式不必是把模型換掉。
五個補法,形狀其實是同一個:
未查證 是被允許的。那張整排 未查證 的表本身就是產出,它是這場會議的 backlog。再往前一步是把角色對調——分析交給人,檢查交給它。
共同點是:不是要求模型更準,而是在它已知會偏的那個位置,架一個人的關卡。 你不會要求一個色弱的人努力看清楚顏色,你會在流程上加一道別的檢查。
這也是為什麼「有方向的錯誤」比「答對率」有價值得多。答對率告訴你它多常錯,方向告訴你該把人放在哪裡。
所以這一週真正的分工,不是「AI 做初稿、人做審核」那種空話,它具體得多:
廣度歸 AI,可行性歸人。
人補的不是「更聰明」。列失效模式那一步,人明顯不如它廣;同一份判準重複套三十次,人也不如它穩——它至少不會 flaky。
人補的是可行性:哪一步在忙的時候會被跳過、哪台機器我們病房沒有、哪一關去年就取消了、哪個對策推不動因為要三個單位點頭。
而可行性只有一個來源:那個坐在會議室裡、會說出「這在我們這裡不可能,因為⋯⋯」的人。
AI 給你的是世界上可能發生的事,人給你的是這裡會發生的事。這兩份清單的差集,就是第三週的全部工作量。
而 AI 的離譜有一個很好的副作用:它逼現場的人把那個「因為」講出來——過去沒有人會主動講,因為大家都知道。
挑一件你這週讓 AI 做過的事,問自己一句:它偏的方向是什麼?
答得出來,就把人放在那個位置,其他地方可以放手。答不出來,先做一件很便宜的事:同一份輸入連跑三次,看它是不是往同一邊倒。倒同一邊,你就有方向了;各倒各的,那是隨機錯誤,這一週的補法一條都不適用。
這五天每一次「它偏了」,靠的都是團隊裡不同專業的同仁看出來的。二十條還能在會議裡逐項討論,兩百條呢?換一組人看,結論會一樣嗎?下個月模型換版,我怎麼知道它偏的方向沒有跟著變——那是一種沒有 test 可以跑的 regression。
第四週是這個系列我最想寫的一週,主題只有一個:當一件事本來就沒有標準答案,你要怎麼驗證做它的系統值得信任。
從一句話開始:「AI 說它有 92% 準確率」是一句沒有意義的話。


 iThome鐵人賽
 看影片追技術