

昨天那場評分會議,螢幕上開著一份失效模式清單。今天講那份清單怎麼來的——時間往回推兩個星期,回到 Day 15 那場工作坊的下半場。
上半場吵完流程怎麼切,白板上留下的不是五個步驟,是六個交接點。下半場就逐個交接點問同一句話:這一次交接,可能怎麼壞?
前面很順。寫到第十四條之後速度明顯掉下來。第十五條有人講了一個,另一個人說「這個剛剛講過了吧」——確實講過,只是換了個說法。再過五分鐘,圈長轉頭問大家:「差不多就這些了吧?」沒有人反對。
這是每一場 HFMEA 都會出現的那一刻,而它很容易被誤讀:大家收工不是因為失效模式只有十四種,是因為在場的人想得起來的只有十四種。
那天晚上,我把那份交接點清單丟給模型。不是整條流程丟進去——是一次一個交接點,跑六次。顆粒度不讓模型決定,Day 15 談過為什麼。
隔天早上匯出的電子清單,四十幾條。下一次會議開啟共用檔案,前五分鐘很安靜,因為確實有幾條是我們完全沒想到、一想就冒冷汗的。到第十分鐘,開始有人笑。
笑的那幾條,才是這篇真正要談的東西。
列失效模式的品質決定整份 HFMEA 的價值。後面的評分再嚴謹,也只能在清單裡面排序——沒有被列出來的那一條,永遠是零分。 它不會被評低,它根本不在這份 test suite 裡,不會有任何關卡提醒你它不見了。
而人在做這一步的時候,受兩個限制。
第一個是會議時間。腦力激盪的產出曲線前十五分鐘很陡,之後很平。沒有人願意為了第三十條開第三次會,而它的價值不見得比第三條低。
第二個比較麻煩:經驗同時是覆蓋率,也是邊界。
陳護理長想得到的失效模式遠多於新人,因為她見過。但她想得到的仍然是「她見過的那些」——而她不知道自己沒見過什麼。這不是能力問題,是資訊結構問題:你無法從自己的經驗裡估計自己經驗的缺口。
所以 HFMEA 本來就有結構化的補救:跨職類組成、多找幾個人、用失效類型的提示清單,對抗的都是同一件事——個人經驗的覆蓋率有邊界,而邊界看不見。從這個角度看,一個沒有經驗的東西在這一步反而有優勢。
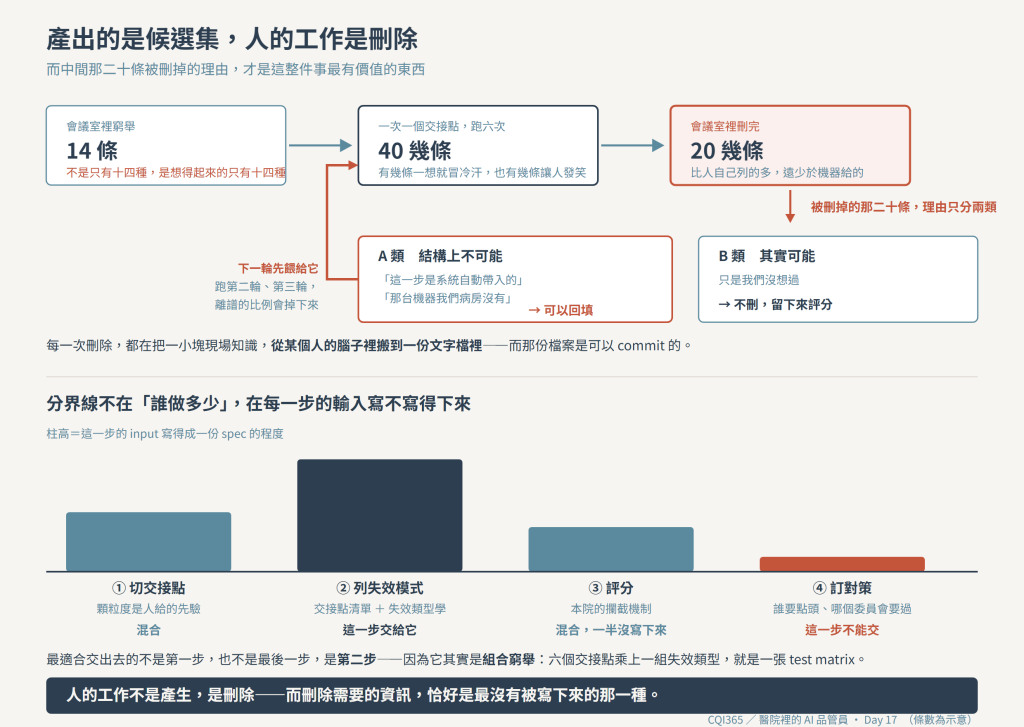
清單在會議畫面上開啟之後,會議室裡做的第一件事不是評分,是刪。刪完剩二十幾條——比人自己列的十四條多,但遠少於四十幾。中間那二十條被刪掉的理由,是這整篇最有價值的東西。
先講分工。常見的講法是「AI 產出,人審核」。這句話跟「code review 要仔細看」一樣對,也一樣沒有用——它沒告訴你哪一步該交出去、交出去之前要準備什麼。
比較有用的問法是:這一步的輸入,能不能形式化?
HFMEA 不只有列失效模式這一步;Day 15 只走完最前面那一步,把流程切成交接點。四步各量一次:
| 步驟 | 這一步真正的輸入是什麼 | 寫得下來嗎 |
|---|---|---|
| 切交接點 | 這條流程實際上怎麼跑、交接切在哪裡 | 部分。顆粒度是人給的先驗(Day 15) |
| 列失效模式 | 交接點清單 + 一般性的失效類型學 | 可以。這其實是組合窮舉 |
| 評分 | 本院的發生頻率、本院現有的攔截機制 | 部分,而且有一半沒寫下來(Day 16) |
| 訂對策 | 什麼在這個單位做得動——誰要點頭、哪個委員會要過 | 幾乎不行,那是 Day 13 的同意成本 |
這張表其實只在問一件事:這一步的 input,寫不寫得成一份 spec?
列失效模式之所以是 AI 最強的一步,不是因為它「有創意」。恰恰相反:它其實是組合窮舉。 六個交接點乘上一組失效類型,就是一張 test matrix,逐格檢查成不成立。人做起來累、會跳格、會提早收工;機器不累、不跳格、不會到第三十條就想散會。
而人在做的那件事——把四十幾條刪到二十幾條——需要什麼輸入?
這個單位的排班、動線、系統設定、誰跟誰交班、哪一台機器我們病房沒有、藥從藥局送上來走哪一條路、中間會不會先放在治療車上等。
這些東西沒有寫在任何一份文件裡。
所以分界線的位置很清楚:
AI 產出的不是答案,是候選集。人的工作不是產生,是刪除——而刪除需要的資訊,恰好是最沒有被寫下來的那一種。
我們後來要求刪的時候必須寫一句理由,而理由只分兩類:
看起來只是行政瑣事,但 A 類有一個很好的性質:它可以回填。 一句「這一步是系統自動帶入」寫下來,下次跑同一條流程之前先餵給模型,它就不會再列出那一整類。跑第二輪、第三輪,離譜的比例會掉下來。
也就是說,每一次刪除,都在把一小塊現場知識,從某個人的腦子裡搬到一份文字檔裡。 而那份檔案是可以 commit 的:誰在哪一輪加了哪一句、後來又被誰改掉,全部留得下來。
它會慢慢長成一個在此之前不存在的東西:這個單位實際上是怎麼運作的。那不是 SOP(SOP 寫的是應然),也不是任何一份系統文件——它是被 AI 的離譜逼出來的副產品。
同時,這一步把 HFMEA 從一場無狀態的會議,變成一個有狀態的東西:這一輪的輸出是下一輪的輸入。這是自動化最實在的形狀,跟模型多強沒有關係。
第一版就是這樣問的,得到的清單看起來很飽滿。看第二遍才發現兩個問題。
一,它在熟悉的交接點上列得很滿,在冷門的那幾個只給一兩條。 清單的分佈跟風險的分佈無關,跟語料的分佈有關。而風險最高的交接往往正好是冷門的那幾個——就像 Day 15 那兩個連流程圖上都沒有的縫:醫囑改了藥局什麼時候才知道、換班時那筆還沒給完的藥。
二,同一個失效模式用三種說法出現三次。 清單長度增加了,覆蓋率沒有:你以為拿到四十幾條,其實是三十條加十條同義句——而你會因為「已經有四十幾條」而停止追問。
改法是把它從「創造力任務」改成「查核表任務」,三件事:
共同點是:把窮舉的結構從模型的自由發揮,改成外面給定的框架。 這跟昨天那篇是同一個手法——Day 16 把量尺留在外面,這裡把窮舉的骨架留在外面。模型的位置是「填」,不是「決定要填什麼」。
第二個設計決策,是為了讓「刪」這件事做得動。
一開始清單上每條只有一句描述。人看到「藥品從包裝取出後放置於治療車上未標示」,要判斷這在我們這裡可不可能發生,得先在腦子裡把它假設的流程重建一遍。很累,而人一累就會用一句「感覺不會」草草帶過——那等於沒有審。
改成要求每一條同時輸出這條成立的前提:這一個交接是誰交給誰、在什麼地點、假設了哪些系統行為。
前提一攤開,刪除就變得很快,因為多數離譜的條目在前提那一行就露餡了——「假設藥品由人工分裝」,而我們這一段是機器自動分包,整條不用再看。
讓模型輸出前提,人審的就不是結論,是前提。 這跟 review 一支 PR 一樣:決定要不要擋的是它假設了什麼,不是它最後回傳什麼。前提可以直接被反駁,結論不行。
這一條後來也回頭改善了 B 類:有些條目乍看不可能,攤開前提才發現它假設的情境我們其實會遇到,只是不常。那幾條正是整份清單裡最有價值的。
回到會議室裡那些笑聲。被笑出來的條目,離譜的方式是有規律的。
我原本以為它的錯誤是隨機的——想像力太發散,講些不著邊際的東西。不是。它假設的流程有一個穩定的傾向:比真實流程更正規。
更多書面步驟、更多雙重確認、更清楚的職責分工、更少的口頭交班與臨時變通。它想像的是一間每個環節都有人簽名、每個交接都有紀錄的醫院。
原因不難推。它讀過的醫療流程描述,主要來自教科書、SOP、評鑑規範、期刊論文、改善成果報告,寫的全是應然——SOP 是規格書,現場跑的是 production,而這兩份東西從來沒有對過帳。
沒有任何一份 SOP 會寫「這一步在星期一早上人多的時候會被跳過」,但那件事每個星期一早上都在發生。
這跟 Day 16 那個「可偵測性可能偏樂觀」同一個根:一個偏誤,在不同的步驟長出不同的樣子。
而方向是穩定的——這其實是好消息。穩定的偏誤可以在流程上補:既然知道它會假設一個更正規的世界,就把「實際執行狀況」整批標成需要現場確認,不讓它自己答。隨機的錯誤才難處理,因為你不知道該把人放在哪裡。
前面說 A 類可以回填,讓下一輪更準。這是對的,但有代價:
你把它調得越像我們,它就越只想得到我們本來就想得到的東西。
回填「我們病房沒有那台機器」很安全。但如果回填的是「我們這裡不會發生這種事」——那你就是在用自己的經驗邊界,去修剪一個本來就是找來突破經驗邊界的工具。而找 AI 做這一步的全部理由,正是它沒有我們的經驗。
所以只回填 A 類,而且必須是結構性事實:沒有這個設備、這一步是系統自動、這個品項院內不供應。不能是判斷:我們不會犯這種錯、這個很少見、我做這麼久沒遇過。判斷留到評分那一步用發生率去處理——那裡至少還有一欄分數在,而不是整條消失。
那份回填檔是要 commit 的,會被別人翻。所以這條界線有一個很實用的測法:結構性事實禁得起有人在下面問一句「哪一天改的」,判斷禁不起。
它很細,但它決定這套東西是會愈跑愈好,還是愈跑愈像一面鏡子。
不必等你們導 AI。下一次刪掉一條機器給的候選——失效模式、test case、bug 分類、稽核發現都算——強迫刪的人寫一句為什麼刪,而且只准寫結構性事實。寫進同一個檔案,一個月後回頭看。
那會是你們第一份把「我們實際上是怎麼跑的」寫下來的文件,而且沒有人為它額外撥過時間。
明天做這一週的收尾:五天下來,AI 偏的方向其實只有一個。


 iThome鐵人賽
 看影片追技術