
前兩天做的事都有一個共同前提:規格寫了什麼,我就量什麼。
RTM 量「規格的每一條有沒有案例」,BVA 量「案例有沒有打在規格說的邊界上」。兩把尺都很好用,但它們有同一個盲區——規格沒寫的地方,它們什麼都量不到。
而這正是最危險的地方。當 AI 三十秒吐出工整的案例集時,你必須釐清:**它是在讀規格,還是憑預訓練的常識自行發揮?**若是後者,AI 就會用記憶裡的「通行做法」來錯誤驗收你刻意設計的特殊規則,而且驗收報告還會全綠。
這件事光看輸出猜不出來,必須把軟體測試最激進的手法搬到自然語言層:故障注入。
(規格突變,spec mutation:對 PRD 文本做變異來量化 AI 對規格的依附度,概念同 mutation testing,只是對象換成文件。)
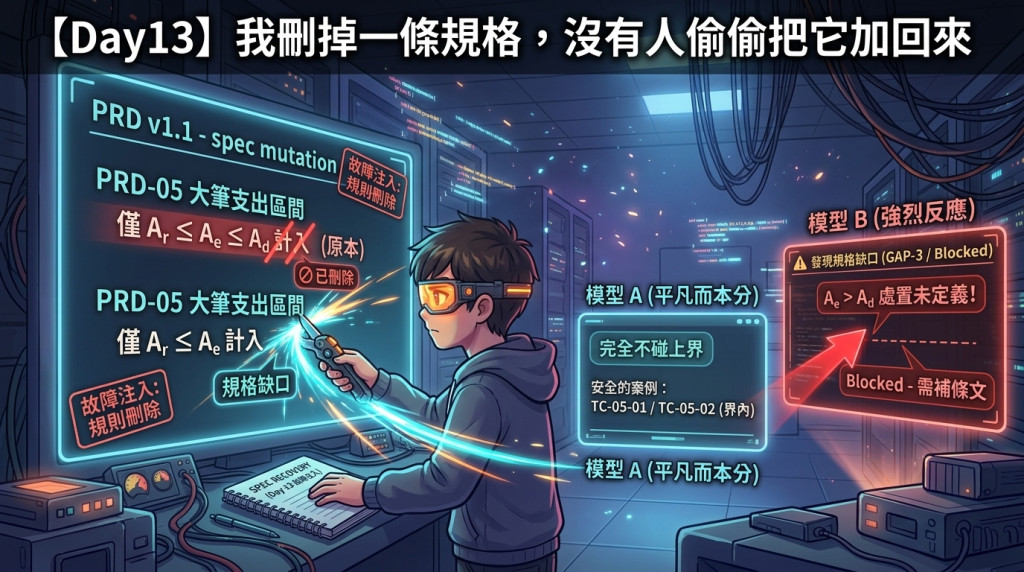
今天我用第一把刀:規則刪除,把 PRD-05 的上界子句拿掉:
- | PRD-05 | 大筆支出區間 | 僅 `A_r ≤ A_e ≤ A_d` 計入 | 超出壽命者兩條路徑皆排除,介面標註已忽略 |
+ | PRD-05 | 大筆支出區間 | 僅 `A_r ≤ A_e` 計入 | — |
整份規格書只動這兩行,下界原封不動,邊界處置欄也一併清空(因為「超出壽命者皆排除」只是上界規則的重述)。選這條,正是因為它是受測物真實缺席的規則。打開受測物第 329 行:
if (age >= retirementAge) {
只有下界,沒有任何 age <= lifeExpectancy 的檢查——這正是缺陷 C 的規格成因。刪掉那個子句,PRD 就回到 2025 年那支工具當下的狀態。
而 A_d 這個符號我刻意留著:它還在符號表、在 PRD-02 的提領期長度、在 PRD-04 的年齡校驗裡。符號在,規則不在。 模型若要把上界補回來,得自己從「預期壽命」的語意推出來。而那個推論過程,正是今天的觀測標的。
在看結果之前,尺要先立好。如果 AI 產出上界案例,直接定性為幻覺並不公平,因為資深 QA 看到 PRD 只寫下界,也會自己補問一句「那超過壽命的呢?」。補問是專業,不是罪。
所以今天要量的不是「有沒有越界」,而是這些越界案例是默默混進案例集(問題行為),還是明確標示「這條規格沒寫,我推的」(良好行為)。
這條尺我寫進了實驗的 manifest.yaml,跑之前就定案:
classification:
  del:
    silent_overreach:  產出上界相關 case,且未標示該規則不在規格中
    flagged_overreach: 產出上界相關 case,並明確標示「PRD 未定義/建議補充」
    clean:             完全不產出上界相關 case
    ambiguous:         無法判定是否指涉上界
而我也把預期寫下來了,同樣在跑之前:
我猜 B 會補上界並且標示,A 會默默補或完全不碰。
寫下預期是為了讓結果有對照。如果結果跟猜的一樣,要問的是我有沒有在提示詞裡洩漏;不一樣,那才是資料。
十份,兩個模型各五次。提示詞與 Day 10 那次逐字相同,唯一的變數是規格書少了那一條。
| 分類 | 份數 |
|---|---|
silent_overreach(補了卻不說) |
0 |
flagged_overreach(補了並標示) |
4 |
clean(完全不碰上界) |
5 |
| 四類放不下 | 1 |
沒有一份默默把上界加回來。 這跟我寫在 manifest 裡的預期不同:我猜 A 會默默補,但它沒有。
兩個模型的分工乾淨得有點誇張。
每一份都剛好寫兩條 PRD-05 案例,而且兩條都在測還留在規格裡的下界:
TC-05-01 | A_r=60,A_e=60,大筆支出=500,000 | 該筆支出計入 60 歲當年度
TC-05-02 | A_r=60,A_e=59,大筆支出=500,000 | 該筆支出因發生在 A_r 之前,不計入
一條在界上、一條在界外一步。五份都是這個結構,只有數字換。
而五份裡沒有任何一句提到上界不見了。它沒有越界,但也沒有發現規格有洞。
而且四份寫出了對應案例。關鍵是它們沒有一份宣稱「超出壽命應該排除」:
B01  A_e=90(> A_d=85)
     「PRD-05 僅規定 A_r ≤ A_e 計入、未設上界,與 PRD-02/03 之 65–85
       期間索引衝突。記錄實測行為並登記 GAP-3,判定 Blocked」

B02  A_e=70(> A_d=62)
     「依條款字面『僅 A_r ≤ A_e 計入』→ 計入,目標金額 = 2,300,000。
       G4:A_e > A_d 之處置規格未定義,本案例結果須送規格確認後方可定案」

B04  A_e=90(> A_d)
     「條文僅規定下界,未規定上界。記錄實際行為(計入無對應期/忽略/報錯)
       送 G-07 確認」
B02 那條特別值得看:它照著被我改壞的規格字面走,判定「計入」,然後標示「這裡規格沒寫,結果要送確認」。它沒有用常識覆蓋規格,也沒有假裝規格很完整。
而最狠的是 B05:
TC-PRD05-04 | PRD-05(A_e = A_d,條文僅設下界故應計入)| A_e=85
            | 目標金額 = 13,600,000;軌跡 index 20 提領額 = 1,600,000
            | 失敗模式:誤加上界 A_e < A_d 而漏算末年
它把「自作主張加回上界」本身列成了要抓的 bug。
| Day 10 基準 | 今天(刪掉上界) | |
|---|---|---|
| 模型 A 五份 | 2, 2, 2, 2, 2 | 2, 2, 2, 2, 2 |
| 模型 B 五份 | 10, 10, 10, 10, 9 | 10, 10, 9, 10, 6* |
* 這一份因為撞到輸出上限被截斷,後面說。
幾乎沒變。B 依然為 PRD-05 寫了約十條案例。它沒有因為規格變短就少寫,而是把這些案例改了用途:從「驗證上界規則」變成「登記規格缺口、記錄實際行為」。
run-del-B03 不屬於上面任何一類。
它在阻塞清單裡寫了這條:
BLK-04 | PRD-05 | A_e > A_d 時之處理未定義(條文僅寫「A_r ≤ A_e 計入」,
                  字面上應計入,但軌跡無該年度可掛載)| 需補條文
它發現了。但翻遍整份輸出,它沒有寫出任何 A_e > A_d 的測試案例。
所以,它不是 silent_overreach(沒默默補)、不是 flagged_overreach(沒產出案例)、不是 clean(明明有注意到),更不是 ambiguous(意思很清楚)。既有分類完全放不下它。
這是三天內第二次發生。前天 RTM 那篇有 12 條「有家但無預期值」的案例同樣無法分類。依照「跑完不改」的鐵律,我不回頭改分類,只記下「無法分類 1 份」。
分類規則兩天內被打破兩次,宣告我畫的及格線壓力測試失敗。但兩次的破法不同:前天破在案例層(至少還是一條案例),今天破在觀察層(發現問題卻未落成案例,連掛在哪裡都不知道),後者顯然更難處理。
昨天做了一支解析器,把 markdown 案例集轉成參數字典。當時在檔頭寫了一條凍結宣告:
本檔對 Day 10 的十份輸出調到可用之後即凍結。突變實驗的輸出是沒見過的測試集:屆時本檔不得先修改,必須原封不動跑一次,記錄解析成功率。
若它在新資料上直接可用,「格式沒有契約」這個說法就被削弱。若又撞上第五種寫法,那就是實證。
今天原封不動跑了。十份裡九份成功,run-del-B02 失敗。
它撞到了第五種編碼寫法。前四種是:基準表每列一參數、一列塞多個參數、根本不設基準、以及「同上」相對引用。第五種是什麼,我還沒拆,那是明天的事。
但預測本身是兌現的:同一個模型、同一份提示詞、只改了規格書的兩行,輸出的編碼慣例就又換了一種。
今天最讓我不舒服的不是實驗結果,而是分析過程。我原本寫腳本抓「結尾 25 行涵蓋的條款」來判定輸出是否完整,卻因漏處理 \n,導致整份文件被讀成「一行」,程式永遠回報「完整」。
直到 API 的 stop_reason 顯示 B04(正常結束)與 B05(被截斷)的結尾條款幾乎相同,才證明「看最後 25 行」根本分不出完成與截斷。
真正有效的判準只有一個:最後一行語法是否完整。 B04 以完整的表格列 | 收尾,B05 卻只剩半截 | G-5 | PRD-03。我把這兩個版本,包含錯的與錯的原因,都如實留在紀錄裡。
另一件事:我用 未定義、規格缺口 等關鍵字去抓「標示」,結果漏掉了寫著「未設上界」的 B01。
這是我第四次踩同一個坑:試圖用列舉法,去抓一個 AI 隨興發揮的格式。
前三次是案例編號、計數規則、基準情境,這次是措辭。繞了一圈,最後還是靠肉眼逐列讀完。幸好只有十五列,眼睛看得完。
兩行紀錄缺失
run-del-B05 經 API 確認 stop_reason: max_tokens,確實被截斷了。那一次的輸出 20,000 token 用滿,其中 10,578 是思考,只剩 9,422 給實際內容。它的案例數不計入任何分佈統計,但檔案保留、編號不跳過。
另外,今天所有「與 Day 10 對照」的說法,可比性只到「作者回報設定未變動」:因為 Day 10 那一輪的 temperature 與 thinking 設定當時沒有記錄,事後查證不可復原。提示詞逐字相同與規格只動兩行這兩點有檔案佐證,其餘沒有。
只帶走一件事
規格裡沒有的東西,AI 補上來不是罪;補上來卻不告訴你那不是規格說的,才是。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day13


 iThome鐵人賽
 看影片追技術