
當 Agent 回覆變慢,值班的人通常會先看:只是某一筆慢,還是整個服務都慢了?如果同一個時間有很多請求一起變慢,可能先從流量和延遲趨勢下手。如果只有一筆出問題,就需要展開那次呼叫,看時間花在模型、Gateway,還是工具端。找到可疑步驟之後,再讀當時的事件紀錄,確認它正在等待什麼。
這就是 Metrics、Traces、Logs 在可觀測性裡的不同位置。它們可以共同描述一次問題,但保存的單位與查詢方法不同。先知道每一種資料適合回答什麼,後面才有辦法決定「使用者是誰」這類欄位應該放在哪裡。
本篇從三種訊號的用途開始,再帶入一個很常見的需求:能不能按團隊或成員查看 Agent 活動?這個篩選在介面上很簡單,資料進到不同後端之後,成本、敏感程度與可用的查詢方式卻不一樣。
**Metrics 是帶有時間的數值測量。**例如請求數、失敗數和延遲分布,適合看整體變化與建立告警。你想知道「這十五分鐘工具呼叫失敗率有沒有升高」,就不需要逐筆打開所有請求。先以服務、Route 或結果分組,看哪一類變化最明顯。OpenTelemetry Metrics 文件 說明了這類執行時測量的定位。
**Trace 展開一筆處理的路徑。**每個 Span 記錄一段操作的開始、結束與相關資料,父子關係將不同服務的操作連起來。Agent 一次回覆花了十秒,你可以沿 Waterfall 看是模型推論、Runtime 等待,還是工具呼叫耗時。它讓整體延遲變成可定位的步驟。OpenTelemetry Traces 文件 可以對照 Span 與呼叫關係的定義。
**Logs 保存某個時間發生的事件。**找到慢的工具呼叫後,你可能還想知道它查了哪類資源、遇到什麼錯誤、是否進入重試。這些細節通常寫在事件紀錄裡。若事件使用穩定的欄位,例如操作 ID、錯誤類型與結果,就能更可靠地查詢和關聯。OpenTelemetry Logs 文件 也強調,結構化紀錄的價值在一致的欄位語意,並非只要輸出 JSON 就足夠。
三者可以沿著同一個排查過程使用:先從 Metrics 找出異常範圍,再挑相關 Trace 展開路徑,最後用 Logs 讀取步驟細節。這不是固定的操作順序,有時收到某筆錯誤事件就會直接查 Trace,但各自回答的問題仍然不同。
| 想知道的事 | 優先查看 | 本系列使用的後端 |
|---|---|---|
| 哪些 Route 的錯誤率正在增加? | Metrics 的聚合趨勢 | Lab 用 Prometheus,既有平台也使用 Mimir |
| 某次 Agent 操作慢在哪一步? | Trace 的 Span 路徑與耗時 | Tempo |
| 那個步驟當時發生什麼事? | Logs 的事件內容 | Loki |
Grafana 提供查詢與視覺化介面,Alloy 收集並轉送資料。把訊號接到同一個畫面,可以減少切換工具的負擔,但底下仍然是各自有儲存與查詢規則的系統。
我在做 Claude Code Stats 類型的使用分析時,會需要按 Team、Member、Model 和 Activity 切資料。例如團隊想知道這週哪些活動增加,也可能從某位成員的工作紀錄找回一次工具操作。這兩種需求都合理,只是需要的細節不同。
若只想看團隊的請求成功率,team 就可能足夠。如果正在調查某次操作,才需要能找到特定行為主體的參照。把 Email、使用者 ID、Session 和所有身分欄位一口氣複製到每種訊號,雖然方便開發,卻讓所有後端都承擔單人查詢的成本與暴露面。
因此我會先寫下查詢目的,再決定欄位。團隊趨勢使用受控的團隊維度,單次調查保留操作 ID 和必要的主體參照。若只是想知道模型使用量,就不因為資料來源剛好有 Email 而一起保存。
這裡還有一種需要獨立考慮的用途:Audit。它要追查誰代表誰、依據哪份規則執行,以及最後產生什麼影響。Audit 是事件的用途與保存要求,可以使用結構化 Log 承載,但不會因為放進 Loki 就自動具備完整的稽核可信度。
查詢需要使用者資訊時,先要知道它從哪裡來。JWT 裡的 sub 是 Subject,通常用來識別主體。單純解開 JWT、看見 sub 和 team,仍不知道 Token 是否由可信來源簽發,或是否允許用在這個服務。
入口需要檢查簽章、簽發者、接收對象與有效時間,再依組織的欄位對應規則建立 Principal Context,也就是後续服務可使用的身分脈絡。驗證過後,仍應只傳遞執行所需的資料,觀測系統也只取得符合查詢目的的部分。這一步在圖中稱為 Projection,可以理解成「為每個用途挑出需要的欄位」。
先看圖左邊的原始 Claims 如何通過驗證,再看右邊分到不同資料面的欄位。分流的重點是每個目的地有自己的允許清單,不共用一份全部欄位的 Attributes Map。
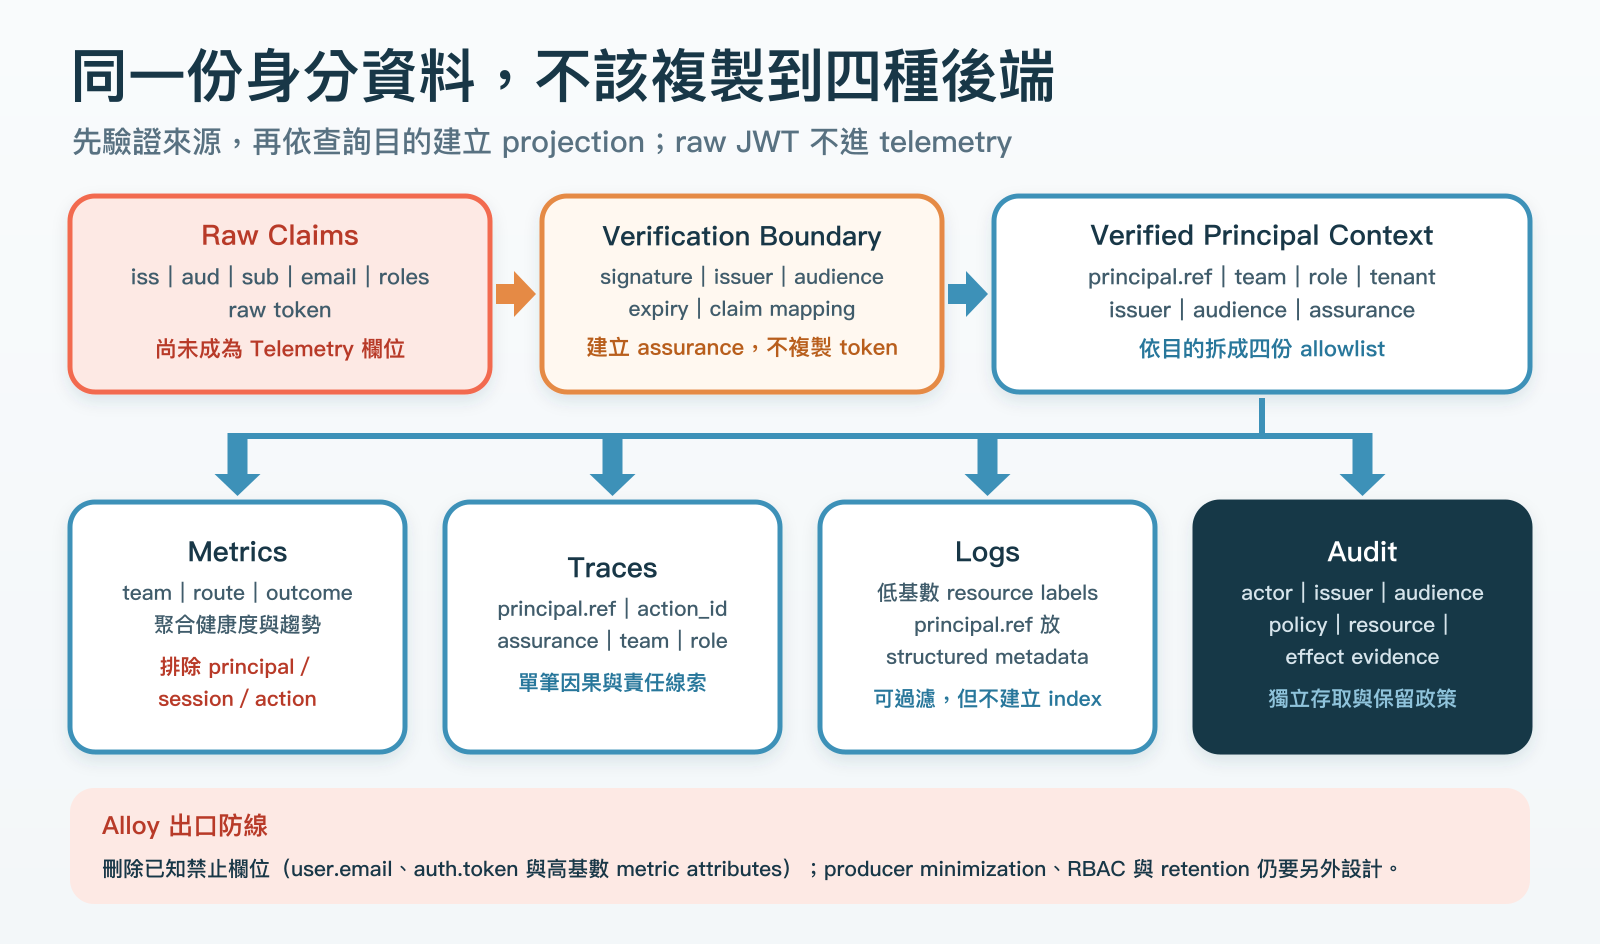
例如 Runtime 為了執行授權,需要知道主體和可用權限。Trace 調查可能只需要主體參照、團隊和操作 ID。Audit 則可能還要保留簽發來源與判斷依據。這些資料不必都跟著每次網路請求散布到所有系統。
本篇用 principal.ref 表示可關聯的主體參照。示範以 HMAC-SHA256 將 Subject 轉成參照值,讓 Trace 和 Log 不必直接保存 Email 或原始 Subject,也能對回同一個主體。HMAC 使用 Key 計算,所以需要管理 Key 的讀取權限,變更 Key 時也要考慮歷史紀錄的查詢方式。
這是化名化,仍然可以透過既定關聯查回同一個人,不能當成匿名資料。能查單一主體的人,也不應自然等同於所有能看團隊用量的人。
Metrics 的分組欄位叫 Label。在 Prometheus 中,Metric 名稱加上一組 Label 值,識別一條時間序列,也就是這個組合隨時間累積的數值。增加新的 Label 值組合,就會增加新的序列。Prometheus Data Model 定義了這個關係。
例如把操作數按 team、route 和 outcome 分組,你能比較各團隊在不同入口的成功與失敗。若團隊和 Route 是受控集合,可能的組合就能估算。再加上每次都不同的 action_id,即使只想看成功率,系統也得先保存大量只對一筆操作有用的序列。
這裡的 Cardinality,指的是不同 Label 組合的數量。以假設的三個團隊、兩個 Route、兩種結果為例,最多有十二個組合。若再加入一百個使用者,組合上限就再乘上一百。實際出現多少取決於流量,但這個例子說明了為什麼身分維度會放大成本。
因此我會讓 Agent 健康指標先保留有限的分組,單人活動查詢另用事件或產品歷程。把使用者 ID 改成 Hash 或 HMAC,可以降低直接暴露,卻不會減少不同值的數量。每人一個參照,對 Metrics 來說仍是每人一個維度值。
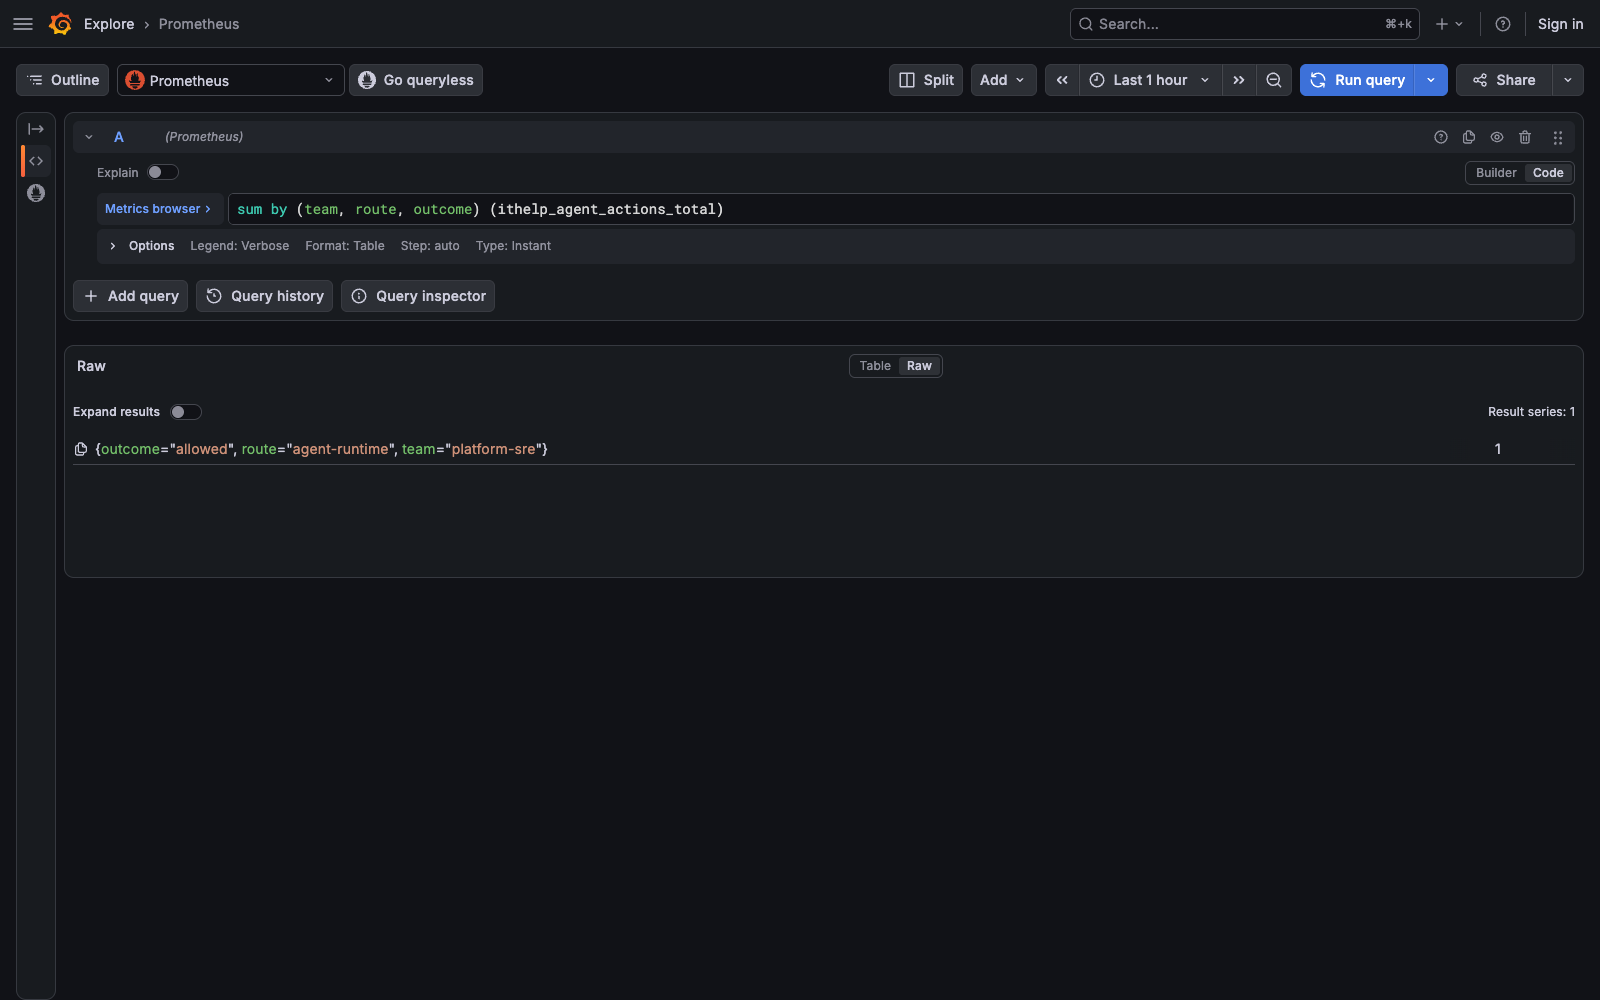
以下查詢以 Team、Route 和 Outcome 查看操作總數。它關心的是一群操作的分布,並不需要每次操作的 ID。
sum by (team, route, outcome) (ithelp_agent_actions_total)
只在 Dashboard 不顯示某個 Label,也無法消除已寫入的序列。欄位必須在資料落地以前移除,歷史資料則依後端保存政策處理。
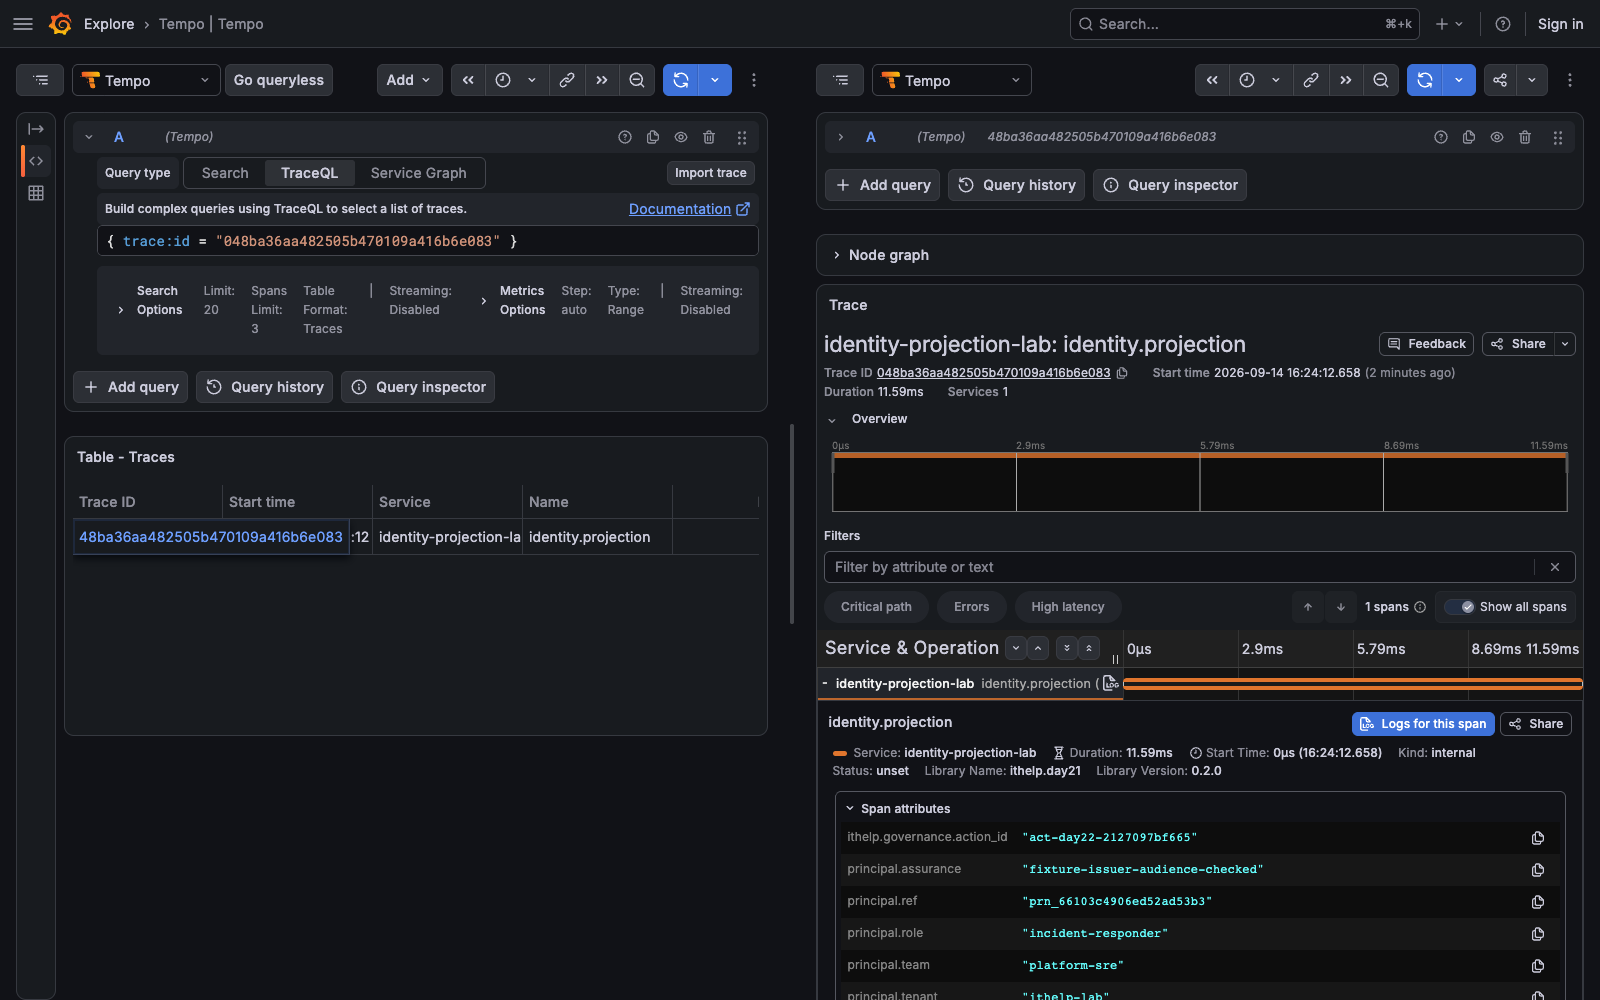
調查單次操作時,action_id 和 principal.ref 就有不同的價值了。前者找同一次操作,後者找同一個主體的相關紀錄。Trace 可以保留必要的參照和身分來源資訊,讓調查者確認這次操作來自哪個團隊、使用哪種身分脈絡。
這些欄位是搜尋線索,是否可信仍取決於入口驗證與資料產生者。尤其不要把 Trace Context 當成身分傳遞通道。traceparent 提供呼叫關聯,OpenTelemetry Baggage 的安全說明 則提醒,額外資料可能傳到不受信任的下游。Raw JWT、Email 和憑證都不適合為了除錯方便塞進 Baggage。
Log 也能保存主體參照,但在 Loki 還要區分 Index Label 與 Structured Metadata。Index Label 用來選取 Log Stream,一組不同的 Label 值會形成不同 Stream。若把每位使用者放進 Index Label,就會讓紀錄按人切成大量 Stream。Loki Labels 文件 說明了這種分組方式。
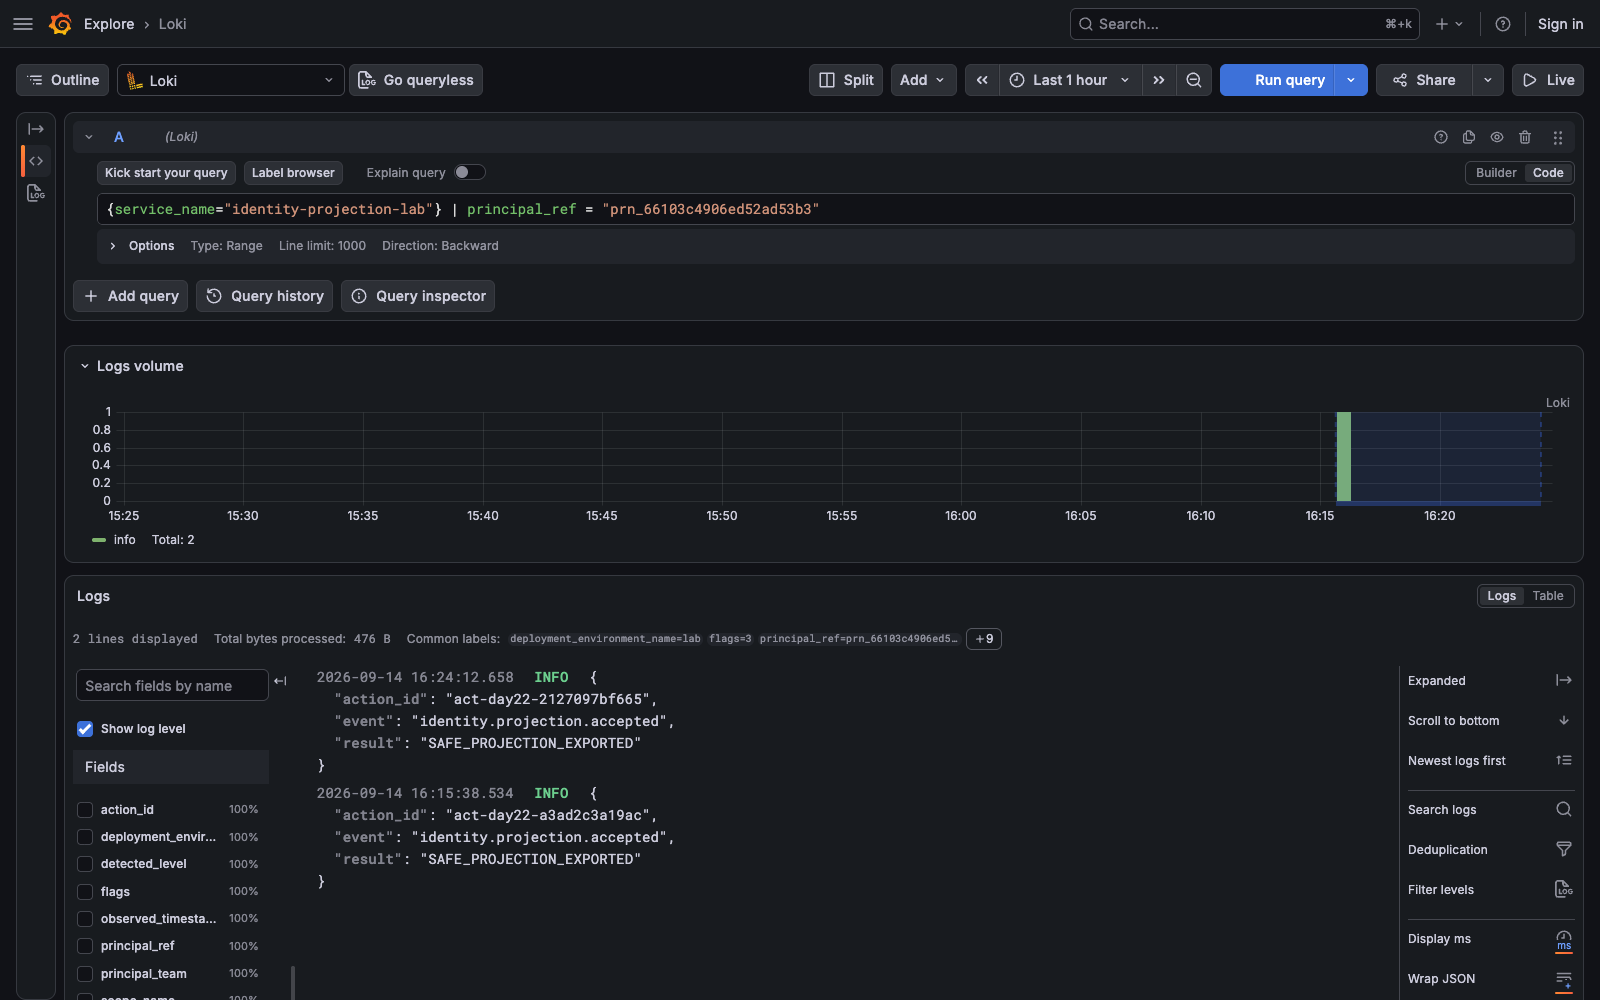
Structured Metadata 則保留每筆紀錄的結構化欄位,查詢時先用服務等有限維度選 Stream,再過濾主體參照。這樣能保留單筆查詢能力,同時避免以主體值建立額外 Stream。下面的 LogQL 先選服務,再篩選 principal_ref。
{service_name="identity-projection-lab"}
  | principal_ref = "prn_66103c4906ed52ad53b3"
Loki OTLP Ingestion 文件 說明 Attributes 到 Index Label、Structured Metadata 的對應方式。欄位名稱中的點號也會正規化成底線,所以 principal.ref 查詢時寫成 principal_ref。實際哪些欄位進索引,仍要核對後端設定。
Metadata 仍然佔儲存空間,也仍能關聯到個人。因此權限、保存期限和刪除流程都要處理。若沒有單一主體查詢需求,連這份參照都可以不送。
對稽核或事件調查來說,團隊趨勢和一條 Trace 還不足以解釋授權。例如某次刪除被放行,需要知道當時的行為主體、代理關係、規則版本與目標資源,還要查到工具回報的效果。這份事件應由能提供對應證據的元件寫入,並有明確的讀取與保存規則。
完整責任鏈不需要附上一整顆 Bearer Token。Raw JWT 可能仍可拿來呼叫服務,長期保存也會帶進不必要的原始 Claims。通常應保存驗證結果與必要的來源參照。若另有 Token 關聯需求,才設計受控的 Fingerprint 和保存期限。
把前面的用途放在一起,我會先用這樣的欄位分工,再依組織的資料分類調整:
| 用途 | 本篇保留的身分線索 | 避免直接放入的資料 |
|---|---|---|
| Metrics 聚合 | 受控的 team 等有限維度 |
個人、Session、Conversation、操作 ID |
| Trace 調查 | principal.ref、操作 ID、必要的身分來源與團隊資訊 |
原始 Token、Email |
| Log 搜尋 | principal.ref、操作 ID,以 Metadata 保存必要細節 |
原始 Token、Email、每人一組 Index Label |
| Audit 責任追查 | 主體參照、代理與身分驗證依據,再關聯規則和效果 | 原始 Token、不必要的完整輸入輸出 |
這是查詢目的導出的設計,並不是法規範本。完整欄位表留在 Identity field placement matrix。Audit 與 Operational Logs 可以用 ID 關聯,讀取角色和保存期限仍然能分開。
Lab 04 README 沿用 Alloy 和 LGTM,故意將合成 Email、Token、主體參照與 Session 欄位送進 OTLP,再直接查 Tempo、Loki 和 Prometheus,確認每種資料真正留下了什麼。讀者不必先跑 Lab,下面只看兩個容易被忽略的結果。
第一個是 Metric Label。最初 Producer 送出 principal.ref,Alloy 只刪 Email 和 Token,Prometheus 就真的收到了 principal_ref。敏感欄位清掉了,高基數欄位卻還在。修正時必須在 Metric Datapoint 離開 Collector 前,移除 Principal、User、Session、Conversation 和 Action ID,再清除示範環境的舊資料重跑。
下圖對照前面的 PromQL,查看操作數的預定分組。結果只保留 Team、Route、Outcome 這些業務聚合維度,沒有用個人或操作 ID 拆分。
Trace 則保留主體參照、Action ID,以及示範的 Assurance、Team、Role 和 Tenant。這些欄位讓單次調查可以關聯必要背景,不需要直接使用 Email 或 Token。
在 Loki,用前面的 LogQL 可以從服務 Stream 找到指定主體的事件。展開紀錄後,主體參照在 Structured Metadata,並沒有成為每人一條 Stream 的索引維度。
第二個意外出現在 Log Payload。Python Logging SDK 自動加入本機 code.file.path,雖然它不是 Identity Claim,仍沒有送到公開後端的必要。這提醒我,資料盤點不能只看程式手動加入的欄位,SDK 自動補的來源路徑與其他 Metadata,也要從實際後端查回來檢查。
這份 Lab 另外產生 audit-event.json,留下主體參照、角色、Tenant、Issuer、Audience、Assurance 和操作 ID,尚未完成完整稽核儲存系統。身分來源也是合成 Fixture,本篇沒有用 Gateway 驗證真實 JWT。下一篇才檢查經 agentgateway 驗證的 Claims 如何投影到觀測資料。
Alloy 在示範中依訊號刪除禁止欄位,可以作為第二道檢查。但它看見 assurance=VERIFIED,不代表它親自驗過 Token。欄位的可信來源仍要由入口和 Producer 交代,Collector 負責的是已定義的資料處理。
明確刪除 user.email 和 auth.token,也不能保證抓到未來新增的 customer_email 或自由文字裡的敏感內容。我會先讓 Producer 按目的地使用允許清單,避免原始 Claims 進入觀測 API,再由 Alloy 處理已知禁止欄位。後端驗收則直接檢查寫入後的欄位,而非只確認設定檔裡有刪除指令。
部署時還要把欄位和使用方式一起管理。誰能查單一主體?資料保留多久?HMAC Key 輪替後,歷史事件怎麼關聯?需要匯出或刪除時,由哪個角色處理?這些答案會影響參照值、後端權限和保存策略,應該在資料落地前決定。
本篇先讓團隊趨勢、單次調查與責任追查各自取得需要的資料。下一篇把篩選需求放回真實 Gateway 流量,分別使用 Team、User 和 Conversation 維度,看看看似只是多一個篩選條件,究竟增加多少 Metric Series 和 Log Stream。



 iThome鐵人賽
 看影片追技術