
Day 30 · W4 · AI 線 · 難度 ★☆☆☆☆
本系列由 AI 協作撰寫。 本篇初稿與查證由作者和 Codex 協作,發布前由作者確認。完整系列協作模式見 Day 01。
把第一篇重新打開,拉到最後,我看到自己答應的四樣東西:AAA 標章案例、開源 CLI、三十篇文章,還有一份教人用 AI 做領域工具的 playbook。
今天輪到把它們放回桌上。寫到最後一天,最容易多講一些感想,少交代一個入口。讀者卻可能正停在那裡:故事看完了,接下來去哪裡拿?
這三十天最後要交付的,是一把讀者拿得到、查得出依據,也看得見限制的工具,以及做出它的方法。
第一樣是自家網站的 AAA 標章案例。Day 28 已經把送審意見、網站修改與工具跟進的時間放在一起,包括網站先修好、工具當時還沒補上的例外。要查這個案例,從那篇進去就能找到過程。
這份紀錄的價值,在於同一個問題有了外部意見可以對照。工具自己跑出綠色時,我曾經相信它;收到意見後,才有機會追查它究竟漏看哪裡。送審結果有當時的範圍,後來的工具也有自己的檢查條件,兩者都值得留下。
第二樣是開源 CLI。GitHub 程式庫 放原始碼與使用說明,PyPI 套件頁 提供安裝入口。發版時容易漏掉的使用者視角,整理在 Day 27。你可以使用,也可以從原始碼追查某個判斷怎麼來。
第三樣是這份連載。iThome 系列頁 保留發表順序。第一次接觸的人可以從頭讀;只想查焦點、對比或 AI 驗收的人,也可以從篇名找到需要的內容,再沿著文中的連結回查相關案例。
第四樣是 AI 協作開發工作手冊。我把散在各篇裡的做法整理成可以照著填的步驟:先選問題、留下判準,再準備測例,最後把結果與限制交給下一個人。手冊已作為 iThome 系列附錄發布,方便使用時回查。
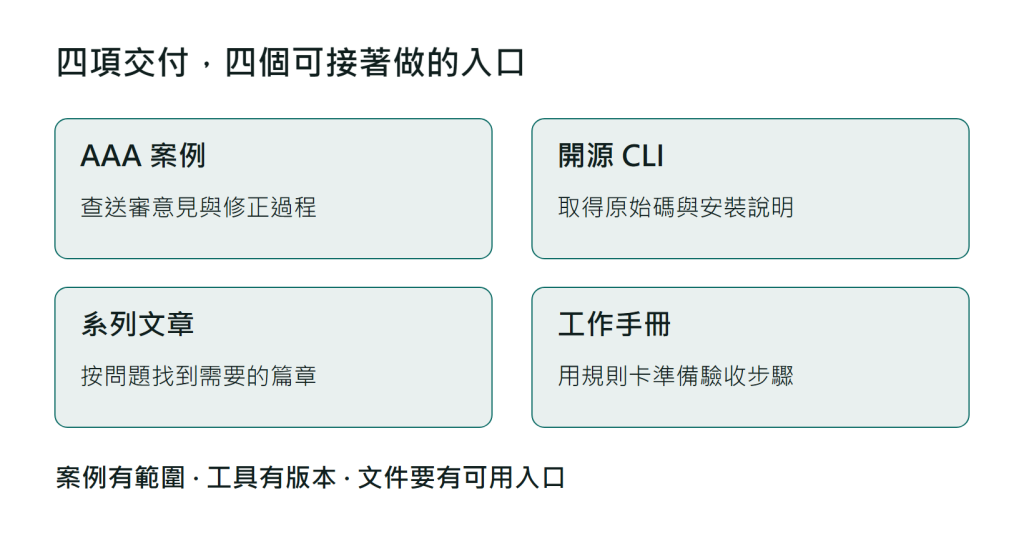
四樣東西各自回答一個問題:發生過什麼、怎麼使用、去哪裡讀,以及換成自己的題目時怎麼開始。
我把這張清單當成交屋時的點交單。鑰匙交出去以前,要確認每一扇門真的打得開。對文章來說,那扇門就是連結;對工具來說,則是讀者能照著走的使用說明。
系列開頭最醒目的那句話,是我前端出身、不寫 Python,卻交出了一個 Python 套件。我原本以為,這個故事最值得解釋的是實作怎麼完成,結果寫到後來,花最多篇幅的反而是判斷怎麼成立。
AI 可以產生一段看起來合理的檢測,讓它執行、輸出報告,甚至替報告寫解釋。只看這些產物,很容易以為工作已經走完。可是我仍得打開頁面,確認那顆按鈕在哪個狀態、焦點落在哪裡,以及拿到的顏色是不是畫面上真正相鄰的顏色。
Day 08 問「Python 一行都不是我寫的,那我到底在做什麼」。走到這裡,我能回答得更具體:我得決定什麼證據足以接受一個結果,並為這個決定找得到理由。
這份工作有時很小,只是拒絕一個沒有來源的閾值;有時很麻煩,得承認原本的成功數字回答錯了問題。AI 讓實作變得比較容易取得,於是這些原本藏在程式背後的選擇,更需要被寫出來。
我也沒有因此免除理解程式的責任。
當結果跟預期不同,仍然要追查輸入、執行路徑和輸出。遇到超出能力的地方,就需要能覆核的人。交付一個別人會使用的工具,這些工作省不掉。
如果只能從三十篇帶走一個做法,我會選「先寫下怎麼驗收,再請 AI 動手」。這句話在開工前聽起來很普通,真正困難的是結果不合期待時,還願不願意照原來的判準檢查。
Day 23 把修復前後的報告留下來,讓「修好了」有可追查的對照。這樣做也會暴露不漂亮的部分:總數下降以外,還要看哪些問題消失、哪些仍在,以及有沒有新問題。需要人工確認的項目,仍得有人打開來看。
我希望接手的人不用先相信作者,就能從紀錄找到重做的方法。知道在哪個版本、哪個頁面狀態下取得什麼證據,才能判斷結論是否還適用。少了這些條件,即使一句「已驗證」寫得很肯定,也很難接著做事。
至於工具判不了的部分,Day 29 已經留下原始報告、指定範圍的覆核結果與未完事項。最後一篇不會讓那些限制消失。它們會跟工具一起交出去,成為下一次使用時需要看的資料。
假設你熟悉的工作是檢查匯入資料,第一個題目可以小到「這個日期欄位是否符合約定格式」。先寫清楚允許哪種格式、空值怎麼處理、時區由誰決定,再挑幾筆你確定答案的資料。這只是起手示例,實際判準仍要回到你的需求。
工作手冊裡的規則卡,要求你填來源、範圍、操作定義、需要的證據與驗收者。填不出來的地方值得先停一下:它很可能正是 AI 接下來會替你猜的地方。把歧義在小範圍內攤開,比做完一整套系統後才發現各自理解不同,容易處理。
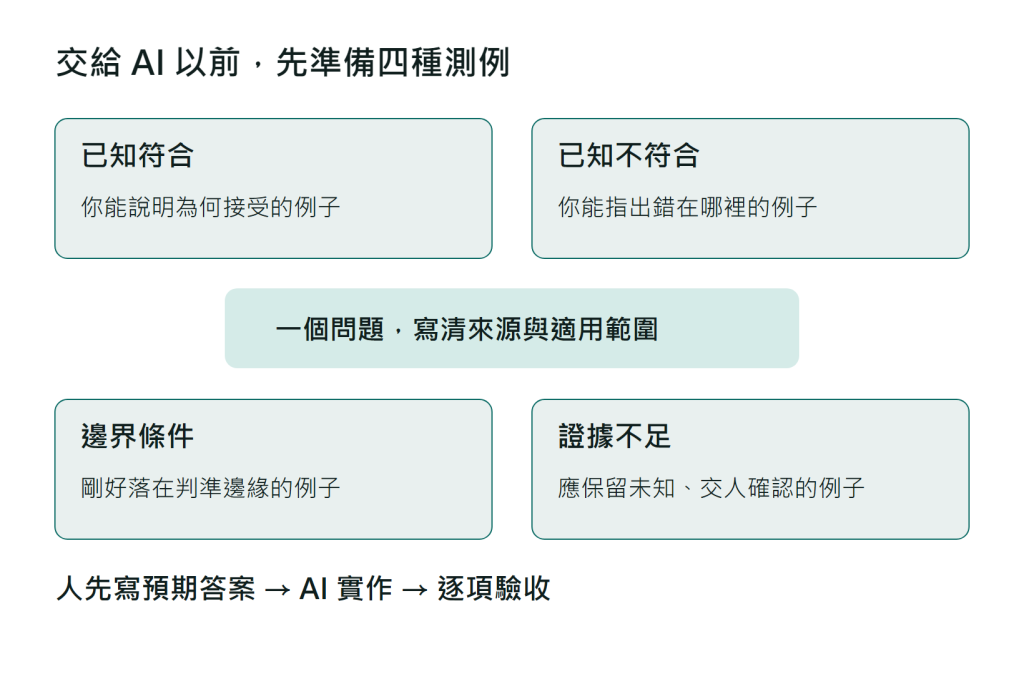
四種測例是準備工作的起點。若你還無法說明其中一種情境應得到什麼答案,就先補判準或找人確認。
這些答案要在看見 AI 的實作以前先寫。
否則很容易順著它的輸出修改期待,最後只證明程式跟自己的測試說了同一句話。等第一條路徑可以驗收,再決定是否擴大題目;不必一開始就承諾自動處理整個領域。
如果你想從本系列的工具練習,在已安裝 a11y-moda 的環境裡,可以先查一條圖片替代文字相關規則:
a11y-moda rules show HM1110100C
這個指令查的是規則資料,沒有掃描網站。讀完描述後,回到它引用的依據,想想你準備的例子是否落在適用範圍,再決定要怎麼驗收。第一次動手不需要得到一份漂亮的全站報告,先把一個問題問清楚就有進展。
謝謝你讀到這裡。不論你一路跟著看,或只是搜尋某個問題時點進來,我希望這份連載至少留下了一次可以接著做的動作:查一條來源、重跑一個例子,或重新問一句「這個結果,憑什麼接受」。
這次我把熟悉的網頁工作,交給自己不常使用的語言去實作。一路上最需要補的,是那些原本以為不用說明的判斷。把它們寫清楚以後,AI 才比較知道要做什麼,下一位使用者也才有機會檢查我做得對不對。
三十天的連載到這裡。工具、案例與方法都留在前面的入口;如果你準備開始自己的題目,就先寫下那個你願意負責驗收的問題。
這系列的發想跟規劃,從一開始決定要使用 CLI 與 AI 協作來闖關 AAA 無障礙標章時,就開始了。也就是今年的 4 月左右,每次施作時,都請 AI 記住每一個測驗結果跟流程,包含所有的對話。
最後通過 AAA 標章時,請 AI 整理出整體的架構跟標題,準備參加今年的鐵人賽。
每年看到大家如火如荼地參與鐵人賽,都十分佩服各位。
畢竟要準備一大堆數據及文字,是需要很多力氣的。這次藉由 AI,以為應該會很輕鬆。
但實際使用的結果,連續 30 天,加上中間間隔造成的遺忘,不只是我,就連 AI 都忘記中間的一些過程跟數據。
重新用已通過標章的官網去驗證,加上無障礙規範改版,數據反而變得一團亂。不斷調整 AI 寫作的細度,才慢慢達到我覺得比較滿意的程度。
下次應該要規劃更細一點。不只是標題跟粗略的摘要內容,連每篇的架構都要一起想進去才是。
感謝各位被 AI 文轟炸到現在,能完整參與,已經很滿足了。
謝謝各位。


 iThome鐵人賽
 看影片追技術