

當專案逐漸有畫面、API、資料庫與測試,任何一個問題都可能牽涉多層程式。但把所有檔案一次塞給 AI,既花時間,也讓真正有用的線索淹沒在雜訊裡。今天要練習的是資訊選擇:先找任務相關入口,再沿資料流擴展,而不是要求工具記住整座 Repository。
若 Issue 是「編輯任務後標題沒有更新」,第一輪 Context 應包括重現步驟、PRD 的編輯驗收、清單與更新入口、相關測試,而不是所有設定檔與歷史討論。若第一輪顯示資料寫入成功、畫面仍舊,下一輪再讀狀態更新與快取;若寫入本身失敗,才往伺服器與資料層追。Context 會隨證據改變。
README、架構說明和 AGENTS.md 是導航圖,不是程式真相。文件可以告訴代理從哪裡開始,但實際行為要以當前程式和測試核對。若文件說使用 PostgreSQL、程式卻指向另一種儲存方式,就應回報不一致,不要硬套舊架構。這也是維護文件的理由。
第一步請 Codex 摘要它打算查的入口與原因,不立刻改碼;第二步只讀相關模組,畫出最短資料流;第三步列出仍缺的資訊和最小下一步檢查;第四步才根據證據改動與驗證。每一步保留檔案與指令來源。這種分階段不是儀式,而是防止代理在缺資料時把推測當事實。
跨多輪任務時,我會維護一段短交接摘要:目前目標、已確認的事實、被排除的假設、尚未解決的問題、下一步檢查。摘要只收錄可追溯的結論,不把每輪聊天原文全貼進去。需要精確細節時,再回到檔案、測試與 diff,而不是依賴摘要記憶。
一段好的交接摘要可能寫:「已確認編輯 API 回傳成功,資料庫標題也已更新;清單重讀後仍顯示舊值;尚未檢查前端快取失效。下一步讀清單資料取得與狀態更新。」它沒有把未查的快取當根因,也讓下一個人知道從哪裡開始。若摘要只寫「應該是前端問題」,接手者很難判斷這句話有多少證據。
每當任務跨天,我會把摘要與當前 commit、相關測試一起保存。這不代表每次都要貼出完整聊天歷史;歷史可能含大量已推翻的假設。把當前有效資訊和原始證據分開,既能減少重複閱讀,也比較不容易讓 AI 重走已證明錯誤的路。
我會比較兩種任務交付:一種只給 Issue,讓工具自行搜尋;另一種附上精準入口與驗收文件。觀察它查閱多少不相關檔案、是否引用過期說明、是否對缺失資訊做出猜測,以及完成同一任務需要幾次人工補充。檔案讀得少不是目的,讀對檔案才是。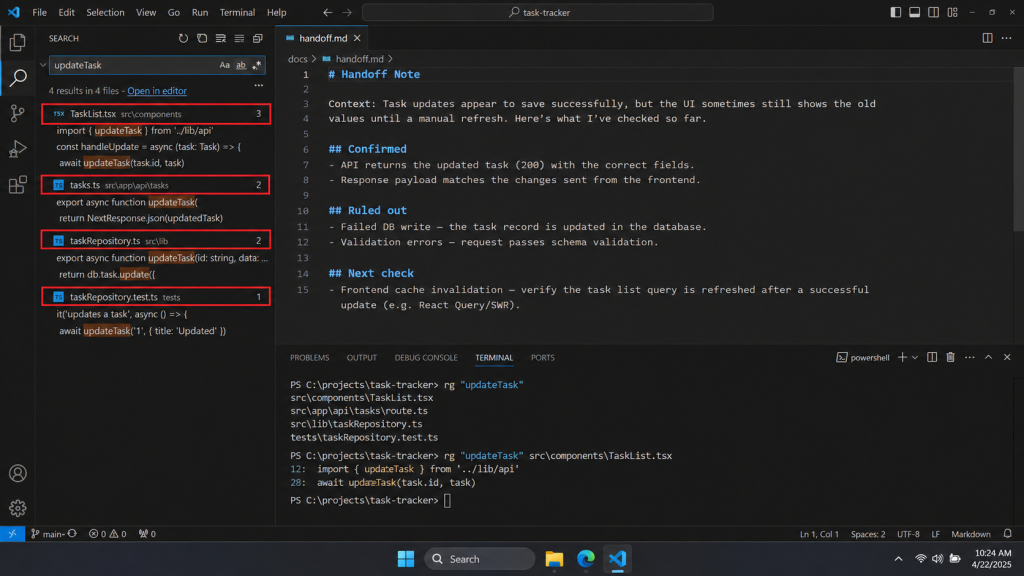
本文建立了按證據逐步擴充 Context 的流程。尚無大型 Repository 的實測讀檔數或效果數據,不能宣稱它已降低成本或錯誤率。後續會用同一個 Issue 比較兩種交付方式,再決定哪些摘要值得長期保留。
管理 Context 的核心不是讓 AI 看得越少越好,而是讓每次讀取都回答一個明確問題。明天把前面產生的修改交給另一個 AI Review,看看多一雙眼睛能發現什麼。


 iThome鐵人賽
 看影片追技術