

當 Codex 交回一個能跑的功能,下一步不是立刻合併。另一個 AI 可以幫忙找漏洞,但如果兩者共享同一個錯誤假設,也可能一起自信地說「沒問題」。今天把 Day 11 的編輯功能當成審查對象,設計一個有證據門檻的 Review。
只貼最終畫面不夠。審查輸入至少要有 PRD 的編輯驗收、實際 diff、相關測試與修改背景;若有資料庫變更,還要看 Migration 與回復方式。ChatGPT 可以檢查邏輯、邊界、錯誤處理與測試缺口,但沒有看到的檔案不能假裝看過。對任何發現,都要指出具體程式位置、會怎樣失敗、怎麼重現。
「請以 Reviewer 身分審查以下需求、diff 與測試結果。只回報有具體依據、可能影響正確性、安全或維護的問題。每項包含位置、觸發條件、實際影響、修正建議與可驗證方法。若證據不足,請標示待確認,不要把風格偏好寫成 Bug;也請指出目前測試未覆蓋的高風險情境。」
這份指令要求先找問題,也限制誤報。假設 Reviewer 說「可能有 SQL Injection」,但修改根本沒有自行拼接查詢,這項不能只因聽起來嚴重就採納;要回到實際資料存取方式查證。反過來說,若它指出前端取消編輯後仍送出更新請求,能提供對應程式路徑與重現步驟,就應優先處理。
如果 Review 清單全部都是「變數名稱可以更清楚」「可以抽成共用函式」,卻漏掉空白標題能覆蓋原資料,那它沒有完成這次任務。反過來說,若它列出十幾項可疑問題,但每一項都沒有觸發條件,人類仍得從頭調查。好的 Review 應少而準,優先指出能讓使用者看見錯誤結果或讓資料不一致的缺陷。
我也會記錄誤報成本:每一項建議需要多少時間查證、最後是否成立,以及採用後是否引入新問題。若讓另一個 AI Review 的總成本高於它節省的返工,就要調整輸入、縮小審查範圍,或把特定問題交給自動化測試。這樣才能回答「雙 AI 互查」是否真的有價值。
我會把意見分成已確認缺陷、合理但待驗證、純偏好三類。已確認缺陷補測試並修正;待驗證的先做最小重現;純偏好只有在改善一致性且成本合理時才考慮。Review 的目的不是把所有建議照單全收,而是提高修改品質,同時避免引入範圍外重構。
最後仍要人工檢查整體改動:原需求是否達成、diff 是否清楚、測試是否真的執行、是否有兩個 AI 都忽略的使用情境。若 ChatGPT 和 Codex 給出相同結論,也不能把「兩票贊成」當證據;它們可能看到同一份不完整的上下文。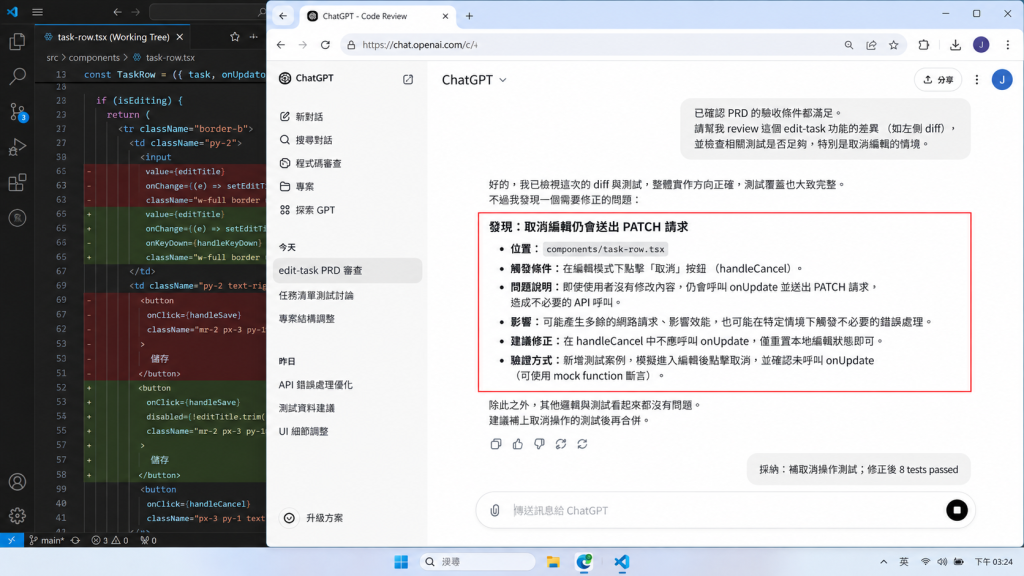
目前完成的是 Review 輸入清單、Prompt 與採納標準;沒有實際程式差異,因此不會虛構 AI 找到了幾個 Bug。待 Day 11 的實作存在後,才會用真實 diff 執行審查,並保留誤報案例,避免只展示成功的建議。
第二個 AI 可以幫忙擴大檢查視角,但不能替人類完成事實核對。下一篇會延續這個原則:在功能不變的前提下,看看 AI 能否安全地重構程式。


 iThome鐵人賽
 看影片追技術