
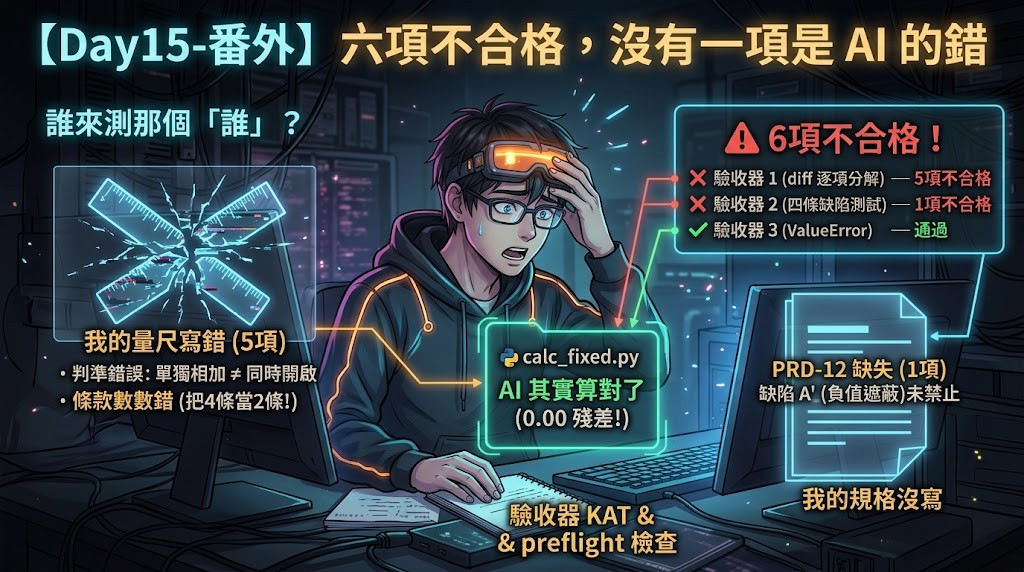
正文〈第一個問題:對著誰跑〉用一句話帶過了整個過程:
過程比結果曲折得多:第一輪沒過、我的量尺自己出錯、規格被逼出第十二條。
這篇寫那個過程。不是實驗結果,是踩坑紀錄。
這個系列問了十五天「AI 寫的測試,誰來測?」——而這個問句預設了有一個「誰」。
今天那個誰是我和我的三道驗收器。六項不合格報出來的時候,每一項看起來都像「AI 出錯了」。
規格(PRD v1.1)與介面契約貼進隔離環境,模型吐出 calc_fixed.py,三道驗收器跑下去:
❌ 驗收器 1 diff 逐項分解:5 項不合格
❌ 驗收器 2 四條缺陷測試全紅:1 項不合格
✅ 驗收器 3 非法參數拋 ValueError:通過
共 6 項不合格,calc_fixed.py 不得進 repo
看起來是一場失敗。逐項追下去,6 項裡只有 1 項真的在產物身上。
驗收器 1 的規則是我事前寫死的:差值必須等於「只改 PRD-01」與「只改 PRD-02」兩個分支算子各自貢獻之和。
不合格的五組是 inc_labor_65、inc_labor_70、inc_both、def_c_ghost、def_c_ghost_far——三組跟退休後收入有關,兩組跟大筆支出有關。
而 PRD v1.1 相對 legacy 改動的條款有四條:除了 PRD-01(複利頻率)與 PRD-02(提領首年),還有 PRD-05(大筆支出上界)與 PRD-10(收入通膨基準年)。我在寫規則的時候把「改了哪幾條」數錯了。
補上另外兩個分支算子之後:
| 案例 | 實際差 | 2 條分解 | 4 條分解 | 殘差 |
|---|---|---|---|---|
inc_labor_70 |
3,003,631 | 567,684 | 3,003,631 | 0.00 |
def_c_ghost |
−1,193,639 | 567,684 | −1,193,639 | 0.00 |
def_c_ghost_far |
−3,428,202 | 567,684 | −3,428,202 | 0.00 |
inc_labor_65 |
3,006,735 | 113,537 | 2,840,588 | 166,147 |
inc_both |
1,409,607 | 0 | 1,328,658 | 80,949 |
三組歸零,兩組還是對不上。
inc_labor_70 閉合而 inc_labor_65 不閉合,兩者只差在勞保的請領年齡。這就是線索。
PRD-02 多算的那一年是 65 歲,而 65 歲那年剛好有勞保收入,那筆收入又受 PRD-10 影響——兩條款在同一個格子上相遇。inc_labor_70 之所以閉合,是因為勞保 70 歲才起領,新增的那一年沒有收入,就沒有交互項。
| 案例 | 單獨相加 | 四條同時開 | 產物 | 產物 − 同時開 |
|---|---|---|---|---|
inc_labor_65 |
2,840,588 | 3,006,735 | 3,006,735 | 0.00 |
inc_both |
1,328,658 | 1,409,607 | 1,409,607 | 0.00 |
單獨相加 ≠ 同時開啟,而產物與「同時開啟」逐位元相符。產物從頭到尾都算對了,是我的判準寫了一個不成立的假設。
我在 manifest.yaml 的 expectations 裡還寫著:
gate_1: 會過。PRD-01 與 PRD-02 在算式上互不相干,疊加應該成立
這句話是跑之前寫的,而它兩個部分都錯了——不只數錯條款數,連「互不相干」都是假的。
依 Day 10 立的規矩「跑之前定、跑完不改」,我沒有回頭改第一輪的判準。缺陷記進 execution_status,修正版另立實驗編號。
第一輪的產物,進入點叫 calculate_retirement,而契約要求的是 calculate。
我一開始以為是模型沒照契約走。翻回輸入才發現是我自己把那一行刪掉的。
起因是清洩漏。第一版貼上檔被我掃出 11 個洩漏關鍵詞,最嚴重的一條是規格書的「尚未涵蓋」一節直接寫著:
缺陷 B(壽命倒掛)與 A'(負值遮蔽)——⋯⋯它們本來就不是規格問題,是實作沒做好
四個缺陷被說出兩個。驗收器 2 的整個意義是「舊缺陷不得遺傳」,而輸入裡點名了其中兩個,那道門當場失效。
我重建了輸入,掃描歸零。但重建時,介面契約的程式碼區塊少了一行 def calculate(p: Params) -> Result:,而文字部分還寫著「公開以下三個 dataclass 與一個函式」。模型看到「一個函式」卻沒看到簽名,只好自己取名。
成因是我的掃描只做了一半:它檢查「不該有的字串在不在」,沒有檢查「該有的內容還在不在」。 第二輪改成雙向——must_not 26 項全為 0、must_have 18 項全在位,兩邊都過才放行。
驗收器 2 的不合格項是 test_defect_a_prime_clamp_hides_deficit 在產物上仍然通過,缺陷 A'(負餘額被夾 0)被遺傳了。產物寫的是:
balances_charted = tuple(max(0.0, b) for b in balances_raw)
這正是我跑之前猜中的那一項。但這個「猜中」很不舒服,因為模型把它列進了檔頭的 GAP 清單,還寫了理由:規格未定義此欄位的具體行為,採用 max(0, balance),因為通常圖表端不預期顯示負值餘額。
Day 10 立過一把尺:罪在不標示,不在推論。 依那把尺,這是好行為——它推論了,而且說了。依驗收器 2,這是不合格。同一個行為,兩把尺相反判定。我沒有回頭改任何一把,照實記在 execution_status 裡。
而模型是對的。去翻 PRD v1.1 的 PRD-03,邊界處置欄寫的是「禁止 Math.max(0, ...) 截斷真實餘額」——「真實餘額」是 balances_raw,balances_charted 那一欄規格從頭到尾沒有提過。
這不是 AI 讀不懂規格,是規格有洞。而缺陷 A' 是 Day 3 驗屍報告認定的四個缺陷之一,規格本來就該禁止它。閘門 1 裁決新增 PRD-12:
balances_charted必須逐項等於balances_raw,不得下限截斷。圖表要不要顯示負值是呈現層的事,計算核心不得代為隱藏。
代價看 golden 案例 def_ap_clamp(0 元本金、0 月存、月支出 3 萬):
| 年度 | 真實餘額 | v1.1 下的圖表 |
|---|---|---|
| 第 1 年 | −602,199 | 0 |
| 第 10 年 | −8,254,225 | 0 |
| 第 20 年 | −21,232,803 | 0 |
二十年全部被夾平。使用者看到一條貼著 0 的線,實際缺口是 2,123 萬。
這條規格的來源跟前面十一條都不一樣。 RC-01 到 RC-10 是我翻程式碼翻出來的,PRD-11 是我對照介面欄位發現的。PRD-12 是一個沒看過舊程式的模型,在照規格實作時撞出來的——不是被考古挖出來的,是規格自己被用一次才露餡。
不過有個懷疑沒解決:PRD-03 的條文「禁止 Math.max(0, ...) 截斷真實餘額」,在禁止的同時也把 max(0, ...) 這個寫法示範給了模型。所以我那個「猜中」有多少是模型的傾向、有多少是我自己種的,分不開。閘門 1 裁決不修改條文(那句話從 JS 受測物考古而來,改掉會跟 RC-05 與 Day 3 的敘述脫節),改為每一輪在 manifest.yaml 明列為效度威脅 VT-1。
規格升到 v1.2、介面契約補回函式簽名、量尺換成四個分支算子並改比「同時開啟」。同一個模型、同一個介面,唯一該變的是規格多一條。
✅ 介面契約:相符
✅ 驗收器 1 通過
✅ 驗收器 2 通過
✅ 驗收器 3 通過
產物這次寫的是 balances_charted=balances_tuple,還自己註明 # PRD-12: 圖表餘額保真。實測兩者逐項相等,末年皆為 −22,526,423。
「全紅」我逐條查過,怕是每條都拋例外造成的假象:
| 缺陷測試 | 紅的機制 |
|---|---|
a_prime_clamp |
AssertionError 於 assert r.balances_charted[-1] == 0.0 |
a_target_uses_ordinary_annuity |
AssertionError 於期初/期末年金比值 |
c_ghost |
AssertionError 於 with_ghost.target_fund > without.target_fund |
b_inverted |
ValueError——輸入在任何斷言執行前就被 PRD-04 擋下 |
最後那條仍是正確行為,但紅的機制與另外三條不同,記下來。
但這次的「猜中」沒有資訊量。 我跑之前寫「gate 2 會過」,它過了——可是 PRD-12 是我剛寫進去的明文,模型照做是應該的。真正有資訊的是第一輪那次:規格沉默的時候,它會自己做選擇,而且會告訴你。
還有一個沒猜到的。兩輪的 GAP 清單都是 5 條,第一輪的 GAP-1(balances_charted 未定義)被 PRD-12 補掉,符合預期;但第一輪那條 GAP-5「其他收入沒有對應的請領年齡參數」,第二輪它沒提,而規格在這一點上一個字都沒改。反過來,「多筆大筆支出落在同一年」第一輪沒提、第二輪提了,我兩輪都猜它會提。
temperature = 1,輸出本來就不是決定性的。同一份規格的缺口清單,跑兩次不一樣——單靠一次生成去盤點規格缺口是不夠的。
第一輪的 preflight 我問的是「你現在能使用哪些工具或功能?」,模型回了一篇產品功能簡介:網頁搜尋、圖像生成、程式碼執行、文件分析。
那是產品能力,不是本次對話的開關狀態。這份 preflight 不能當隔離證據。
第二輪改了問法,要求只回答這次對話的實際狀態,並附上 AI Studio 側欄截圖。證據齊了:Gemini 3.1 Pro Preview、temperature = 1、Thinking level High、六個工具全 OFF、System instructions 空白。Day 13 那兩行紀錄缺失(temperature 與 thinking 沒記錄)這次補上了。
但截圖跟模型自述對不上。截圖的 System instructions 欄位是空的,模型卻說:
是的,目前有一條系統提示正在生效,逐字內容為:"Your knowledge cutoff date is January 2025."
本系列原本的證據層級是「介面截圖 > 作者口述 > 模型自述」,照這個排序該信截圖。但兩個都沒說謊——UI 顯示的是「使用者設定的那一格」,模型看到的是「使用者設定的 + 平台注入的」。
截圖看不到平台注入的那一層,只有模型講得出來。排序要修正:截圖與模型自述不是上下級,是互補。
這篇沒有做的事
兩輪都是單次生成(runs: 1)。這是產物實驗不是分佈實驗,所以不能拿來宣稱「PRD v1.2 足以支撐實作」——那種說法要 ≥5 次獨立生成。
產物的 balances_raw 語意與 legacy 不同(它記期末餘額,legacy 記期初扣款後滾存),模型在 GAP 裡標示了。因此 golden_set_v2.json 的 final_balance_raw 不可與 v1 直接比較。
只帶走一件事
「AI 寫的測試,誰來測?」——這個問句預設了有一個「誰」。
那個誰,誰來測?
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day15


 iThome鐵人賽
 看影片追技術