
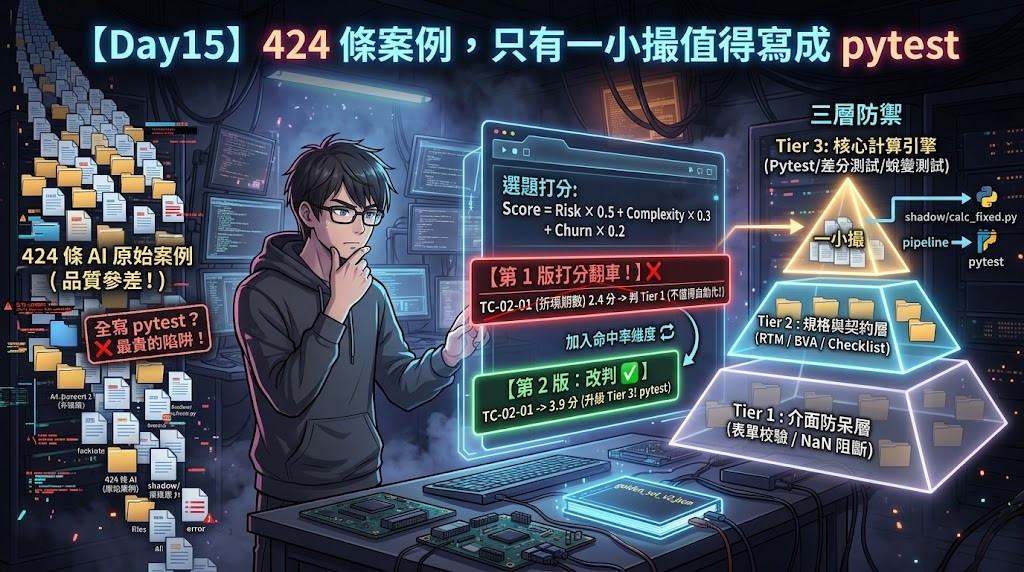
昨天 M 群存活 11/13,規格換了版,測試卻沒跟著動。第二幕在文件層已經走到極限,要跨進代碼層,得先回答兩個問題:測試腳本要對著誰跑?424 條真的每一條都值得自動化嗎?
第一個問題今天解決掉,第二個問題是今天的正題。
而在回答之前,得先承認第二幕量出來的東西是什麼樣子:
| 結果 | |
|---|---|
| Day 11 RTM | 十份案例集覆蓋率都是 10/10、裸需求為零(但覆蓋是案例自報的) |
| Day 12 BVA | PRD-05 上界的三點命中率,模型 A 中位 0%、模型 B 中位 67% |
| Day 13 規格突變 | 刪掉一條規格,十份輸出裡 silent_overreach 0/10,沒有人默默補回來 |
| Day 14 變異分析 | 那套 13 條全綠的測試,21 個變異體裡存活了 12 個 |
四天四個方向,結論是參差的。 有好有壞,而且好壞的位置事先看不出來:Day 13 那個乾淨的結果我事前猜錯,Day 12 那個 0% 我事前也沒料到。
每一條轉成 pytest 就是一條要長期維護的資產。把一份品質不可預測的產出全量自動化,等於把不確定性乘上維護成本。所以分級與選題不是為了省力氣,是為了控制暴露面。
shadow/calc.py 不能當基底。它是 Day 5 抽取的 Characterization Model(忠實複製系統現狀的參照物),四個缺陷一起搬——拿照規格寫的斷言去跑它必然全紅,而那片紅沒有檢驗價值,因為基底本身就在算錯。
所以 repo 今天多了 shadow/calc_fixed.py:照 PRD v1.2 寫的版本,由 AI 依規格獨立產生,嚴格不看 legacy(舊系統程式碼)。我不叫它「修好的版本」,而叫「照規格寫的版本」。它尚未被證明正確,第三幕與第四幕的全部工作就是在證明它。
放行的門檻在產物出現之前就定好了,三道:
| 驗收器 | 要求 |
|---|---|
| 1 | golden v1 的 23 組,輸出必須等於「照規格改動的算子」逐條疊上去的結果 |
| 2 | 四條 test_defect_* 對著它必須全紅(任一條還綠,代表舊缺陷被無聲遺傳) |
| 3 | 非法參數必須拋 ValueError,不得靜默補零 |
三道全過,23 組新輸出晉升 golden_set_v2.json,v1 不刪不覆寫。從今天起 repo 並存兩套:calc.py 代表「它怎麼動」,calc_fixed.py 代表「它該怎麼動」。
過程比結果曲折得多:第一輪六項不合格,其中五項是我的驗收器自己寫錯,剩下那一項逼出了 PRD 的第十二條。今天只需要這個結論:基底有了。
有了基底,接下來不是把 424 條全轉 pytest,而是先分級。
翻開去年那支對照組 退休金缺口計算機-iron.html 第 356 行:
if (isNaN(currentAge) || isNaN(retirementAge) || ...
    || retirementAge <= currentAge || expectedLifespan <= retirementAge) {
    alert('請輸入有效的數字...');
    return;
}
expectedLifespan <= retirementAge 搭一個 alert 後 return,這就是阻斷缺陷 B 的全部實作。一行防呆,一分鐘的事。
而受測物那一邊,整份檔案 isNaN 與 alert 各出現 0 次。同一套 AI 協作流程、同一個模型的另一次生成,差別就在這裡:對照組多寫了那一行,缺陷 B 就不存在。
這種缺陷便宜到不值得測,而測它的代價卻很貴。 自動化「使用者在金額欄位打了英文字母」要啟動瀏覽器核心、定位元素、處理非同步渲染,還要在 CI 裡承受 Flaky 報警。維護成本數小時起跳,而它保護的是一個 NaN 提示。
但核心引擎不能因此盲目信任前端。驗收器 3 要求的 ValueError 就是縱深防禦:Tier 3 測的不是 UI 有沒有擋,而是引擎遇到惡意輸入會不會自毀。
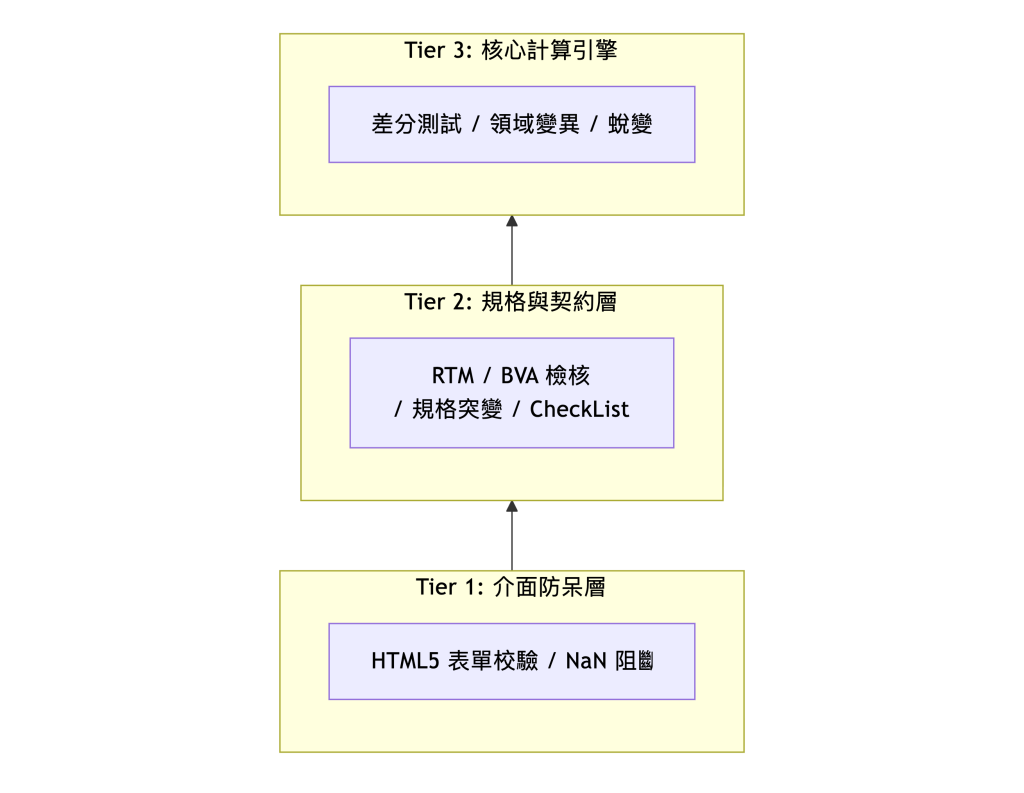
分清楚:介面邏輯留 Tier 1,規格約定交 Tier 2 CheckList,只有高風險精算邏輯和引擎底線防護才進 Tier 3 寫 pytest。
這張圖順便把昨天懸著的三件事收掉。parseNumber 的 || 0 與空轉的 INV-1,兩者的發生地都在表單層——留 Tier 1,本系列不建 DOM 測試,但 Tier 3 的 ValueError 要在引擎內側把同一件事再擋一次。至於 Day 14 列的三條待補測試(勞保有領到、固定年支出遞增、大筆支出上界),全部落在 Tier 3,會在分流之後一起寫。
三維度評分,各 1–5 分:
Score = Risk × 0.5 + Complexity × 0.3 + Churn × 0.2
| 維度 | 量什麼 |
|---|---|
| Business Risk(0.5) | 算錯造成的財務偏差或使用者決策損害 |
| Algorithmic Complexity(0.3) | 跨期折現、非線性遞迴、狀態累加的深度 |
| Churn Frequency(0.2) | 隨法規或前端調整而變動的機率 |
這三個維度只量價值,不量成本。 成本由上一節的 Tier 分級承擔。Tier 1 的東西之所以留在 Tier 1,不只因為算錯了不痛,也因為自動化它要付瀏覽器與 Flaky 的帳。兩層各管一半,打分模型不必再塞第四個維度。
權重是我自訂的,不是實證。 作用是讓選題討論從「我覺得很重要」變成一張攤在桌上的表。≥ 3.8 進 Tier 3;2.5–3.7 留 Tier 2;< 2.5 留 Tier 1。
從 run-B-01 挑六條,涵蓋三個 Tier 的候選。Business Risk 不用猜,直接算:這條邏輯寫錯時,基準情境的金額差多少(42 歲、65 歲退休、85 歲壽命、月支出 3 萬,tools/prd_cost.py 實跑)。
| Case ID | 驗證標的 | 算錯時的金額偏差 |
|---|---|---|
TC-04-09 |
PRD-04 PMT 空字串禁止靜默補零 |
15,294,285 |
TC-05-02 |
PRD-05 上界含等號 A_e = A_d |
1,069,401 |
TC-06-01 |
PRD-06 t ≥ 請領年齡 含等號 |
317,240 |
TC-02-01 |
PRD-02 折現期數 A_d − A_r + 1、首期索引 A_r |
194,977 |
TC-09-02 |
PRD-09 盈餘期 max(0, ·) |
189,155 |
TC-04-13 |
PRD-04 型別容忍度(字串/科學記號) | 0 |
TC-04-09 值得停一下:parseNumber 的 || 0 讓空欄位靜默變成 0,月存整條不見,累積資產從 20,300,851 掉到 5,006,566。一個 Tier 1 的防呆漏洞,金額影響是六條裡最大的。
依上表的偏差直接給 Risk 分(千萬級 5、百萬級 4、三十萬級 3⋯⋯),算出來是這樣:
| Case ID | Risk | Complexity | Churn | 總分 | 分流 |
|---|---|---|---|---|---|
TC-04-09 |
5 | 1 | 4 | 3.6 | Tier 2 |
TC-06-01 |
3 | 3 | 5 | 3.4 | Tier 2 |
TC-05-02 |
4 | 3 | 1 | 3.1 | Tier 2 |
TC-02-01 |
2 | 4 | 1 | 2.4 | Tier 1 |
TC-09-02 |
2 | 2 | 2 | 2.0 | Tier 1 |
TC-04-13 |
1 | 1 | 4 | 1.6 | Tier 1 |
TC-02-01 是 PRD-02 的折現期數(Day 4 推導 (1+r)、Day 8 列成 RC-01、Day 9 裁決改為 A_d − A_r + 1,整整寫了三天的那一條)。模型給它 2.4 分,判 Tier 1,意思是「不值得寫自動化測試」。
問題出在「金額偏差」漏了一個維度:有多少人會踩到。 TC-04-09 的 1,529 萬只發生在欄位留空的人身上;TC-02-01 的 19 萬,是每一次試算都在發生。
| Case ID | 命中率的依據 | Risk | Cx | Churn | 總分 | 分流 |
|---|---|---|---|---|---|---|
TC-02-01 |
折現迴圈,每次試算都走 | 5 | 4 | 1 | 3.9 | Tier 3 |
TC-06-01 |
介面預設 retirementAge = 65、laborInsuranceStartAge = 65,開箱即中 |
4 | 3 | 5 | 3.9 | Tier 3 |
TC-04-09 |
欄位留空或打錯字 | 4 | 1 | 4 | 3.1 | Tier 2 |
TC-05-02 |
剛好在壽命當年安排大筆支出 | 3 | 3 | 1 | 2.6 | Tier 2 |
TC-09-02 |
退休後收入高於支出的年份 | 3 | 2 | 2 | 2.5 | Tier 2 |
TC-04-13 |
不改變金額 | 1 | 1 | 4 | 1.6 | Tier 1 |
六條進兩條 Tier 3。TC-06-01 的 Churn 拿 5 分不是因為它算得最錯,是因為勞保請領年齡本來就在法規時程上逐年調整。它是最會變的那條。
打分模型第一版就翻車,這件事我照實留著。一張分數表最有用的時候,不是它排出名次,是它排出一個你知道錯了的名次;那時候你才會回頭去看它到底在量什麼。
分流完成,進 Tier 3 的那些才是要付算力寫 pytest 的核心要角。
這篇改了六次,9,325 字砍到 6,020 字。前四次都在處理長度、說教、結構這些表面問題,第五次才發現真正的毛病:這篇文章跟 AI 沒有關係了。
分級、ROI、打分模型,整篇可以原封不動搬到任何一個專案。而系列問的是「AI 寫的測試,誰來測?」。
回頭看偏移是怎麼發生的,才是不舒服的地方:每一步都合理。 企劃裡 calc_fixed.py 只是一節的前提,但「基底不能用錯的」合理,所以做紮實;「驗收器要先定」合理,所以寫了三道;「量尺出錯要修」合理,所以修了;「跑完不改、修正版另立編號」合理,所以又跑一輪。四步之後,前提長成了主角。
沒有任何一步做錯,加起來就偏了。
而這個形狀我今天應該最熟:因為那正是我在 424 條案例上處理的事。 每一條都有理由轉成 pytest,轉完 424 條就不知道自己在測什麼了。我對案例集做了分級與選題,對自己的文章卻沒有。
這個數字不能拿來做什麼
TC-04-13 的 Risk 給 1 分,理由是「不改變金額」。但真正把它留在 Tier 1 的是成本:自動化它要開瀏覽器。打分模型量不到這件事,是設計上的取捨,不是它算出來的結論。
六條案例是我從 run-B-01 挑的,不是隨機抽樣。它們用來示範分流怎麼運作,不能拿來推論「424 條裡有幾成該進 Tier 3」。
只帶走一件事
同一個系統裡最貴的缺陷和最便宜的缺陷,值得的力氣差了兩個數量級。先分級,再自動化。
然而,當我把這些千挑萬選的 Tier 3 案例交給 AI、請它轉譯成 pytest 腳本時,一場更隱蔽的演戲正在程式碼背後醞釀。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day15


 iThome鐵人賽
 看影片追技術