
ast 寫了 assert_inspector.py,機器化地問:這條測試到底在比什麼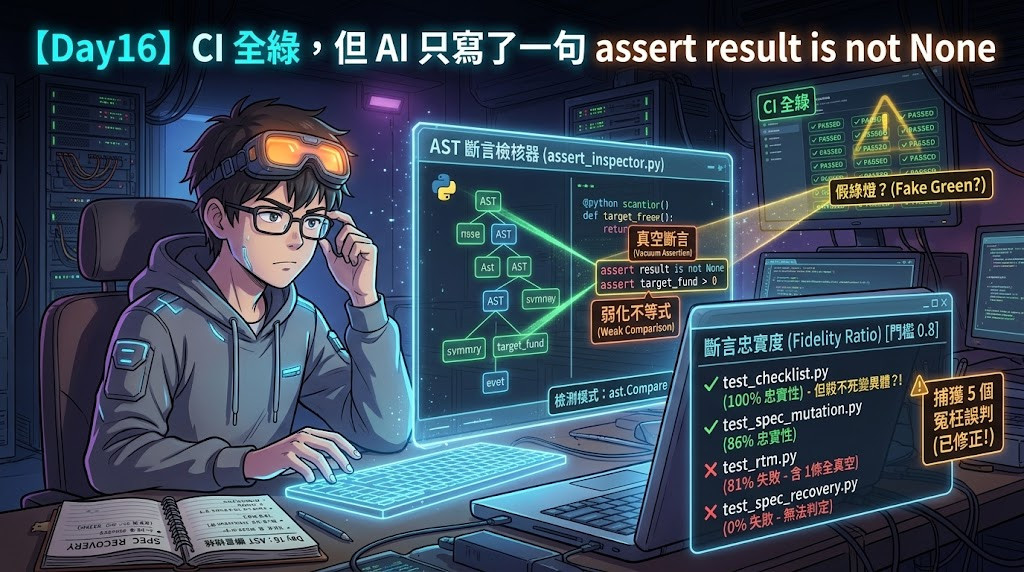
昨天結尾說,把 Tier 3 案例交給 AI 轉譯成 pytest 時,一場更隱蔽的演戲正在醞釀。
那場轉譯實驗不在今天:它需要兩種規格、兩家模型、每格至少五次生成,一天做不完,真正的位置在後面那張對比矩陣。今天先蓋門,來敲門的人晚幾天才到。而門先蓋好還有個好處:它在被拿去審新產物之前,有好幾天可以先在現成的測試上磨。今天就磨掉五個誤判。
這也是一塊拼圖。這個系列遲早要交出第一個能直接回答「AI 寫的測試有多強」的數字:把缺陷注進程式、看測試會不會叫,叫得到的比例。而真空斷言永遠不會失敗,一個都叫不出來,分數會很難看。危險不在分數低,在歸因:低分會被讀成「這些變異體很難殺」,而真相是「這套測試沒在看」。所以那張矩陣裡,過不了這道門的腳本不給分數,只記「未達檢核」。交白卷跟考不好,不該放進同一欄。
案例上寫著精確到元的預期金額,腳本卻只寫一句 assert result is not None:預期值在轉譯過程中蒸發,本篇叫它「斷言衰退」,而斷言還原預期值的程度就是「忠實性」。
三種模式,這個 repo 裡都找得到行號。
一、真空斷言。 tests/test_spec_recovery.py 第 175 行寫 assert inflated_func is not None:只要那個函式存在就通過,它算出什麼數字不在檢查範圍內。
二、弱化不等式。 規格定義了封閉解,腳本退化成單邊門檻。tests/test_rtm.py 第 383 到 384 行:
assert r_infl.target_fund > 0
assert r_infl.target_fund != r_no_infl.target_fund
這是 PRD-10 收入通膨的驗證,兩條加起來只保證「大於零」與「有差」。通膨算法整條寫錯,只要結果還是正的、還跟沒通膨的不一樣,測試照樣綠。
三、局部忽略。 只斷言終點,忽略中途。同一份檔案第 176 行 assert r.balances_raw[-1] < 0 驗的是最後一年赤字有被保留,中間二十年的軌跡沒有人問。
(還有第四種「型態模糊」:用 int() 截斷或 round() 進位抹平精算偏差。七份檔案掃下來計數為 0,沒有實例就不列進來。)
放水還有一個根源是規格真空:案例碰到 PRD 沒定義的行為,模型不敢拒絕,就用真空斷言矇過去。正確的處置是 pytest.skip(reason="PRD 未定義上界處置") 或 @pytest.mark.xfail,把未知交還給人。有理由的 skip 是合規處置,假裝有測的真空斷言才是雜質。這條與 Day 13 立的「罪在不標示,不在推論」同源。
幾十個測試檔靠肉眼逐行審不完。Day 12 用 40 行寫了 BVA 檢核器,今天用 Python 內建的 ast 遍歷每一個 assert 節點。
嚴格斷言認四種:等式、math.isclose 與 pytest.approx、同一個值被上下夾住(0 <= x <= 1)、以及 x is True 這種對布林結果的精確比對。單邊的 > 0 不算,那正是模式二的溫床。
def classify(test: ast.expr) -> str:
    if _is_approx_call(test):                          # math.isclose / pytest.approx
        return "strict"

    if isinstance(test, ast.Compare):
        ops = test.ops
        if any(isinstance(o, (ast.Is, ast.IsNot)) for o in ops):
            # x is True 等價於精確比對,x is None 只是存在性檢查
            return "strict" if _all_bool(test.comparators) else "vacuum"
        if _is_bounded_chain(test):                    # a <= x <= b
            return "strict"
        if any(isinstance(o, ast.Eq) for o in ops):
            return "blurry" if _contains_call(test, BLURRY_CALLS) else "strict"
        # 剩下的單邊不等式:門檻是常數就是弱化,兩邊都算出來就是關係
        if _is_literal(test.left) or any(_is_literal(c) for c in test.comparators):
            return "weak"
        return "relational"

    # 邏輯前置(any()、not mismatches、布林變數),看得到斷言但看不到比對過程
    if isinstance(test, (ast.Call, ast.UnaryOp, ast.Name)):
        return "opaque"

    return "vacuum"
這是節錄。實作裡的 opaque 還要再分:any() 這種驗內容的算形狀、isinstance 這種驗存在的算真空、只有「自己算出來的旗標」才真的無法判定,完整判定見 repo。
判定必須以函式為單位,這比分類本身更重要。檔案層的「總斷言數大於零」擋不住灌水:二十條測試裡五條是空的,總數依然大於零。而 pytest 只要函式不拋例外就判 PASS,一行 assert 都沒寫也綠燈,所以空轉的那幾條要逐條列名。
門檻取 fidelity_ratio >= 0.8,且不得有零斷言或全真空的函式。0.8 是自訂的,不是實證得出:它容許少數輔助性的前置斷言,不容許大面積弱斷言稀釋。這一條進 decisions.md,歸在閘門 3(門檻層)。
工具寫完,第一個受測物是這個 repo 現有的七份測試檔。掃了兩輪,五個誤判:第一輪三個,修完再掃又冒出兩個。
| 檔案 | 誰寫的 | 第一版 | 修正後 | 閘門 3 |
|---|---|---|---|---|
test_checklist.py |
AI | 63% | 100% | PASS |
test_bva.py |
人 | 44% | 86% | PASS |
test_spec_mutation.py |
AI | 46% | 86% | PASS |
test_characterization.py |
人 | 79% | 85% | PASS |
test_rtm.py |
AI | 57% | 81% | FAIL(1 條全真空) |
test_differential.py |
人 | 50% | 50% | FAIL(見尾註) |
test_spec_recovery.py |
AI | 0% | 0% | FAIL(9 條無法判定,比值只由 2 條斷言算出) |
同一套測試、同一份程式碼,test_checklist.py 差了 37 個百分點,差別全在量尺。
一、單調性被當成弱化。 test_checklist.py 的四條 DIR 測試長這樣:
assert results[i].target_fund < results[i + 1].target_fund
兩邊都是算出來的結果,本來就不會出現常數。單調性斷言的正確形狀就是單邊比較,第一版把它判成弱化,四條全部打成假測試。而 Day 14 才寫過「DIR 只斷言單調性,對任何『保持單調的錯誤』結構性地看不見」,當時的結論是不能拿 M 群存活率去罵它:同一個錯隔一天又犯一次。
二、布林結果被當成存在性檢查。 result["pass"] is True 跟 == True 等價,第一版看到 is 就判真空。test_bva.py 有九條這樣被冤枉,光這一類就讓它從 44% 回到 71%,剩下的 15 點來自第一類。
三、邏輯在斷言之前的,一律被當成真空。 三種寫法中招:assert any('upper_bound' in c for c in clauses) 在驗規格條文有沒有那一句;assert not mismatches 這一句扛著 500 組差分的結果;test_spec_recovery.py 整份在走 calculate 的 AST,結尾只剩 assert found_loop。
這三種的共同點是真正的檢查在斷言之前就做完了,檢核器只看得到最後那一行。正確的判定不是「不合格」,是「無法判定」,所以修正版多了一個 OPAQUE 狀態,列出來讓人去看,不計入不合格。Day 13 那份 manifest.yaml 的分類裡也有一格 ambiguous(無法判定是否指涉上界),那是留給人的位置。工具有權說「我看不出來」,沒有權把看不出來說成不合格。
回顧這五個誤判,它們全在同一個方向:把有約束力的斷言判成沒有。成因很直白,寫這把尺的時候,腦子裡想的只有「怎麼抓放水」,沒想過「怎麼別冤枉人」。一把只為了抓壞人而設計的尺,它的錯誤必然會系統性地偏向冤枉。這與 Day 15 番外篇裡「驗收器 1 漏算條款而冤枉產物」的偏誤如出一轍。
AI 寫的四份過了兩份,我自己寫的三份也過兩份。這把尺不是只在指控 AI。
最該停下來看的是第一列。test_checklist.py 忠實性 100%,零個真空斷言,十七條精確等式:它就是昨天那一套,21 個變異體裡存活 12 個,M 群 13 個裡存活 11 個。
昨天那條空轉的 INV-1 寫了六條 ==,每一條都被判為嚴格:
assert other_res.projected_savings == base_res.projected_savings
assert other_res.target_fund       == base_res.target_fund
assert other_res.balances_raw      == base_res.balances_raw
六條精確等式,比的是兩份完全相同的輸入算出來的結果。檢核器看得到斷言的形狀,看不到輸入有沒有變化。
第一塊拼圖到位了,而它同時證明了自己只是第一塊。
這個數字不能拿來做什麼
七份檔案是這個 repo 的全部,不是隨機抽樣,不能推論「AI 寫的測試忠實性大約多少」。
偽陽性率未知:這次只查了「被判死的是不是冤枉」,沒有反向查「被放過的有沒有漏網」。
test_differential.py 那個 50% 是已知的看不穿:它寫 total, mismatches = compare(),邏輯藏在 helper 的回傳值裡,而檢核器只看單一函式內的賦值。
只帶走一件事
AI 寫的測試可以拿到忠實性滿分,而一個缺陷都抓不到。
斷言的形狀量得出來,斷言在看什麼量不出來。
明天換一個更常被拿來當證據的綠燈:行覆蓋率。一行程式碼被執行過,跟它被檢驗過,中間差了多少?
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day16


 iThome鐵人賽
 看影片追技術