
上一篇文章介紹了 Big O,我們學會用「輸入規模增加時,操作次數會怎麼成長」來描述一個做法的成本,不過那篇從頭到尾數的都是「操作次數」,也就是 Time Complexity(時間複雜度)。
一個做法需要付出的成本不只有時間。以重複訂單為例,如果想減少兩兩比較,就可能得額外記住已經看過哪些訂單;當資料量增加時,這份紀錄又會跟著長多大呢?
今天就來看另一個常見的成本,Space Complexity(空間複雜度)。
先回到上一篇的重複訂單問題。當時的做法是把每一組訂單都拿出來比對一次:
for (let i = 0; i < orders.length; i++) {
  for (let j = i + 1; j < orders.length; j++) {
    compareOrders(orders[i], orders[j]);
  }
}
這是 O(N²),1000 筆訂單就需要比較將近 50 萬次,而且訂單數量每增加 10 倍,比較次數會增加到接近 100 倍。
那有沒有辦法不要兩兩相比呢?其實有一個很直覺的想法,與其每次都回頭找,不如邊走邊記,從第一筆訂單開始往下看,每看過一筆就把它記下來,之後遇到新的訂單只要問一句「這筆我看過了嗎?」就好,不需要再從頭比對一次。
這個想法確實可行,但它引出了一個 Time Complexity 回答不了的問題,「記下來」這件事本身也要成本,記在哪裡?佔多少?當訂單從 1000 筆變成 100 萬筆時,這份紀錄會跟著長多大?
而且記憶體是有限的,上一篇實測執行時間時用到的那批訂單資料,光是把它們放進記憶體就已經相當可觀:
| 訂單數量 | 訂單資料佔用的記憶體 |
|---|---|
| 1000 萬筆 | 約 458 MB |
| 3000 萬筆 | 約 1374 MB |
3000 萬筆訂單就吃掉大約 1.3 GB,若為了加速還要再額外建立一份長度和訂單數量一樣的資料,那就是再疊上一份可觀的記憶體,而在瀏覽器分頁裡或是有記憶體上限的程式中,這是有可能超過電腦記憶體能儲存的範圍的。
另外觀察一下上表資料,訂單數量從 1000 萬變成 3000 萬(3 倍)時,記憶體用量也從 458 MB 變成 1374 MB(約 3 倍),兩者呈現線性成長。
補充:上面的記憶體數字怎麼測的
和上一篇同一台機器(Apple M1、Node.js v24.14.0),做法是在建立訂單陣列前後各取一次
process.memoryUsage().heapUsed,相減得到這批資料實際佔用的 heap,並以--expose-gc在測量前先做一次垃圾回收,避免前一輪殘留影響結果。這裡只計算訂單物件本身、不含 Node.js 執行環境的基本開銷,實際數字會隨引擎版本與物件結構而變,重點在於「3 倍資料 → 約 3 倍記憶體」這個關係,而不是絕對值。
為了把焦點放在空間上,這裡先把問題單純化一點。假設系統每天都會從物流商那邊匯入一批訂單資料,在寫進資料庫以前,我們想先檢查這批資料裡有沒有重複的訂單編號:
const orders = [
  { id: 'A-1001', amount: 1200 },
  { id: 'A-1002', amount: 890 },
  { id: 'A-1003', amount: 450 },
  { id: 'A-1002', amount: 890 },
];
最直接的寫法,就是把每一組訂單都比一次:
function hasDuplicateOrderId(orders) {
  for (let i = 0; i < orders.length; i++) {
    for (let j = i + 1; j < orders.length; j++) {
      if (orders[i].id === orders[j].id) {
        return true;
      }
    }
  }

  return false;
}
依照上一篇的分析方式,外層選出一筆訂單、內層和後面的每一筆比較,時間複雜度是 O(N²)。
那它額外用掉了多少記憶體呢?其實只有 i 和 j 兩個索引變數,不論輸入是 10 筆還是 1000 萬筆訂單,都還是這兩個變數而已。
接著把前面「邊走邊記」的想法寫成程式,這裡使用 JavaScript 內建的 Set,它可以保存一組不重複的值,並且提供 has(檢查是否存在)與 add(加入)兩個操作:
function hasDuplicateOrderId(orders) {
  const seenIds = new Set();

  for (const order of orders) {
    if (seenIds.has(order.id)) {
      return true;
    }

    seenIds.add(order.id);
  }

  return false;
}
用前面那組資料實際走一次看看流程:
| 目前這筆訂單 | seenIds.has(order.id) |
動作 | 這一輪結束後的 seenIds |
|---|---|---|---|
A-1001 |
false |
記下來 | {A-1001} |
A-1002 |
false |
記下來 | {A-1001, A-1002} |
A-1003 |
false |
記下來 | {A-1001, A-1002, A-1003} |
A-1002 |
true |
找到重複,回傳 true |
— |
每一筆訂單都只被看過一次、沒有任何回頭比對,若 Set 的 has 與 add 都可視為固定成本,那整個函式的時間複雜度就是 O(N)。
補充:為什麼
Set的查找可以視為O(1)?這牽涉到
Set底層是怎麼決定「一筆資料該放在哪裡」的,它會透過一個函式直接從值本身算出它應該落在哪個位置。詳細會在後面 Hash Table 的文章介紹。
時間從 O(N²) 降到 O(N),這是換來的東西,那付出的又是什麼呢?
關鍵在 seenIds,最壞的情況是這批訂單完全沒有重複,那迴圈會一路跑到最後一筆,seenIds 也會累積到 N 筆訂單編號,訂單有 1000 筆它就存 1000 筆、有 100 萬筆它就存 100 萬筆,等於我們用「一個會長到 N 筆的 Set」換掉了「將近 N²/2 次的比較」。
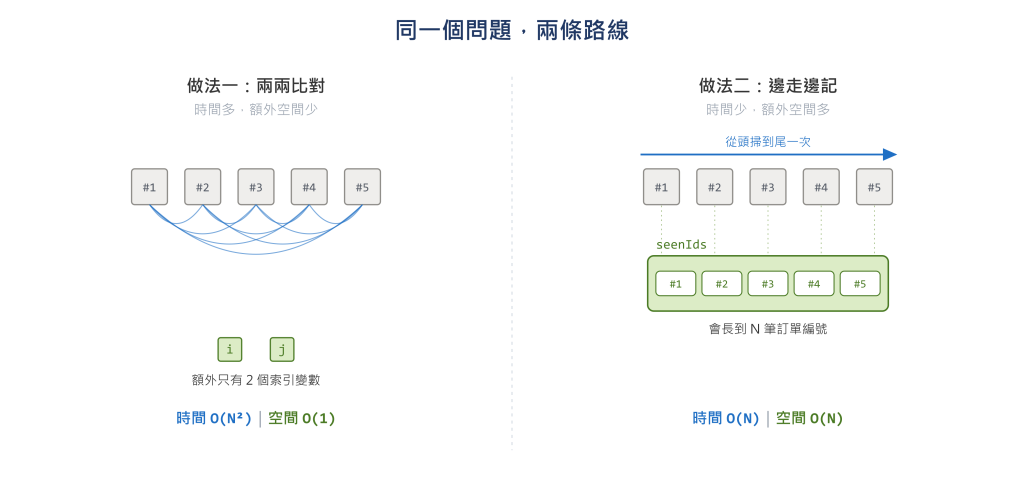
圖 1 同一個問題的兩條路線:成本被放在不同的地方
為了闡述程式需要的空間成本,我們會用 Space Complexity 來描述:
Space Complexity 描述的是,當輸入規模增加時,演算法額外需要的記憶體會如何成長。
和 Big O 一樣,它關心的是成長的方式、而不是「這次執行實際佔了幾 MB」,所以前面的 seenIds 會跟著訂單數量線性增加,可以寫成 O(N),而兩個索引變數不論輸入多大都是兩個,是 O(1)。
這裡要特別留意的是額外兩字。
在分析空間時,通常會把記憶體用量分成兩部分:
| 名稱 | 指的是什麼 | 在重複訂單的例子中 |
|---|---|---|
| Input Space(輸入空間) | 輸入資料本身佔用的空間 | 傳進來的 orders 陣列 |
| Auxiliary Space(輔助空間) | 演算法為了完成工作,額外建立出來的空間 | seenIds、i、j |
而當我們說「這個演算法的空間複雜度是 O(N)」時,講的通常是 Auxiliary Space,也就是剛剛強調的額外部分。
可能有人會想說,輸入資料明明也佔記憶體,為什麼不算?
原因是那 1000 筆訂單本來就必須存在,不管我們選哪一種做法,它們都得在記憶體裡,並不是演算法「選擇」出來的成本。這概念和上一篇提過的「複雜度屬於做法,不屬於問題」一樣,我們想描述的是不同做法之間的差別,而輸入空間在每種做法裡都一樣,不需特別考慮。
把兩個版本放在一起看下成本差異:
| 做法一:兩兩比對 | 做法二:邊走邊記 | |
|---|---|---|
| Input Space | N 筆訂單 |
N 筆訂單 |
| Auxiliary Space | 兩個索引變數 → O(1) |
最多 N 筆編號 → O(N) |
| Time Complexity | O(N²) |
O(N) |
兩個版本的 Input Space 完全相同,真正有差異的是 Auxiliary Space,因此分析時才要把它單獨拿出來看。
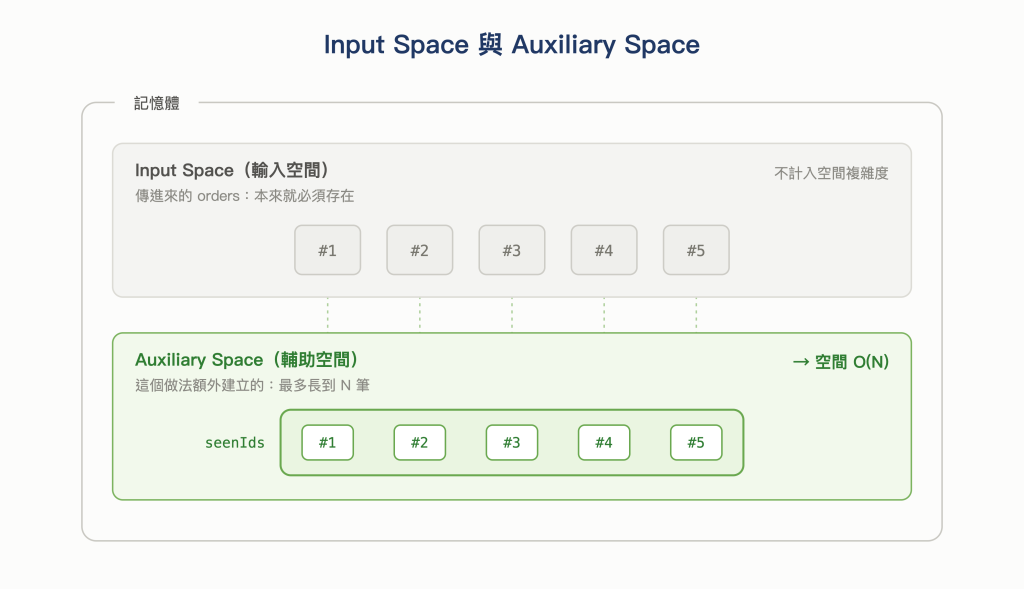
圖 2 Input Space 與 Auxiliary Space
補充:也有教材會算 Total Space
有些教材或題目會使用 Total Space(Input Space + Auxiliary Space)來描述空間需求,兩種算法都存在,只是關注的角度不同。
另一個容易搞混的地方是,空間複雜度算的是「在任何一個瞬間,最多需要同時保存多少資料」,而不是「整個過程中總共建立過多少東西」,這兩者聽起來很像,實際上差很多,看下面這個函式:
function getTotalRevenue(orders) {
  let total = 0;

  for (const order of orders) {
    const label = `訂單 ${order.id}:${order.amount} 元`;
    console.log(label);
    total += order.amount;
  }

  return total;
}
這個迴圈跑 N 次,也就建立了 N 個 label 字串。如果用「總共建立過幾個」來算,看起來像 O(N)。
但實際上每一輪的 label 在下一輪開始前就不再被需要了,任何時刻都只有一個 label 是活著的,所以額外空間是 O(1)。
反之,若我們需要的是把結果一起帶回去,情況就不同了:
// 若把回傳結果算進去,需要 O(N) 空間
function getReviewOrderIds(orders) {
  const reviewOrderIds = [];

  for (const order of orders) {
    if (order.needsReview) {
      reviewOrderIds.push(order.id);
    }
  }

  return reviewOrderIds;
}

// 空間 O(1):從頭到尾只需要一個計數器
function countOrdersNeedingReview(orders) {
  let reviewCount = 0;

  for (const order of orders) {
    if (order.needsReview) {
      reviewCount += 1;
    }
  }

  return reviewCount;
}
這兩個函式都完整走訪了 N 筆訂單、時間複雜度都是 O(N)。如果把回傳結果也算進去,第一個函式在最壞情況下(每一筆都需要審核)會需要 O(N) 空間,第二個則從頭到尾只需要 reviewCount 這一個數字。若只分析過程中的 Auxiliary Space,回傳結果通常會另外計算。
所以在分析空間時要思考的是,若在程式執行到一半時按下暫停,這時候有多少資料是「還不能丟掉」的?
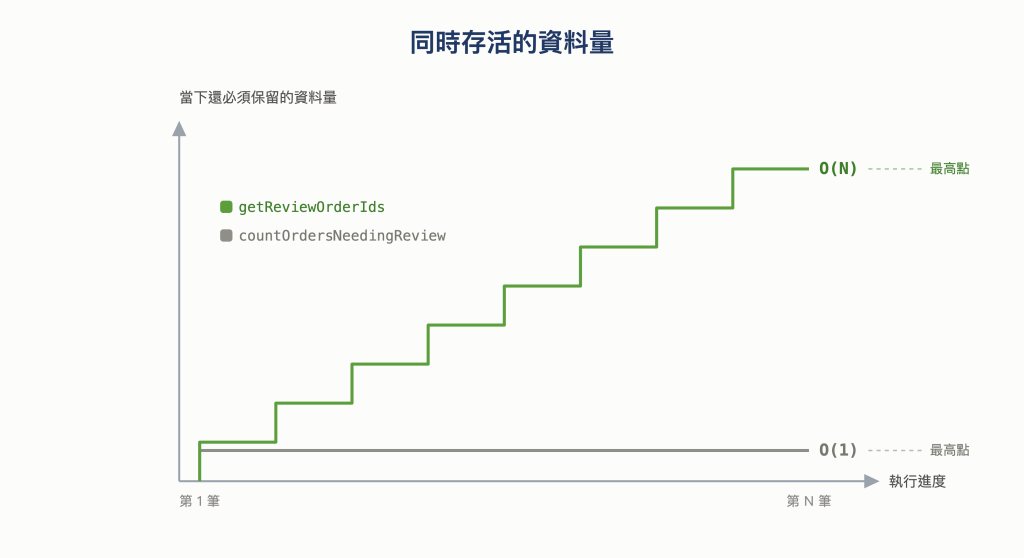
圖 3 同時存活的資料量
上一篇提過,看到一段程式時可以先問自己三個問題,分析空間時也可以照著問,只是後兩題要換一下:
用做法二走一次,輸入規模是訂單數量 N、額外建立的是 seenIds,而最壞情況下(完全沒有重複)會存進 N 筆訂單編號,因此空間複雜度是 O(N)。
接著來看看實際寫程式時額外空間通常從哪裡來。
1. 變數
最單純的一種,固定數量的變數就是 O(1),像前面的 i、j、total、reviewCount 都屬於這類。這裡講的是「固定數量」而不是「數量很少」,就算宣告了 20 個變數,只要不會隨輸入增加就仍是 O(1)。
2. 複製出來的資料
slice()、[...orders]、map()、filter() 這些操作都會回傳新的陣列,原本的資料還在、新的資料又佔了一份,所以複製一份完整的輸入就是 O(N),這件事很容易被忽略,因為寫起來只有一行:
// 看起來很輕巧,但這裡多了一份 N 筆的陣列
const sortedOrders = [...orders].sort((a, b) => a.amount - b.amount);
3. Hash Table 與 Set
為了加快查找而建立的對照表,存進去多少筆就佔多少空間,存 N 筆就是 O(N)。
4. Cache(快取)
為了避免重複計算而把結果保存下來,快取需要將結果保存一段時間,才能在之後重複使用,因此也會佔用額外空間。
5. Call Stack(呼叫堆疊)
這項最容易被漏掉,因為程式碼裡看不到任何建立資料的動作。
當一個函式呼叫另一個函式時,還沒結束的那個函式必須被保留下來,它的區域變數、以及「等一下要回到哪一行」這些資訊都得先記著,而這些資訊會疊在 Call Stack 上。
function sumTo(n) {
  if (n === 0) {
    return 0;
  }

  return n + sumTo(n - 1);
}
sumTo(1000) 在算出結果以前,必須先疊出 1000 層還沒完成的呼叫。所以即使這個函式裡完全沒有建立任何陣列或物件,額外空間仍然是 O(N)。
Call Stack 的實際運作方式會留到 Recursion 那篇再說明,這裡只要記得,遞迴的深度也是一種空間成本。
既然額外空間是成本,那有沒有做法可以完全不建立新的資料結構呢?有的,這類直接在原本的輸入上修改的做法通常稱為 in-place(原地),以「把訂單順序反轉」為例,兩種寫法的差別是:
// 不是 in-place:另外產生一個新陣列,額外空間 O(N)
function reverseOrders(orders) {
  return [...orders].reverse();
}

// in-place:直接在原陣列上兩兩交換,額外空間 O(1)
function reverseOrdersInPlace(orders) {
  let left = 0;
  let right = orders.length - 1;

  while (left < right) {
    [orders[left], orders[right]] = [orders[right], orders[left]];
    left += 1;
    right -= 1;
  }

  return orders;
}
reverseOrdersInPlace 從頭到尾只用了 left、right 兩個變數,額外空間是 O(1)。
不過 in-place 也不是沒有代價,它會直接改動傳進來的資料,若程式其他地方還在使用同一份 orders,就可能出現預期外的結果,所以這裡省下的記憶體,其實是用「原始資料不再保持不變」換來的。
看過規則後,來試著分析一段程式的時間與空間複雜度吧~假設我們想統計一批訂單裡「金額超過某個門檻」的部分,需要知道筆數、涉及多少位不同的使用者,以及總金額:
function summarizeHighValueOrders(orders, minAmount) {
  const highValueOrders = [];

  for (const order of orders) {
    if (order.amount >= minAmount) {
      highValueOrders.push(order);
    }
  }

  const userIds = new Set();
  let total = 0;

  for (const order of highValueOrders) {
    userIds.add(order.userId);
    total += order.amount;
  }

  return {
    orderCount: highValueOrders.length,
    userCount: userIds.size,
    total,
  };
}
首先,先看一下時間複雜度:
N。orders,執行 N 次;第二個迴圈走訪 highValueOrders,最壞情況(每一筆都超過門檻)也是 N 次。O(N+N),忽略固定倍數後是 O(N)。再來看空間複雜度:
N。highValueOrders 陣列、userIds 這個 Set,以及 total。highValueOrders 會存進 N 筆訂單;userIds 最多會有 N 個不同的 userId;total 是固定的一個數字。三者在第二個迴圈執行時是同時存活的,因此是 O(N + N + 1)。小補充一點,空間複雜度的簡化規則和時間複雜度一樣,O(N + N + 1) 忽略固定倍數與常數項後仍然是 O(N)。
上面這段程式中,兩個迴圈其實可以合併成一個,這樣連 highValueOrders 都不需要建立:
function summarizeHighValueOrders(orders, minAmount) {
  const userIds = new Set();
  let orderCount = 0;
  let total = 0;

  for (const order of orders) {
    if (order.amount < minAmount) {
      continue;
    }

    userIds.add(order.userId);
    orderCount += 1;
    total += order.amount;
  }

  return {
    orderCount,
    userCount: userIds.size,
    total,
  };
}
改完之後 userIds 最壞情況仍然會存到 N 筆,所以空間複雜度還是 O(N),Big O 上看不出差別,但實際的記憶體用量少了一整份訂單陣列。
這也呼應上一篇提過的,Big O 會忽略固定倍數,而被忽略掉的固定倍數在真實世界裡仍然要付出成本,分析成長級別和實際省記憶體是兩件事。
可能有人會覺得,既然做法二的時間複雜度明顯比較好,那以後都用做法二就好了吧?不過實際應用時還是要看情況:
Set 的成本,100 筆訂單的 4950 次比較其實一瞬間就跑完了。O(N) 的額外空間可能根本放不下,反而是做法一比較實際。這和 Day 02 的 totalRevenue 例子一樣,成本沒有消失,只是被移到了另一個操作或資源上。
所以與其說「用空間換時間」,或許更接近事實的說法是成本很少會憑空消失,多半只是換一個地方出現,我們要做的是判斷目前這情境下把它放在哪裡比較付得起,而不是消滅成本。
另外補充一下,時間與空間是這個系列會反覆分析的兩項因素,但實際開發時要權衡的因素可能更多。
| 因素 | 要考量的問題 | 常見的情境 |
|---|---|---|
| Time(時間) | 希望多久之內算完? | 使用者按下按鈕後願意等多久 |
| Space(空間) | 能忍受用掉多少儲存資源? | 瀏覽器分頁的記憶體、裝置的硬碟空間 |
| Power(能源) | 有多少電力可以拿來運算? | 行動裝置與穿戴式裝置不希望有太耗電的運算 |
| Bandwidth(頻寬) | 需要傳輸多少資料? | API 回傳的資料量、圖片與靜態資源大小 |
| Manhour(人力) | 有多少人力可以寫與維護? | 一個只用一次的腳本,值得花三天最佳化嗎 |
| Token | 要花多少 AI Agent 的 token 產出與維護程式? | 讓 AI Agent 反覆重構一段只執行一次的腳本 |
最後一項應該是這幾年才變得重要的因素之一,我們現在寫程式很常請 AI Agent 幫忙,而每一輪修改、重構都會消耗 token,所以它其實也逐漸變成我們要考量的資源了~
而這些因素之間常常彼此牽動。運算做得越多通常越耗電(time ↔ power);把資料留在本地可以少傳一點,但要佔更多空間(space ↔ bandwidth);花更多人力做精細的最佳化,可以換到更好的執行時間(manhour ↔ time);請 AI Agent 多跑幾輪最佳化,一樣可以換到更好的執行時間,但 token 也會跟著往上加(token ↔ time)。
這也是為什麼演算法分析很難只用「哪個比較好」來回答,真正要思考的是在目前這個情境下,哪些因素是重要的、哪些其實可以放掉? 想清楚這件事,才知道要往哪個方向取捨。
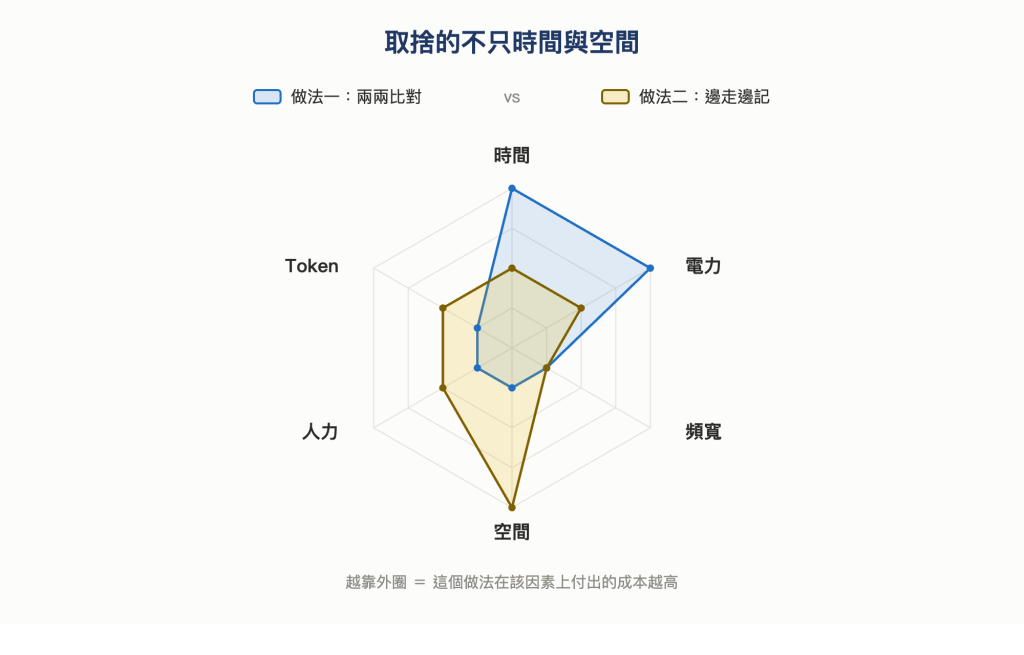
圖 4 取捨的不只時間與空間:成本從時間換到空間,而要看的面向不只兩個
一樣小小總結一下今天對 Space Complexity 的認識~
O(N²) + O(1) 和 O(N) + O(N) 是兩種不同的取捨,而不是單純的好與壞。到這裡,我們已經可以從時間與空間兩個維度描述一個做法的成本,不過不管一個做法多快、多省,算出的結果都必須是正確的。那要怎麼確認一個演算法真的正確呢?只要測試都通過就代表沒問題嗎?下一篇就來談這件事~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術