
前面兩篇用 Big O 和 Space Complexity 描述一個做法的時間與空間成本,不過一個做法即使又快又省,仍然可能算出錯誤答案。
那要怎麼知道一個演算法是對的呢?最直覺的答案大概是寫測試,但測試都過了就代表沒問題嗎?
今天就來談這件事~
延續前兩篇的訂單情境,這次有個很單純的需求,我們手上有一批訂單,想找出金額最低的那一筆。
這裡要的是「哪一筆」而不是「多少錢」,因為找到之後還得拿它的客戶資料、寄送地址去做後續處理,所以我們要的是它在陣列中的位置(index)。
先寫一版看看:
function getMinIndex(amounts) {
  let minpos = 0;

  for (let i = 1; i < amounts.length; i++) {
    if (amounts[i] < amounts[i - 1]) {
      minpos = i;
    }
  }

  return minpos;
}
邏輯乍看之下蠻順的,從第二筆開始往後看,只要這一筆比前一筆便宜就把位置記下來,接著來測試不同情境下的輸入:
| 測試輸入 | 想測什麼 | 預期 | 實際 | 結果 |
|---|---|---|---|---|
[880] |
只有一筆訂單 | 0 |
0 |
✅ |
[120, 340, 560] |
金額遞增 | 0 |
0 |
✅ |
[560, 340, 120] |
金額遞減 | 2 |
2 |
✅ |
[400, 400] |
金額相同 | 0 |
0 |
✅ |
[500, 300, 800] |
最小值在中間 | 1 |
1 |
✅ |
五個案例全過,涵蓋了單一元素、遞增、遞減、重複值、最小值在中間,看起來相當完整。
這時程式上線,正式資料傳進這函式,卻發現出錯了:
getMinIndex([500, 100, 900, 300]); // 3 🔺 應該是 1
最便宜的是第二筆的 100(index 為 1),但函式回傳了 3。
為什麼會有問題呢?問題出在比較的對象寫錯了,amounts[i] < amounts[i - 1] 比的是前一筆,而我們真正想比的是目前最便宜的那一筆,所以走到 900 時沒有更新是對的,但走到 300 時,程式拿它跟 900 比,發現比較小就更新了位置,它從頭到尾沒跟真正的最小值 100 比過。
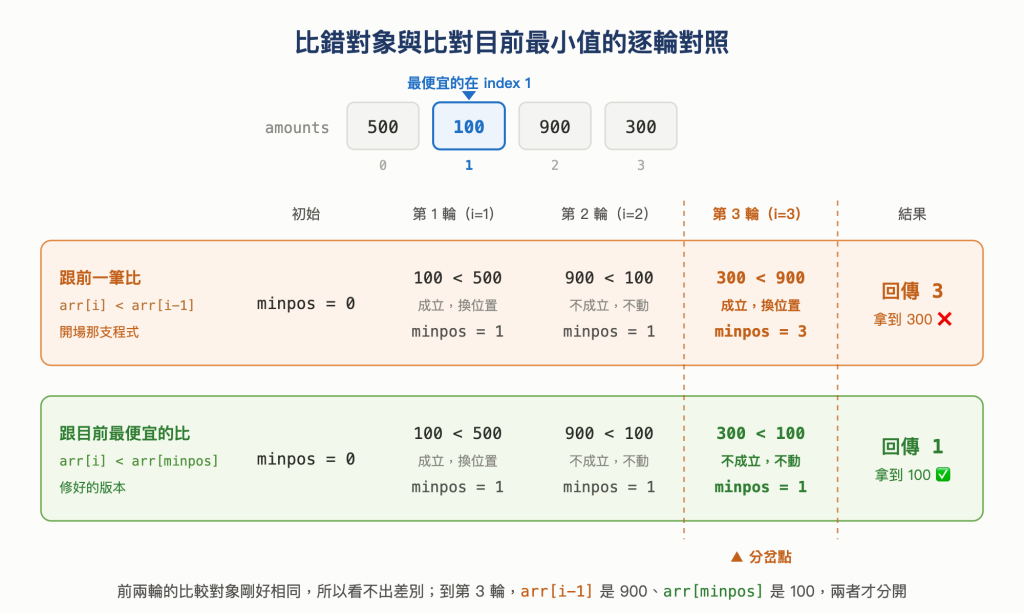
圖 1 比錯對象與比對目前最小值的逐輪對照
通常這情況下我們會說這程式有個 bug,但更值得注意的是,這個 bug 測試其實抓得到,只要剛好寫出 [500, 100, 900, 300] 這筆測試,它馬上就現形了,問題是我們可能根本不知道要補這一筆。
前面那五個案例已經覆蓋了我們想得到的邊界,但「最小值在中間,後面還有一段先升再降」這種資料形狀,沒特別想到就不會被寫進測試裡,而且換一支演算法,會漏掉的可能又是另一種形狀。
測試能告訴我們的是「這些輸入目前沒有出錯」,它給的是例子,但若要說「對所有合法輸入都成立」,我們需要的就是理由了。
這並不是說測試不值得寫,實際開發時我們不可能每寫一段程式都跑一次完整論證。測試用具體案例檢查程式行為,論證則說明所有符合前提的輸入為何成立,兩者處理的範圍不同,也彼此互補。
在談「理由」之前,可以先來看一個更基本的問題,什麼樣的東西才算是一個演算法?
演算法大師 Knuth 把這件事整理成五個準則,這五點剛好可以當成今天這篇的路線圖,因為每一個都指向後面要處理的某一段。
| 準則 | 說的是什麼 | 指向 |
|---|---|---|
| Input(輸入) | 要有明確的輸入 | precondition |
| Output(輸出) | 要產生明確的輸出 | postcondition |
| Definiteness(明確性) | 每個步驟不能模稜兩可 | pseudocode |
| Effectiveness(可執行性) | 電腦要真的做得到 | Day 02 的計算模型 |
| Finiteness(有限性) | 要在有限步驟內結束 | 最後一節 |
Input 和 Output 聽起來像廢話,但「明確」兩個字後面其實代表一些問題:getMinIndex 的輸入可以是空陣列嗎?輸出保證是什麼?
Definiteness 說的是步驟的描述要讓看到的人能照著做、而且做出來的結果都一樣,就像食譜要讓廚師看得懂也做得到。
Finiteness 則是這篇文章晚點會談到的:憑什麼相信這個迴圈(或說是這段程式)會停?
第四點 Effectiveness 其實在 Day 02 已經見過了~
Day 02 在開始數操作次數之前,先約定了一組 Model of Computation(計算模型),用來說明哪些動作算是基本操作,以及這些操作各自需要多少成本。
Effectiveness 關心的是演算法中的每個步驟能不能實際執行,計算模型則是在這個基礎上描述各項操作的成本。若某個步驟根本不是電腦做得到的動作,那麼討論它需要花幾步也就沒有意義了。
回到前面說的,我們要的是「理由」,但理由要長什麼樣子呢?
第一步是把「正確」變成一個可以討論的命題,畢竟「這支函式是對的」沒辦法討論,「對」這件事太模糊、也沒有定義,但下面這句就可以:
演算法回傳一個位置
m,使得arr[m] <= arr[j]對陣列中的每一個位置j都成立。
這句話的意思是把 arr[m] 拿出來跟陣列裡任何一個元素比,它都不會比較大,這就是「m 是最小值的位置」的精確版本。
有了這個命題,再來看看測試與論證的差別:
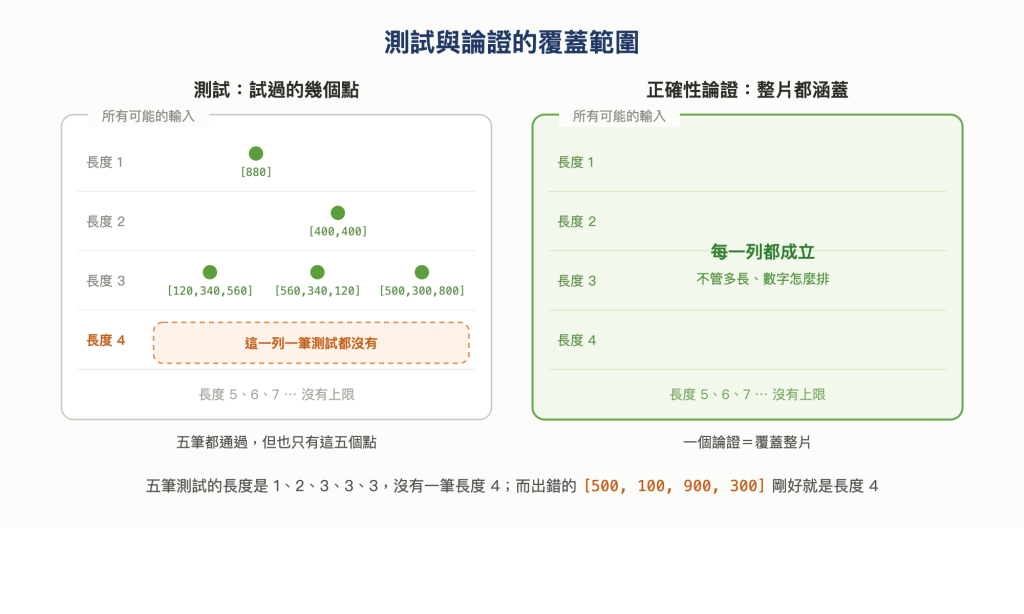
圖 2 測試與論證的覆蓋範圍
這裡的困難在於「所有合法的陣列」有無限多種,我們不可能一個一個試,所以論證得換個方式,找出一句在執行過程中始終成立的話,讓它替我們涵蓋掉所有步驟。
在說明論證前,先介紹一些等等會用到的名詞定義,確保大家能有一致的理解。
我們接下來會把函式換成 Pseudocode(虛擬碼)。它是用來描述演算法步驟的一種寫法,不屬於任何一種程式語言,也不需要能編譯或執行,目的只有一個,把「這個演算法要做什麼」講清楚、讓看的人能照著做。
因為不綁定語言,寫法上也就沒有統一規範,常見的是混用自然語言和少量符號,例如下面會用到 ← 表示指派,相當於 JavaScript 裡的 =:
getMinIndex(arr, len)
    minpos ← 0

    for i ← 1 to len − 1 do
        if arr[i] < arr[minpos] then
            minpos ← i
        end if
    end for

    return minpos
這裡用的已經是修好的版本,比較對象是 arr[minpos] 而不是 arr[i - 1]。另外可以注意到,pseudocode 習慣把陣列長度 len 也明寫成參數,而不是像 JavaScript 那樣用 amounts.length 取得,這同樣是為了不依賴特定語言的寫法。
換成 pseudocode 是為了只保留控制流程與比較規則,避免程式語言的細節分散注意力。
好的 pseudocode 的標準其實就是 definiteness:看的人能照著做,而且做出來的結果都一樣。太細會被實作細節淹沒,太粗會出現「這一步到底要做什麼」的歧義。
接著介紹 Precondition。
先給一句話的定義:
Precondition(前置條件)描述的是,演算法開始執行時,我們假設世界是什麼樣子。
以 getMinIndex 來說,它的 precondition 有兩個:
len 是大於等於 1 的整數arr 至少包含 len 個可以互相比較的元素,因此 arr[0] 到 arr[len-1] 都是有效的位置為什麼需要第一條呢?因為演算法第一行就寫了 minpos ← 0,它預設了「至少有第 0 個元素存在」,所以空陣列本來就不在這個演算法的處理範圍內。
這是我們主動劃出來的邊界,並不是 bug,若沒有先講清楚 precondition,任何人都可以丟一個空陣列進來然後說「你看,你的演算法錯了」,因此正確性永遠是相對於前提而言的。
相對地,另一個名詞是 Postcondition,定義為:
Postcondition(後置條件)描述的是,演算法停下來時,保證會成立的事。
一樣以 getMinIndex 來說,postcondition 就是前面那個命題:
minpos 滿足 0 <= minpos <= len - 1
arr[minpos] <= arr[j] 對每一個 0 <= j <= len - 1 都成立這裡先處理的是:只要 precondition 成立,演算法停下來時 postcondition 就一定成立。演算法是否一定會停,則是完整正確性的另一部分。
現在目標很明確了,我們要從 precondition 走到 postcondition,而中間隔著一個會跑很多輪的迴圈,這正是難的地方。
迴圈的麻煩在於它跑幾輪取決於輸入,陣列有 4 筆就跑 3 輪、有 100 萬筆就跑近 100 萬輪,我們不可能把每一輪都寫出來檢查。
解法是換個問法,與其追蹤每一輪發生了什麼,不如找出一句話,讓它在每一輪都成立。
先來想像一個具體的畫面,你正在手動處理這批訂單、一筆一筆往下看,手邊有一張便條,上面寫著「目前為止看過的訂單裡,最便宜的那筆在第幾個位置」,每看完一筆就更新一次便條。
從頭到尾,便條上那句話都成立:它記的永遠是「已經看過的範圍內」最便宜的位置。等到最後一筆看完,「已經看過的範圍」就等於「全部的訂單」,於是這句話自動變成「整批訂單裡最便宜的位置」,不需要再回頭重看任何一筆。
minpos 就是那張便條。
不過這個比喻有一個地方會有問題,便條是一份「資料」,我們要的卻是一句「關於這份資料的保證」,開場那支壞掉的程式一樣有便條、一樣每看完一筆就更新,它只是記錯了。
有便條,不等於便條上的話是真的。 有 minpos 這個變數,不代表它指的位置就是對的,這就是為什麼我們得把那句話單獨拿出來寫清楚。
現在我們先把訂單放一邊、換回中性的 arr,因為要證明的並不只是「這批訂單」會對,而是任何一個滿足 precondition 的陣列都會對。
那句關於保證的話會長怎樣呢?可以寫成這樣:
Loop Invariant(迴圈不變量):在每一次索引為
i的迴圈開始之前,arr[minpos]是arr[0..i-1]之中的最小值。
也就是說 minpos 指向的是目前已檢查範圍中的最小元素,而這個已檢查範圍 arr[0..i-1],就是便條上「已經看過的訂單」。
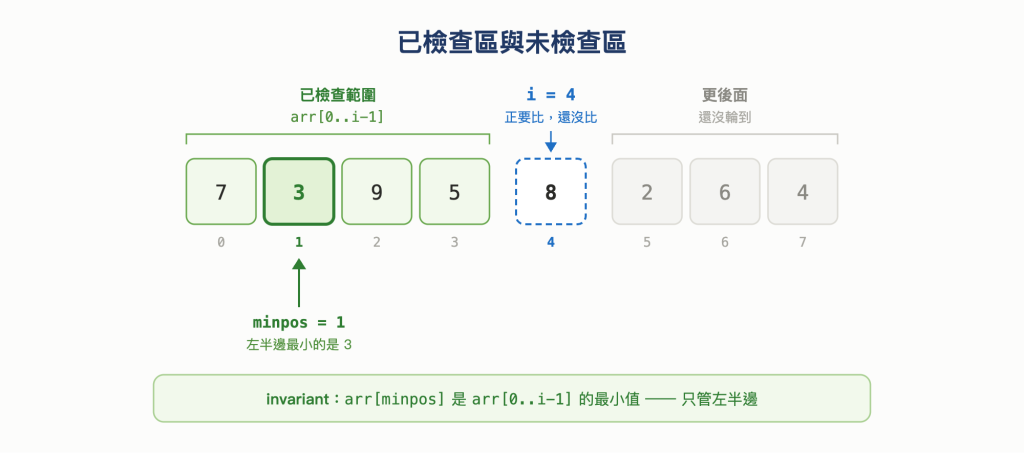
圖 3 已檢查區與未檢查區:minpos 只保證是左半邊的最小值
現在回頭看那支壞掉的版本,就能說清楚它錯在哪了。arr[i - 1] 只能維持「這一筆比前一筆小」,這個性質不足以推出我們要的 postcondition。
寫下 invariant 之後,要證明它真的一路成立,標準做法是拆成三步。
這裡的 Termination 指的是「迴圈結束時能推出什麼」;至於迴圈是否一定會結束,則屬於 finiteness 的問題。
第一次進入迴圈時 i = 1,而在那之前演算法只做了一件事:
minpos ← 0
此時已檢查範圍是 arr[0..0]、裡面只有 arr[0] 一個元素,而一個只有單一元素的範圍,那個元素當然就是其中的最小值,所以 minpos = 0 確實指向 arr[0..0] 的最小元素,invariant 在第一輪開始前成立。
這一步看起來雖然像廢話,但後面所有推論都要從一個已知成立的起點開始,少了它整串就接不下去。
這是三步裡最關鍵的一步。
假設在索引為 i 的迴圈開始前,invariant 成立,也就是 arr[minpos] 是 arr[0..i-1] 中的最小值。接著演算法會拿 arr[i] 和 arr[minpos] 比較,只有兩種情況。
Case 1:arr[i] < arr[minpos]
因為 arr[minpos] 已經是 arr[0..i-1] 中的最小值,而 arr[i] 又比它更小,所以 arr[i] 比 arr[0..i-1] 裡的每一個元素都小,此時演算法執行 minpos ← i,更新後的 arr[minpos] 就是 arr[0..i] 中的最小值。
Case 2:arr[i] >= arr[minpos]
新元素沒有比目前的最小值更小、不需要更新,原本的 arr[minpos] 仍然是 arr[0..i] 中的最小值。
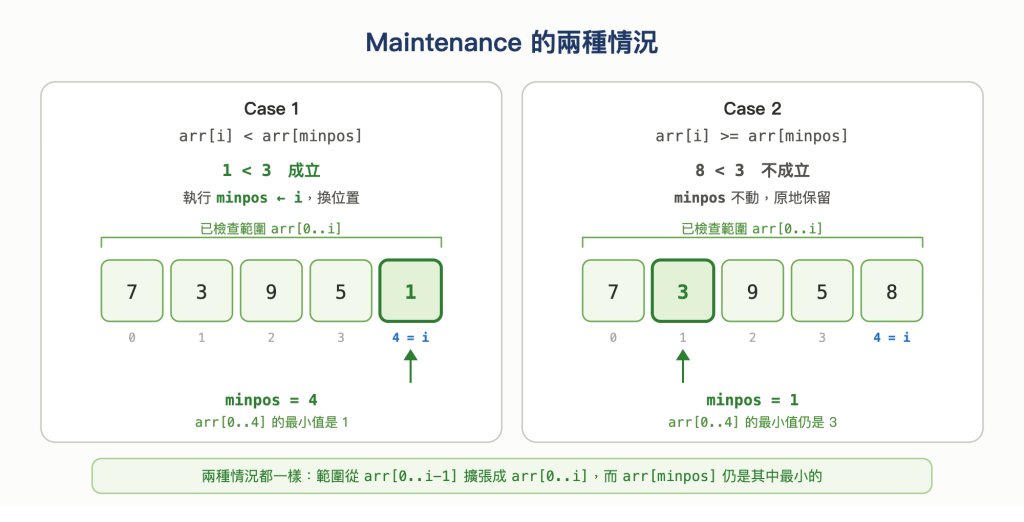
圖 4 Maintenance 的兩種情況
兩種情況都得到同一個結論,這一輪結束後 arr[minpos] 是 arr[0..i] 中的最小值。
而下一輪的索引是 i + 1,它要求的 invariant 是「arr[minpos] 是 arr[0..(i+1)-1] 的最小值」也就是 arr[0..i] 的最小值,這正好就是我們剛剛推出來的結論,所以只要這一輪開始前成立,結束後也會成立,而且剛好銜接上下一輪的要求。
迴圈在 i 超過 len - 1 時結束,此時已檢查範圍是 arr[0..len-1],也就是整個陣列。
把這個代進 invariant:
arr[minpos]是arr[0..len-1]中的最小值。
而 arr[0..len-1] 就是全部的元素,所以 arr[minpos] <= arr[j] 對每一個 j 都成立,這句話正是我們前面寫下的 postcondition。
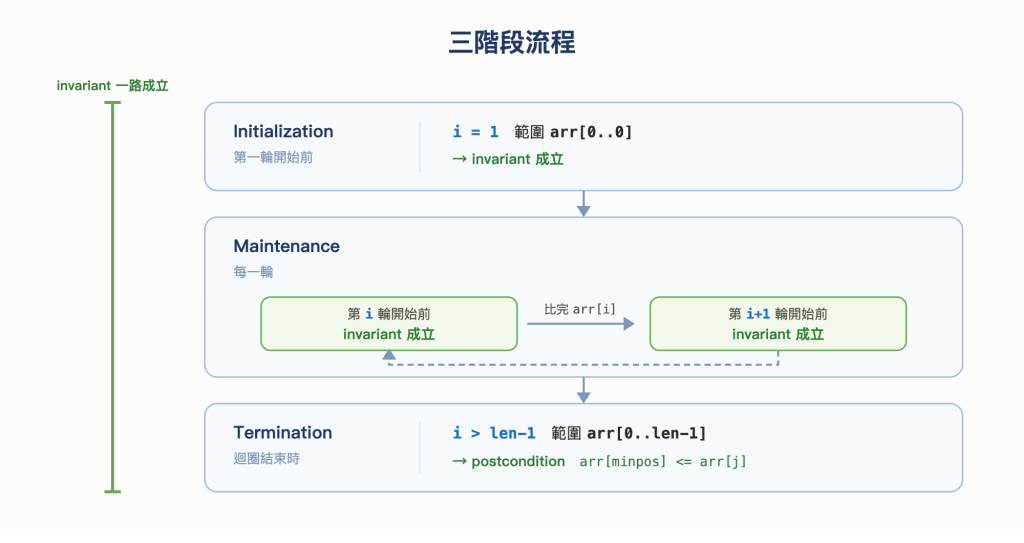
圖 5 三階段流程:invariant 從起點一路傳到終點
到這裡,我們證明了只要迴圈結束,postcondition 就會成立,不管陣列有多長、數字怎麼排列都一樣。
若前面的 Initialization 和 Maintenance 看起來有點眼熟,別懷疑,因為它們就是數學歸納法的形狀~
歸納法的形狀是這樣的,想證明某句話對所有的 n 都成立,只要做兩件事:
k 個情況成立,那對第 k+1 個情況也成立」(inductive step)有了這兩件事,就等於有了一條可以無限延伸的鏈子:第 1 個成立,所以第 2 個成立,所以第 3 個成立⋯⋯不管指定多大的 n,都有一條有限長度的推論路徑通到它。
將歸納法和剛剛提的 Loop Invariant 做個簡單對照:
| 歸納法 | Loop Invariant |
|---|---|
| Base case | Initialization(第一輪開始前成立) |
| Inductive step | Maintenance(第 i 輪成立推出第 i+1 輪成立) |
Initialization 和 Maintenance 對應數學歸納法的結構,而 Termination 是在迴圈結束時,利用已經成立的 invariant 推出 postcondition。
這也解釋了為什麼 Maintenance 一定要寫成「假設這一輪成立,推出結束後成立」,而不是直接說「每一輪都會成立」,因為後者是我們要的結論、不能拿來當理由用,前者才是那條可以一路傳遞下去的鏈子。
理解這一層之後,「證明一個迴圈」的流程就會變成:找出那句一路成立的話,證明它一開始成立、證明它能傳給下一輪,然後看它在終點變成什麼。
還有最後一件事沒有談到,回到 Knuth 五準則的最後一項:finiteness,演算法要在有限步驟內結束。
這件事其實藏在前面的論證裡,Termination 那一步我們是假設迴圈會結束、才去看它結束時的狀態,但萬一它根本不會結束呢?那前面推得再漂亮也沒用,一個跑不完的程式不會給你答案。
所以嚴格來說,正確性有兩個部分:
getMinIndex 的第一部分很好說明,i 從 1 開始、每一輪固定加 1,而迴圈條件是 i 不超過 len - 1,一個每輪都嚴格變大又有上限的數字不可能一直增加下去,所以迴圈一定會在有限輪之後停下來。
抽象成通則就是:要證明一個迴圈會停,就找出一個每輪都嚴格朝同一個方向變化、而且變化不能無止盡的量。
在 getMinIndex 裡這個量是 i(遞增、有上界),換成其他演算法,它可能是「還沒處理的元素個數」(遞減、不會小於 0)或其他形式,道理都一樣。
小小總結一下今天對演算法正確性的認識~
接下來開始進入具體的資料結構,時間、空間與正確性也會在後面的文章反覆出現。下一篇先從 Array 開始介紹~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術