
昨天講了 trace 的原理,今天講產生它的工具:OpenTelemetry,通常簡稱 OTel。
這篇要回答三個問題:它為什麼會出現、它包含哪些東西、還有那個叫 Collector 的中繼站到底在幹嘛。最後把 Tempo 和 Collector 裝起來,讓路先通,明天再讓資料流過去。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=false LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
在 OTel 之前,情況大概是這樣:你選了一家監控廠商,就要在程式碼裡裝他們家的 SDK、用他們家的 API 埋點。然後有一天你想換一家,所有埋點的程式碼都要重寫一次。
這叫廠商鎖定(vendor lock-in),而且鎖得特別死,因為埋點散落在整個程式碼庫裡。
OTel 的解法是把「產生資料」跟「儲存資料」拆開。產生這一端由 OTel 標準化,你用它的 API 埋點;儲存那一端愛用誰用誰,Tempo、Jaeger、或任何商業服務都行。換後端時改的是設定檔,不是程式碼。
它由 CNCF 維護,也就是管 Kubernetes 的同一個基金會,是裡面活躍度數一數二的專案。選一個標準最怕它三年後沒人維護。
「OpenTelemetry」這個詞會指三個不同層次的東西,一開始很容易混淆:
| 層次 | 是什麼 | 你怎麼用它 |
|---|---|---|
| 規格 | 資料長什麼樣、欄位怎麼命名 | 不直接用,但要知道它存在 |
| SDK / API | 各語言的函式庫 | 裝進你的程式裡(明天) |
| Collector | 一個獨立執行的中繼程式 | 部署在叢集裡(今天) |
另外 OTel 管的不只是 trace。它把三大支柱都納入了,官方稱為三種 signal(訊號):traces、metrics、logs。
不過成熟度不同,trace 最成熟、metrics 次之、logs 最晚。所以現在很常見的組合是 trace 用 OTel、metrics 繼續用 Prometheus,我這個系列就是這樣。這不是將就,是目前的主流做法。
這是我覺得 OTel 最被低估的部分。
REST 規範的是 API 本身——用 GET 還是 POST、路徑長什麼樣。但「記錄這個請求用了 GET」的那個欄位要叫什麼,從來沒人規定過,所以每個工具自己取:
| 誰 | 記 HTTP 方法的欄位 |
|---|---|
| Prometheus 的 Go 函式庫 | method |
| nginx 的 log | request_method |
| Django | request.method |
| Elastic | http.request.method |
| OTel(舊) | http.method |
| OTel(現在) | http.request.method |
連 OTel 自己都改過一次名。這系列已經遇過兩次同類的事:Day 13 的 service 撞成 exported_service,Day 14 的 structlog 用 event 不用 msg。還有一個天天在看的——Pod 名字在 Prometheus 和 Loki 都叫 pod,OTel 規定叫 k8s.pod.name,明天裝完 SDK 你的 trace 上就會出現第二種寫法。
欄位名不統一的後果是「所有 POST 請求的平均延遲」這種跨工具的查詢寫不出來,因為你不知道對方用哪個名字。
OTel 的 Semantic Conventions(語意慣例)就是一份約定:HTTP 請求的方法叫什麼、資料庫查詢的語句叫什麼、訊息佇列的主題叫什麼,全部規定好。好處是工具可以預先知道要找什麼——Grafana 能自動幫 trace 畫出服務關係圖,就是因為它知道 service.name 這個欄位一定叫這個名字。
這件事後面觀測 AI agent 的時候會變成主角——OTel 有一份專門給 GenAI 的語意慣例,規定了 token 數、模型名稱這些欄位怎麼命名。
最簡單的做法是每個服務直接把資料送給 Tempo。可行,但有幾個問題:
Collector 就是那個中間人:所有服務只認得它,它負責接收、處理、轉送。換後端改 Collector 的設定;要過濾個資,在 Collector 加一個處理器;昨天說的 tail-based 抽樣也在這裡做,因為只有它看得到完整的 trace。
Collector 的設定檔就是在描述一條管線。下面是 helm chart 預設值裡的 traces 那段,我把跟今天無關的 jaeger、zipkin 接收器拿掉了:
receivers:                    # 1. 怎麼收
  otlp:
    protocols:
      grpc:
        endpoint: ${env:MY_POD_IP}:4317
      http:
        endpoint: ${env:MY_POD_IP}:4318

processors:                   # 2. 收到後做什麼
  memory_limiter:             #    記憶體用到 80% 開始丟資料保命
    check_interval: 5s
    limit_percentage: 80
    spike_limit_percentage: 25
  batch: {}                   #    打包成批次再送,省網路

exporters:                    # 3. 送去哪
  debug: {}                   #    ← 預設只有這個,等一下會講

service:
  pipelines:                  # 4. 把上面三段串起來
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [debug]
四個區塊,讀起來很直觀:收什麼、做什麼、送去哪、怎麼串。pipelines 底下可以有多條,traces 一條、metrics 一條,各走各的處理器和目的地。
OTLP 是 OpenTelemetry Protocol,OTel 自己的傳輸協定,4317 是 gRPC、4318 是 HTTP。你會一直看到這個縮寫,它就是「用 OTel 標準格式傳資料」的意思。
memory_limiter 值得特別提。它的作用是當 Collector 自己記憶體吃太多時,主動開始丟資料。這是一種務實的設計:監控系統把自己搞掛,比丟掉一些遙測資料還糟。
| 模式 | 怎麼部署 | 適合 |
|---|---|---|
| Agent | DaemonSet,每個節點一份 | 收節點本地的東西,延遲低 |
| Gateway | Deployment,幾份共用 | 做需要看到全貌的事,例如 tail-based 抽樣 |
大型系統常常兩層都有:agent 收完送給 gateway,gateway 統一處理後送出去。我在本機只用 Gateway 模式一份,因為量小,而且好講解。
Tempo 是 Grafana 家存 trace 的資料庫,跟 Loki 是同一個思路——只對少數欄位建索引,內容用物件儲存或檔案系統放。
helm install tempo grafana/tempo -n monitoring --version 1.24.4
就這樣。這是這個系列第一個照預設值裝就能用的 chart:單機模式、檔案系統儲存、OTLP 的 4317 和 4318 兩個接收埠都開著。注意 repo 裡另外有一個 grafana/tempo-distributed,那是微服務模式,本機不要裝那個。
Collector 的 chart 在另一個 repo:
helm repo add open-telemetry https://open-telemetry.github.io/opentelemetry-helm-charts
helm repo update
然後我照文件裝,helm template 直接失敗:
[ERROR] 'image.repository' must be set.
第一個坑:chart 刻意不給預設 image。 Collector 有三種發行版——core、contrib、k8s——各自包的元件不一樣,官方不替你決定,要自己選。本機用 otel/opentelemetry-collector-k8s,它是給 Kubernetes 用的精簡版,我們要的東西都在裡面。
補上之後換一個:
[ERROR] 'mode' must be set.
第二個坑:部署模式也沒有預設。 就是上面那張表,本機選 deployment。
這兩個補上就裝得起來了,Pod 會 Running。但這時候的 Collector 跟 Day 15 的 Alloy 一樣——活著,但沒用。
第三個坑:預設的 exporter 只有 debug。 看上面那段設定的第三區塊,Collector 收到 trace 之後只會把它印到自己的 stdout,不會送去任何地方。Tempo 那邊永遠收不到東西,而且沒有錯誤,因為「印到 stdout」就是它被設定的行為。
要加一個送去 Tempo 的 exporter。這裡有第四個坑:otlp 這個 exporter 已經改名叫 otlp_grpc,網路上絕大多數教學還在寫舊名。chart 有一個 rewriteDeprecatedComponentNames 選項預設會幫你自動改,但設定檔裡直接寫新名字比較不會混淆。
第五個坑:叢集內的 gRPC 沒有 TLS,要明講 insecure: true。 不寫的話 Collector 會嘗試用 TLS 連 Tempo,握手失敗,trace 送不出去。這條我是先查到文件才沒踩,但看起來是最多人撞的一個。
五個坑都補上的設定檔,在 repo 的 helm/otel-collector-values.yaml:
mode: deployment
fullnameOverride: otel-collector       # Service 會叫這個名字

image:
  repository: otel/opentelemetry-collector-k8s

config:
  exporters:
    otlp_grpc/tempo:
      endpoint: tempo.monitoring.svc.cluster.local:4317
      tls:
        insecure: true
  service:
    pipelines:
      traces:
        receivers: [otlp]
        processors: [memory_limiter, batch]
        exporters: [otlp_grpc/tempo]
config 底下寫的東西會跟 chart 的預設值合併,所以 receivers 和 processors 不用重寫,只要補 exporter 跟改 pipeline。
helm install otel-collector open-telemetry/opentelemetry-collector \
  -n monitoring --version 0.173.1 -f helm/otel-collector-values.yaml
kubectl get pods -n monitoring | grep -E "tempo|otel"

跟 Day 15 加 Loki 一樣:Connections → Data sources → Add data source → Tempo → Install,網址填:
http://tempo.monitoring.svc.cluster.local:3200
3200 是 Tempo 的查詢 API,4317 是收資料的,別填錯。
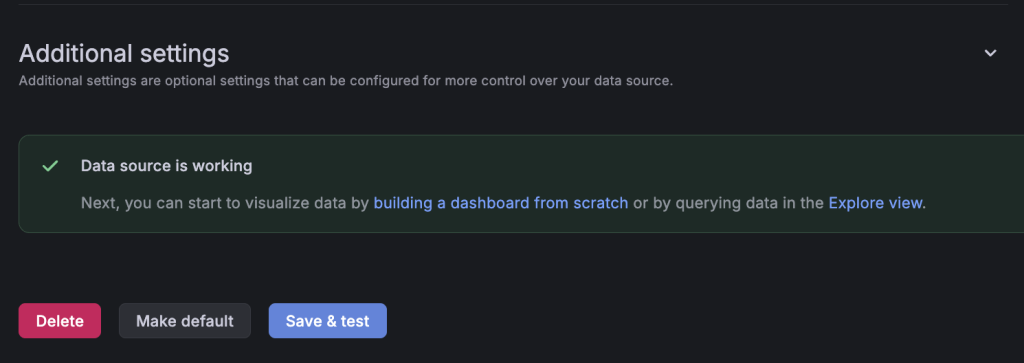
路應該是通的:服務 → Collector 的 4317 → Tempo 的 4317 → Grafana 從 3200 查。但 Day 15 的教訓是 Running 不代表通,所以我手動送了一筆假的 trace 進去驗證——在叢集內起一個臨時 Pod,用 curl 對 Collector 的 4318 送一個 OTLP 的 JSON,兩秒後 Tempo 就查得到那個 span。指令放在文末。
這裡有一個小坑:kubectl port-forward 打不進 Collector。 chart 預設把接收埠綁在 Pod 自己的 IP 上(設定裡那個 ${env:MY_POD_IP}),不是 0.0.0.0,而 port-forward 是從 Pod 內部連 localhost,會被拒絕。叢集內走 Service 沒有這個問題,明天服務送 trace 是從叢集內送的,不受影響;只是想從自己電腦測的話要換方法。
現在還沒有真的資料流過去,因為我的程式還不會產生 trace。那是明天的事。
明天是這 30 天唯一要認真寫程式的一天:把 trace 埋進三個服務。


 iThome鐵人賽
 看影片追技術