
今天是這 30 天唯一要認真寫程式的一天。
instrumentation(埋點)的意思是在程式裡加上產生遙測資料的程式碼。它分自動和手動兩種,我兩種都會用,因為它們解決的問題不一樣。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=true LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
後半要驗證一件事:加了 span 屬性之後,故障一從 trace 也查得到。
先講好消息。Python 的 OTel 有一個叫 opentelemetry-instrument 的指令,用它去啟動你的程式,不用改任何一行程式碼就有 trace。
requirements.txt 加四個套件:
opentelemetry-distro==0.65b0                   # SDK + opentelemetry-instrument 指令
opentelemetry-exporter-otlp==1.44.0            # 把 span 用 OTLP 送給 Collector
opentelemetry-instrumentation-fastapi==0.65b0  # 收到的請求
opentelemetry-instrumentation-httpx==0.65b0    # 送出的請求
版本號 0.65b0 那個 b 是 beta。埋點套件到現在還是 beta,SDK 本身(1.44.0)才是正式版,這是 OTel Python 的現況,用是可以用,只是升版時要留意。
然後 Dockerfile 改兩處。啟動指令前面加上那個工具:
CMD ["sh", "-c", "opentelemetry-instrument python -m uvicorn ${SERVICE_NAME}.main:app --host 0.0.0.0 --port 8000"]
再加幾個環境變數:
ENV OTEL_SERVICE_NAME=${SERVICE} \
    OTEL_TRACES_EXPORTER=otlp \
    OTEL_METRICS_EXPORTER=none \
    OTEL_LOGS_EXPORTER=none \
    OTEL_PYTHON_FASTAPI_EXCLUDED_URLS="metrics,healthz"
第一行是服務名,會變成 trace 上的 service.name,就是昨天講的語意慣例裡那個欄位。中間三行只開 trace——metrics 繼續給 Prometheus、log 繼續給 Loki,不然預設三種都會往 Collector 送。最後一行把 /metrics 和 /healthz 排除,不然 Prometheus 每 15 秒抓一次指標,每次都會多一條沒意義的 trace。
Collector 的位址不寫在 image 裡,放 k8s manifest 的環境變數:
- name: OTEL_EXPORTER_OTLP_ENDPOINT
  value: "http://otel-collector.monitoring.svc.cluster.local:4317"
它是怎麼做到不改程式碼的?原理是猴子補丁(monkey patching):程式啟動前,把常見函式庫的關鍵函式換成包裝過的版本。你呼叫 httpx.post() 的時候,實際執行的是「開一個 span → 呼叫原本的函式 → 關掉 span」。所以它涵蓋的範圍就是它認得的那些函式庫——FastAPI、httpx、requests、資料庫驅動等等。
而且昨天講的上下文傳遞它也一起做掉了:httpx 的埋點會自動在送出的請求加上 traceparent 標頭,接收端 FastAPI 的埋點會自動解析它。這是自動埋點最大的價值。
image 版本從 0.1 升到 0.2,三個 manifest 的 image: 跟著改,然後:
docker build --build-arg SERVICE=pricing -t pricing:0.2 .
docker build --build-arg SERVICE=catalog -t catalog:0.2 .
docker build --build-arg SERVICE=gateway -t gateway:0.2 .
kind load docker-image pricing:0.2 catalog:0.2 gateway:0.2 --name obs
kubectl apply -f k8s/
image 從 274 MB 長到 331 MB,多的 57 MB 幾乎都是 gRPC 的函式庫,這是埋點的第一個成本。tag 改了所以 apply 之後 Deployment 會自己滾動更新,不用另外 restart。
一個小坑:apply 會把 yaml 裡的環境變數整組套回去,之前用 kubectl set env 打開的故障開關會被蓋成 yaml 寫的 false。部署完記得再開一次。
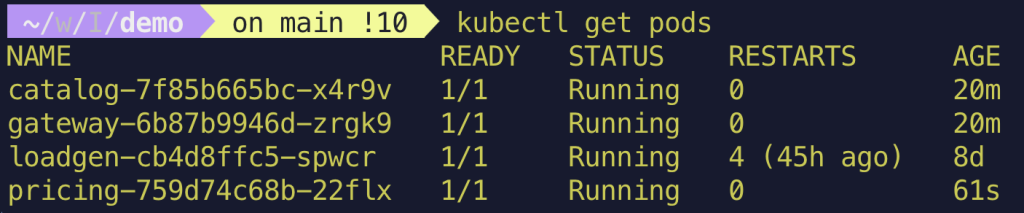
catalog 和 gateway 是 20 分鐘前 apply 時換的新 Pod;pricing 只有 61 秒,因為我剛用 set env 把故障一打開,它又重啟了一次。loadgen 還是 8 天前那個,它不需要 trace,image 沒動。
等 loadgen 打幾筆流量,到 Grafana 的 Explore,資料源選 Tempo,查詢語言是 TraceQL:
{ resource.service.name = "gateway" }
點進任何一條:
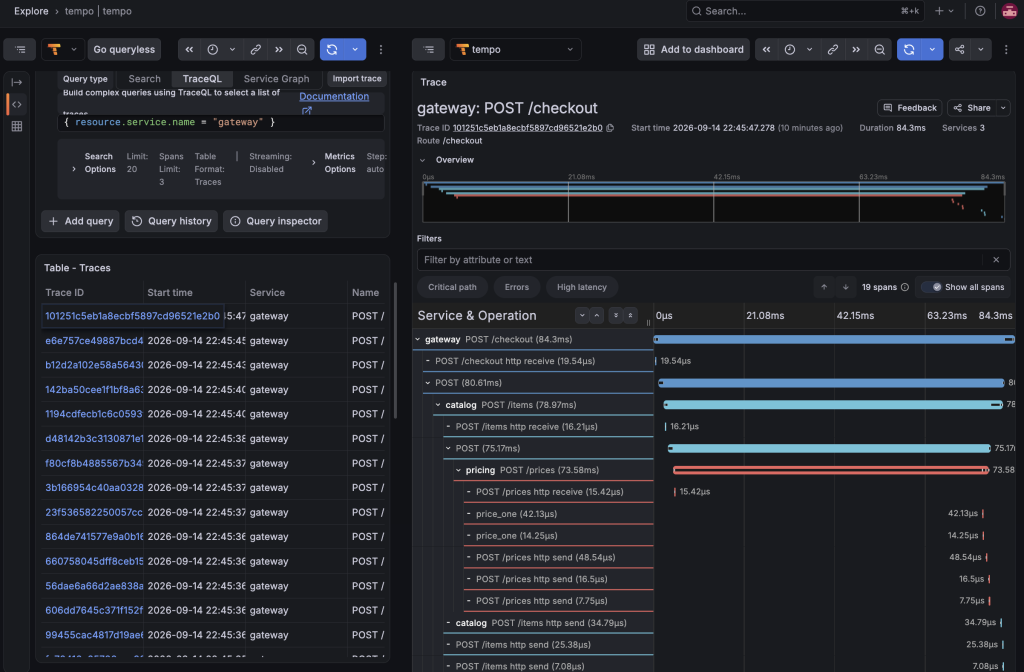
三個服務、一棵樹、每一段的耗時,全部在一個畫面上。昨天那張 ASCII 圖現在是真的了。右上角寫著 Services 3、19 spans、84.3ms。
讀法是由外往內看時間怎麼縮:gateway 84.3ms → 呼叫 catalog 80.6ms → catalog 79.0ms → 呼叫 pricing 75.2ms → pricing 73.6ms。每往下一層少一兩毫秒,那是網路和框架的開銷;pricing 一個人佔了 87%。
看的時候有一個雜訊要先知道:每個 HTTP span 底下會多出幾個叫 http receive 和 http send 的小 span,那是 FastAPI 埋點記錄的內部收送動作,每筆請求四個,時間都是幾十微秒,直接跳過。
還有一件事這張圖已經看得到,等一下講手動埋點的時候會回來:pricing 那條 73.6ms 底下,我自己開的兩個 price_one 加起來只有 56 微秒,剩下的 73 毫秒是空白。
打開那條 trace,span 的名字全是這種:
POST /checkout
POST /items
POST /prices
全部都是 HTTP 呼叫。因為自動埋點只認得函式庫,它不知道你的業務邏輯。它答不出的問題:
第二個問題正是第二個故障的關鍵——N+1 只在購物車超過 5 件時發生。沒有這個資訊,看到 12 個 span 也只能猜。這就是手動埋點的位置。
先把三個詞講清楚。span 是一段有開始和結束時間的工作,你可以把它想成一個碼錶。tracer 是發碼錶的人,每個服務有一個,在 common.py 用 trace.get_tracer(SERVICE) 拿到。屬性(attribute) 是貼在碼錶上的便利貼,一個鍵一個值,寫這段工作的細節。
一、自己開一個 span。 pricing 的 _price_one_nodb 是算一件商品價格的函式,自動埋點只認得 FastAPI 和 httpx,看不到它,所以要自己按碼錶:
from common import tracer

with tracer.start_as_current_span("price_one") as span:
    span.set_attribute("product.id", product_id)
    span.set_attribute("product.category", category)
    ...
with 這一行做的事是:進入區塊時按下碼錶,區塊裡的程式碼跑完、離開時按停,耗時就算好了,不用自己記時間。
名字裡的 as_current 是重點。任何時刻都有一個「當下的 span」,也就是現在正在計時、還沒結束的那個。這筆請求進來時 FastAPI 的埋點已經開了一個 POST /prices,它就是當下的 span;我的 price_one 在它裡面開,就自動變成它的小孩,火焰圖上會縮排一格掛在它底下。父子關係不用自己接。
還有一件事讓本機開發不會壞:如果程式沒有用 opentelemetry-instrument 啟動,get_tracer 會給你一個什麼都不做的假碼錶,with 區塊照跑,只是不記錄。所以 run-local.sh 不開追蹤也能跑。
二、加屬性。 有些地方不需要新的碼錶,只需要在現成的那個上面貼便利貼。catalog 那邊就是這樣,自動埋點已經幫 /items 開好 span 了,我只是把購物車大小寫上去:
from opentelemetry import trace

span = trace.get_current_span()                   # 拿到當下那個,不開新的
span.set_attribute("cart.item_count", n)
span.set_attribute("pricing.mode", "n_plus_one")  # 或 "batch"
注意這裡是 get_current_span,跟上面的 start_as_current_span 不一樣:一個是拿現成的,一個是開新的。
cart.item_count 這一行讓第二個故障變得可查,明天就能問「購物車超過 5 件的請求是不是特別慢」。
這裡有一件跟 Day 13 相反的事:屬性可以放高基數的值,標籤不行。 Day 13 講過 metric 的標籤是乘法——每一種不同的值都會生出一條新的時間序列,一直留在記憶體裡,十萬個使用者 ID 就是十萬條序列。但 span 的屬性只是那一筆紀錄裡的一個欄位,十萬個使用者就是十萬筆紀錄各寫各的,不會互相相乘,也不會常駐記憶體。所以使用者 ID、訂單編號、完整網址這些 Day 13 表格裡「不能加」的東西,放進 span 的屬性全部沒問題。
三、記錄例外。 故障一的那個 except:
try:
    discount = RULES[product_id]
    span.set_attribute("discount.rule_found", True)
except KeyError:
    log.warning("discount rule not found", product_id=product_id, category=category)
    discount_missing_total.labels(category).inc()
    discount = 0
    span.set_attribute("discount.rule_found", False)
span.set_attribute("discount.applied", discount)
同一個 except 裡現在有三種輸出:一行 log、一個 counter、兩個 span 屬性。三根支柱各拿一份。
Day 3 我寫過「故障一連 trace 也查不到,因為每個 span 都正常結束」。加了上面那兩個屬性之後,它變成查得到了。跟剛才看第一條 trace 一樣的地方——Explore、資料源 Tempo、Query type 選 TraceQL——把查詢換成:
{ span.discount.rule_found = false }
span. 開頭表示要找的是 span 的屬性(相對的,resource.service.name 那種是整個服務的屬性)。
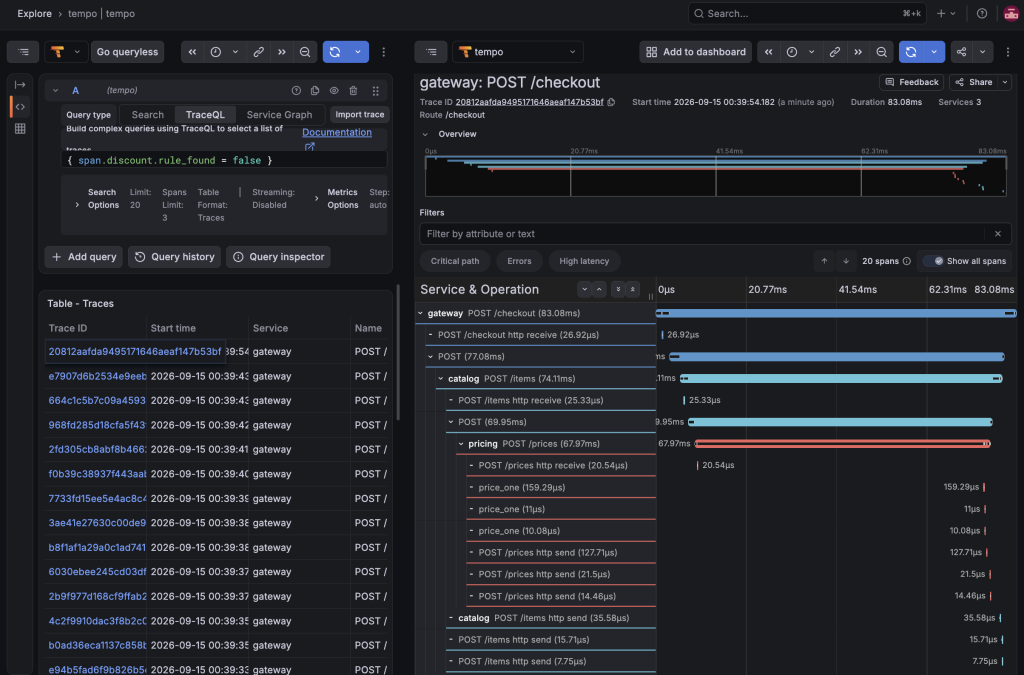
左邊列表每一條都是至少有一件商品沒套到折扣的訂單,右邊點開其中一條,從 gateway 進來、經過 catalog、到 pricing 的完整路徑都在——這是 log 給不了的。
右邊還有一個小細節:三個 price_one 裡有一個 159 微秒,另外兩個 11 和 10 微秒。慢那個就是踩到例外的——多印了一行 log、多加了一次 counter,比正常路徑慢十幾倍。微秒等級沒人在乎,但它示範了 span 的耗時真的會反映程式碼走了哪條路。
這說明了一件我原本沒想到的事:一個故障「哪根支柱查得到」,不完全是它的本質決定的,很大一部分是你埋了什麼決定的。三大支柱的分工是原則,不是宿命。
Day 14 講欄位的時候預留了 trace_id,今天填它。common.py 加一個 structlog 的處理器:
from opentelemetry import trace

def add_trace_context(logger, method_name, event_dict):
    ctx = trace.get_current_span().get_span_context()
    if ctx.is_valid:
        event_dict["trace_id"] = format(ctx.trace_id, "032x")
        event_dict["span_id"] = format(ctx.span_id, "016x")
    return event_dict
放進 structlog.configure 的 processors 清單,從此每一行 log 都帶著它所屬請求的 trace_id。我在本機用 Docker 起了 catalog 和 pricing、開著故障二送一筆 6 件的購物車,兩邊的 log 是這樣:
catalog   priced items              trace_id 22fa5b1a2b9a…
catalog   request                   trace_id 22fa5b1a2b9a…
pricing   discount rule not found   trace_id 22fa5b1a2b9a…
pricing   request                   trace_id 22fa5b1a2b9a…
pricing   request                   trace_id 22fa5b1a2b9a…
(共 6 次)
同一個編號。 Day 16 結案時那條「查不到的」——pricing 的 WARN 跟 gateway 的 checkout 對不起來——現在有了共同欄位。這也是明天「從 trace 跳到 log」的最後一塊拼圖。
順帶一提 /healthz 那行 log 沒有 trace_id,因為它被 OTEL_PYTHON_FASTAPI_EXCLUDED_URLS 排除了,沒有 span 就沒有 id。這是確認排除有生效最快的方法。
埋點有成本——執行時間、資料量、還有維護負擔。我的判準:
| 該埋 | 不該埋 |
|---|---|
| 跨服務、跨程序的呼叫 | 每一個函式 |
| 慢的操作(資料庫、外部 API) | 純計算的小函式 |
| 有業務意義的步驟 | 迴圈裡的每一圈 |
| 決定分支的關鍵資料 | 整包 request body |
「每個函式都開一個 span」是新手最容易犯的錯,結果是一條 trace 幾百個 span,火焰圖密到看不清楚,還拖慢程式。我今天手動開的只有 price_one 一個,其他都是加屬性。
但反過來的錯我自己就犯了。回頭看第一張火焰圖,pricing 那 73 毫秒裡有 60 毫秒是模擬資料庫的 time.sleep,而我沒有幫它開 span——它在圖上是一段空白。表格第二列寫「慢的操作該埋」,最慢的那個我剛好漏掉。火焰圖上的空白就是沒埋點的時間,看到大段空白,先問那裡在做什麼。
昨天預告過:上下文傳遞斷了,trace 就斷成兩截,而且不會有錯誤訊息。常見原因:
症狀是 Tempo 裡出現兩條各自獨立的 trace,而不是一條完整的。確認的方法是找一條 trace 看它跨了幾個服務,應該要三個,只有一個就是斷了。
我這次沒踩到,因為三個服務都用 httpx、都沒有背景任務。但如果你的服務多一個非同步的通知,那條多半就是斷的。
明天是 Traces 區塊的最後一天:把三大支柱串起來,從 P99 的圖跳到 trace、從 trace 跳到 log,然後破第二個案。


 iThome鐵人賽
 看影片追技術