
今天要介紹的是大家很常聽到也很常使用的 Array~
先從一個很日常的問題開始,假設我們手上有一百萬筆訂單資料,想拿到 orders[999999] 也就是最後那一筆,資料量這麼大,電腦是不是得從第一筆一路數過去、數完 999999 筆才到得了?
實際上不用,不管陣列多長,取 orders[999999] 和取 orders[0] 花的力氣幾乎一樣。但同一個陣列若想在中間插入一筆訂單,成本就會跟著資料量一起變大。
同一個資料結構,為什麼有些操作完全不受資料量影響,有些卻會?今天就來談這件事~
延續前幾篇的訂單情境,這次我們手上有一批當天的訂單陣列,已經照建立時間排好:
const orders = [
  { id: 'A-1001', amount: 1200 },
  { id: 'A-1002', amount: 890 },
  { id: 'A-1003', amount: 450 },
  { id: 'A-1004', amount: 2100 },
];
先給 Array(陣列)一句話的定義:
Array(陣列)是一組排好順序的元素,每個元素都有一個編號,可以用這個編號直接取用。
這個編號叫做 index(索引),多數程式語言從 0 開始算,而元素的數量叫做 size(大小),以上面這批訂單來說 size 就是 4。
為什麼需要陣列這個結構呢?
因為很多資料天生就有順序,而且我們常常是用「位置」在指涉它們,像是今天的第 3 筆訂單、排行榜的第 1 名、影片的第 120 個影格,這些情況下我們要的不只是「把資料存起來」,還要「存起來之後能用位置很快地把某一筆找回來」。
Array 就是為了這件事而存在的。
接下來整篇文章都會用這批訂單,看它被四種基本操作動過之後分別會發生什麼事:
| 操作 | 做的事 | 例子 |
|---|---|---|
| Read(讀取) | 給一個 index,拿回那個位置的值 | 拿 orders[2] |
| Search(搜尋) | 給一個值,找出它在哪個 index | 問「A-1003 排第幾?」 |
| Insert(插入) | 把一筆新訂單放進某個位置 | 補一筆漏掉的訂單 |
| Delete(刪除) | 把某個位置的訂單移除 | 取消一筆訂單 |
先從最單純的 Read 開始。在四種操作裡 Read 是最快的一種,不管陣列裡有 4 筆還是一百萬筆,取 orders[2] 和取 orders[999999] 的成本幾乎一樣。
但這件事沒有那麼理所當然,電腦並沒有「一眼看完整個陣列」的能力,那它憑什麼可以不碰前面的元素、直接抵達第 999999 個呢?要回答這個問題,得先看看資料在電腦裡是怎麼被放置的。
電腦裡真正負責運算的是 CPU(中央處理器),可以把它想像成一個做事非常快的小工人,我們寫的每一行程式最後都是交給它執行,但工人再快也得先拿到材料才能開工。這些材料也就是程式執行時要用到的資料,主要放在 storage 和 RAM 這兩個地方。兩者的差別說明如下表:
| Storage(儲存空間) | RAM(記憶體) | |
|---|---|---|
| 常見形式 | 硬碟、SSD、隨身碟 | 記憶體模組 |
| 關掉電源後 | 資料還在(persistent) | 資料消失 |
| 放什麼 | 音樂、影片、文件、程式本身 | 程式執行中的變數 |
| 存取速度 | 較慢 | 快很多 |
我們在程式裡宣告的每一個數字、字串、物件、陣列都是住在 RAM 裡面的,所以一支程式跑起來的時候,資料的流向大致是 CPU 需要某個值就去 RAM 把它拿過來、算完之後再放回 RAM,而今天要談的 Array 都放在 RAM 裡。
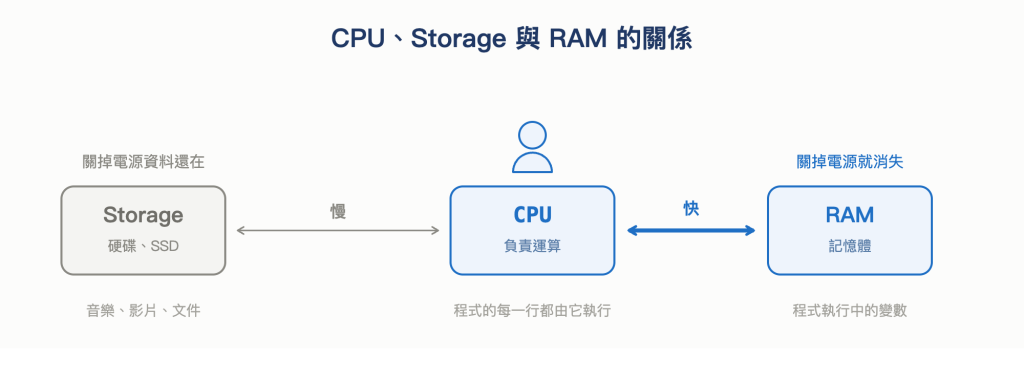
圖 1 CPU、storage 與 RAM 的關係
這裡用一個簡化過的版本來理解,把記憶體想成一長排格子,每一格都能放一點資料、也都有自己的編號,這個編號叫做 memory address(記憶體位址),從頭到尾連續遞增。
每一個記憶體格子能放的資料量是固定的,通常是 1 個 byte 也就是 8 個 bit(1 個 bit 就是一個 0 或 1),所以一個變數常常不只佔一格,例如 var a = 1 這樣一個數字,若用 32 bit 來儲存,實際上會連續佔掉 4 個記憶體格子。
(真實的記憶體比這個模型複雜得多,這裡只簡單說明)
在這個模型裡,電腦有一個很關鍵的能力:只要知道 address,就能直接跳到那一格,不需要從頭找起。
這件事之所以做得到,是因為 CPU 和記憶體之間還有一個叫做 memory controller(記憶體控制器)的角色,它負責實際去讀寫記憶體,而且連得到每一個 address,不需要從第一格開始一格一格往下找。
也就是說這個能力是硬體直接給的,而 Array 的整個設計就建立在這個能力上面。
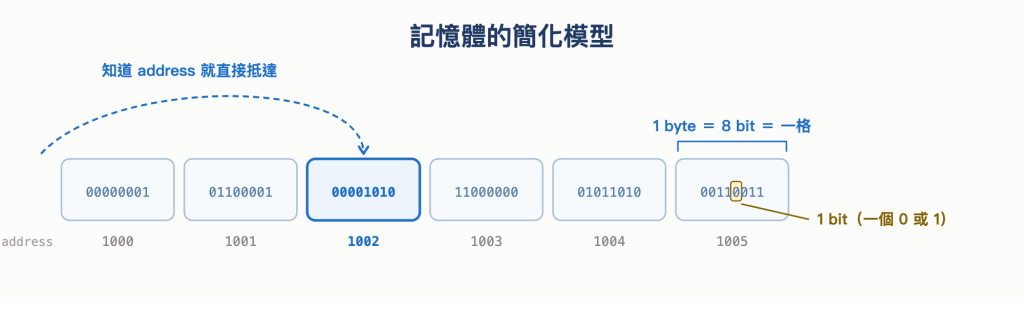
圖 2 記憶體的簡化模型:每一格都有編號,知道編號就能直接抵達
看到這裡可能會發現一件事,這個記憶體模型的描述跟前面 Array 的定義長得很像,記憶體每一格大小相同、每一格都有編號、編號連續遞增,這正好就是 Array 的特徵,所以其實可以這樣理解,記憶體本身就是一個超級大的 Array,只是它的 index 我們改叫 address,而且大到涵蓋整台機器。
那我們宣告的陣列又是什麼呢?其實就是從這個大 Array 裡切出連續的一小段、然後從 0 重新編號,這也是為什麼 index 和 address 之間永遠只差一個換算。
建立 Array 時,電腦會找一段連續的、空著的記憶體格子,把元素依序放進去,這可以想成健身房的置物櫃,編號 0 到 7 排成一列、每一格一樣大,中間不會突然插進一格特別寬的。
現在假設 0 號櫃就在你面前,有人要你去開 37 號櫃,你需要一格一格數過去嗎?不用,只要走過「37 格的寬度」就到了,也就是說我們是靠算的而不是靠數的,而能算的原因是每一格一樣寬。
而電腦也是類似概念,當我們指定要去開「37 號櫃」,電腦用計算的方式就直接抵達那個櫃子前面。(和置物櫃比喻稍微不同的是,在置物櫃的例子中,我們是用眼睛看、用腳走,過程中還是會「經過」前面那些櫃子,但電腦算出位置之後是直接抵達,中間那些格子完全沒有被碰到。)
「走過 37 格的寬度」這件事,如果寫成算式,就是下面這樣:
address = base + index × elementSize
其中 base 是 index 0 那個元素從哪裡開始、也就是 0 號櫃的位置,而 elementSize 則是一個元素佔掉幾個記憶體格子,例如 C 的 int 通常是 4 個(4 bytes)。
要注意這裡有兩種「格」:記憶體格子是 1 個 byte 的儲存單位,而 Array 的「一格」指的是一個元素、通常會連續佔掉好幾個記憶體格子,置物櫃比喻裡的一格櫃子對應的是後者。
所以要拿 index 3 的元素,電腦不會走訪 index 0、1、2,而是直接算出 base + 3 × elementSize 再跳過去讀那個位置裡面的東西。
電腦只記得 base 這一個位址,其他元素在哪裡它一概沒有記錄,全部都是要用的時候當場算出來的。所以一個一百萬筆的陣列,電腦真正記住的位址就只有一個。
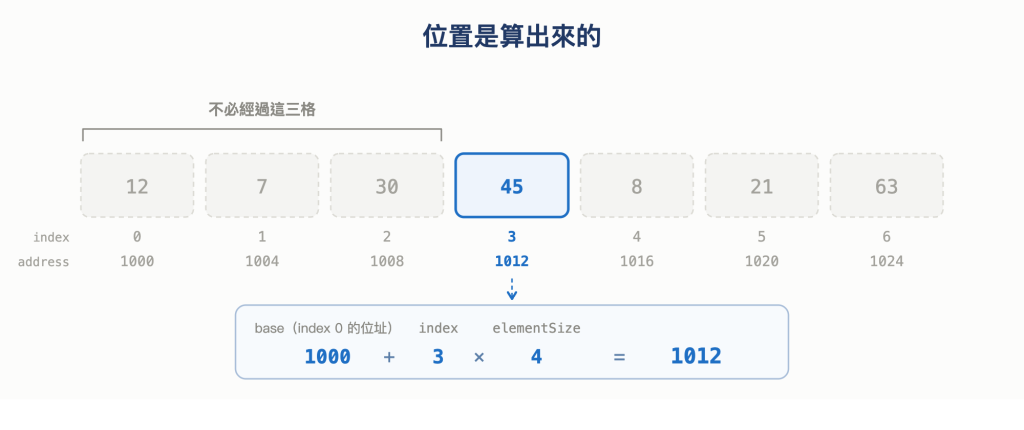
圖 3 位置是算出來的
這裡有一個地方要特別留意:每一格必須一樣大。
若格子大小不一,這條乘法就算不出來,只能從第一格開始一格一格量過去,才知道第 3 格從哪裡開始。所以 Array 快,是因為它的排列方式讓「位置」變成一件可以計算的事。
這個能力有一個專門的名字,稱作 Random Access(隨機存取)。
Random Access(隨機存取)指的是不論要取用哪一個位置,成本都相同,不需要先經過前面的元素。
「Random」在這裡比較接近「任意」而不是「隨機」,意思是任意一格都一樣快,而這個詞的來源就是 RAM,也就是 Random Access Memory(隨機存取記憶體)。
所以回到開頭那個問題,取 orders[999999] 為什麼不用走 999999 步呢?因為電腦根本沒有在走,它是算出來的。
順帶一提,這條算式還解釋了一件常被當成慣例的事,index 為什麼要從 0 開始?
因為 index 在這裡的意思是「距離起點有幾格」,而不是「第幾個」。第一個元素就住在起點上、距離是 0,代入算式就是 base + 0 × elementSize,剛好等於 base,若改成從 1 開始算,每次取值都得先減 1,算式反而多一個步驟。
所以 0-based 可以看成是這條算式的自然結果。
(這個說法最有名的出處,是 Dijkstra 在 1982 年寫的一份手稿〈Why numbering should start at zero〉,可參考文末 Reference)
到這裡我們了解了 Array 能快速定位的原理,一段連續的空間、每一格一樣大,位置可以用一次乘法算出來。不過實務上的資料不見得都是排成一條線的,若資料本身是二維的,這套機制還能不能用呢?
到目前為止談的都是一維的 Array 也就是排成一列的資料,但實務上我們很常遇到二維的資料,例如:
這種需要用「兩個編號」才能定位一個元素的結構就叫做二維陣列(2-D Array),取值的時候要給的是一組座標 (row, col) 而非單一 index,例如 grid[1][2] 表示第 1 列、第 2 行的那一格。
問題來了,記憶體就是一長排格子、並沒有「列」這種東西,那二維陣列到底是怎麼被放進這一長排格子裡的呢?
有兩種常見的做法,而且各有各的取捨。
第一種做法是把二維直接攤平成一維,先把第 0 列整列放好、接著把第 1 列接在後面,以此類推,假設有一個 2 列 3 行的表格,攤平之後會變成這樣:
二維的樣子                 攤平之後(one block)
┌───┬───┬───┐
│ a │ b │ c │             ┌───┬───┬───┬───┬───┬───┐
├───┼───┼───┤    ──▶      │ a │ b │ c │ x │ y │ z │
│ x │ y │ z │             └───┴───┴───┴───┴───┴───┘
└───┴───┴───┘               0   1   2   3   4   5
也就是說 (0,0)、(0,1)、(0,2) 佔了記憶體的前三格,(1,0)、(1,1)、(1,2) 接在後面佔第 3 到第 5 格,整張表格在記憶體裡就是一段連續的空間。
那要取 (row, col) 那一格時怎麼辦呢?一樣是用算的,只是算式要多包一層:
address = base + (row × 每列幾格 + col) × elementSize
括號裡那一段 row × 每列幾格 + col 在做的事情是先跳過前面 row 個完整的列(每一列有「每列幾格」這麼多格)、再往後走 col 格,算出來的就是「這一格攤平之後排第幾」,外面再乘上每格大小就得到實際的 address 了。
以剛剛那個 2 列 3 行的表格為例,若要取 (1, 2),步驟拆分如下:
row × 每列幾格 = 1 × 3 = 3,先跳過第 0 列的那三格col = 2,得到 5
(1, 2) 就是攤平後的第 5 格,也就是 z
整個過程只有一次乘法和幾次加法、沒有任何迴圈,所以二維陣列的存取一樣是 O(1),不會因為多了一個維度就變慢。
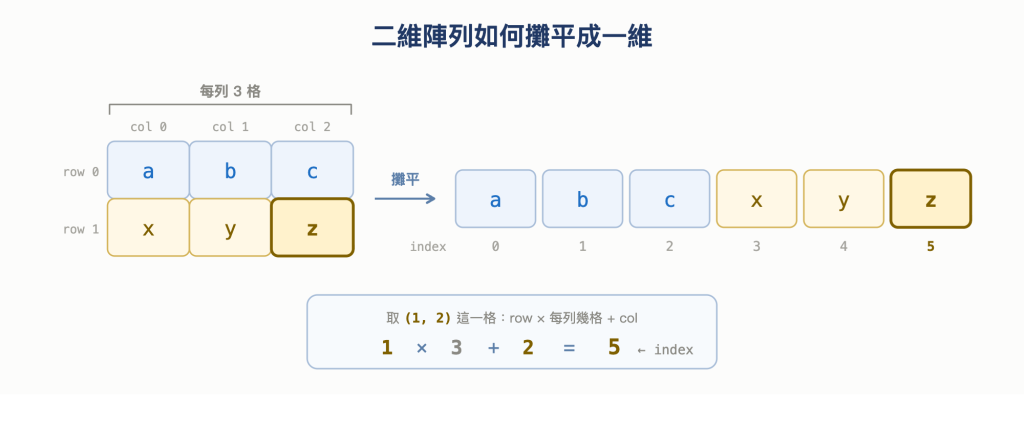
圖 4 二維陣列如何攤平成一維:靠「每列幾格」這個固定值換算座標
第二種做法則是不強求整塊連續,讓每一列各自佔一段連續記憶體、彼此可以散落在記憶體的不同地方,再另外用一小段空間記住每一列各自從哪裡開始。
「記住位置」具體是什麼意思呢?
前面提過每一格記憶體都有自己的 address,而 address 本身就是一個數字,既然是數字,它當然也可以被當成資料存進某一格,像這樣「內容是一個記憶體位址」的資料就叫做 pointer(指標),它記的是值在哪裡,而不是值本身。
      入口(存的是 pointer)
    ┌──────────┬──────────┐
    │  arr[0]  │  arr[1]  │
    │   1166   │   5566   │
    └────┬─────┴────┬─────┘
         │          │
         ▼          ▼
  位址 1166: a  b  c
  位址 5566: x  y  z
有了 pointer 之後,取 (row, col) 就變成兩個步驟:
row 去查出那一列的起始位址(這個「照著 pointer 去找它指向的地方」的動作叫做 dereference,解開指標)col 格比較 one block 和 array of arrays,差別如下表:
| one block(攤平成一段) | array of arrays(每列各一段) | |
|---|---|---|
| 空間 | 只需要元素本身的空間 | 元素之外,還要多一段空間存每一列的 pointer |
| 建立 | 一次跟系統要一整塊 | 要逐列配置,次數隨列數增加 |
| 取值 | 算一次位址 | 先查 pointer,再算一次位址(多一次 dereference) |
| 連續性 | 整塊連續 | 只有同一列內部連續,列與列之間不保證 |
| 寫起來的感覺 | 要自己把二維換算成一維 | 比較貼近人對二維的直覺 |
大致上,one block 通常比較快也比較省空間,array of arrays 則對寫程式的人比較友善,不用自己在腦中做座標換算。
回到 one block,攤平的方向其實決定了哪一個維度在記憶體裡是連續的。
前面示範的排法是「一列接一列」,這種方式叫做 row major(列優先),大多數程式語言(包含 C)採用的都是這一種。在這種排法下:
(0,0) 和 (0,1),在記憶體裡真的緊鄰(0,0) 和 (1,0),中間卻隔了一整列這件事完全不影響複雜度,不管從哪個方向走,走完整張表都是 O(N),加法次數也一模一樣。但它卻有可能影響實際執行時的速度。
連續存放在實際執行時會比較快,原因是 CPU 每次去記憶體拿資料時,不會只拿我們要的那一格,而是順手把附近一小段一起搬到離自己更近的快取(cache)。接下來如果剛好要用旁邊那格,就不必再跑一趟。
(這裡的 cache 指的是 CPU 和記憶體之間的硬體快取,和 Day 03 提過的那種「把計算結果存下來避免重複計算」的快取是不太一樣的)
拿一個 4096 × 4096 的整數表格來實測,同樣把全部元素加起來,加法次數完全一樣,只差在走訪順序(以下數值是寫文章當下量測結果,每個人跑出來的數值可能有差異):
| 走訪方式 | C | JavaScript |
|---|---|---|
| 逐列相加(位置連續) | 1.2 ms | 15.7 ms |
| 逐行相加(位置跳著) | 70.4 ms | 108.6 ms |
| 慢了幾倍 | 約 59 倍 | 約 6.9 倍 |
這裡只需要記住「連續存取比跳著存取快」這一句,記憶體階層本身不是這系列的主題><
補充:上面的數字怎麼測的(由 Claude Code 執行並量測)
機器是 Apple M1、Node.js v24.14.0、Apple clang 15。兩種語言都把二維表格攤平成一段連續空間,用
i * N + j取值,逐列與逐行只差在兩層迴圈的順序對調,其餘完全相同。單次計時的雜訊很大,所以程式裡已經內建多次執行取最小值,完整程式碼放在 gist:C 版cache.c、JavaScript 版cache.js。另外,C 和 JavaScript 的倍數不適合互比,這裡要看的是每一種語言各自的前後對比。
到這裡,Array 的儲存模型就完整了,簡單整理如下:
base + index × elementSize 算出來大家還記得最開始提的那批訂單嗎 XD,現在把它們拿出來,用上面那三句話逐一檢視。
O(1)Read 就是前面整節在講的那件事:給一個 index,用 base + index × elementSize 算出位置,跳過去把值讀回來。
三個動作,數量固定,和陣列有多長完全無關,所以是 O(1)。這也是 Array 最有價值的性質。
O(N)Search 是 Read 的反方向:Read 是「給 index 要 value」,Search 是「給 value 要 index」。
方向反過來,成本就不同了。為什麼呢?
因為電腦的能力是「知道 address 就能跳過去」,而不是「知道 value 就能跳過去」。沒有任何機制可以從一個值反推出它被放在哪一格。
所以只能一格一格看過去,這方法稱為 Linear Search(線性搜尋):
function indexOfOrder(orders, id) {
  for (let i = 0; i < orders.length; i++) {
    if (orders[i].id === id) return i;
  }
  return -1;
}
找 A-1003 要看 3 次。如果目標排在最後一筆,就要看 N 次;如果那筆訂單根本不存在,也要看完 N 次才能確定,所以是 O(N)。
Insert 的成本不是固定的,它取決於「要插在哪個位置」,這裡分三種位置來看。
O(1)最好的情況,是把新資料直接接在陣列的尾端。
因為電腦知道 base(起點在哪),也知道目前的 size(住了幾個),所以「下一個空位」的 address 直接算得出來,就是 base + size × elementSize。算完之後把值寫進去、size 加一,整件事就結束了。
過程中沒有任何一個既有元素被移動過,所以不管陣列裡原本有 4 筆還是一百萬筆,成本都一樣,是 O(1)。
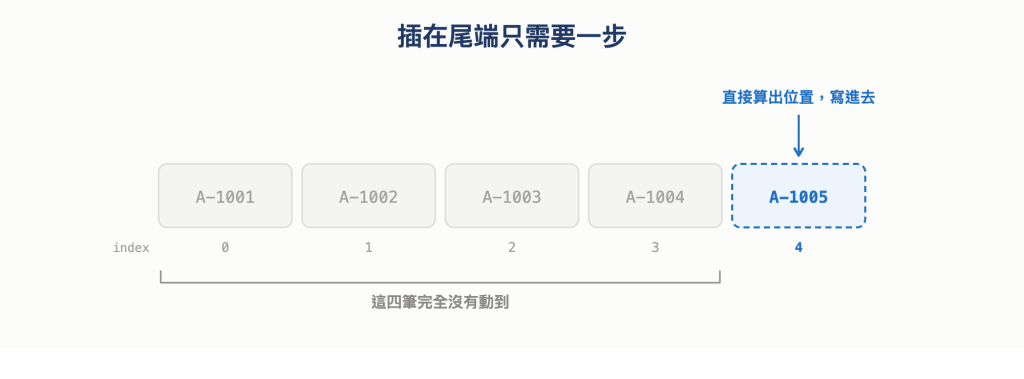
圖 5 插在尾端只需要一步:直接寫進下一個空位,既有元素不受影響
O(N)接著看比較麻煩的情況。假設早上漏掉了一筆訂單,現在要把它補在 index 1 的位置。
問題在於,index 1 現在已經有人住了,而 Array 又必須維持連續、中間不能有洞,所以沒辦法直接寫進去,得先把位置空出來,也就是把 index 1 以後的元素全部往右挪一格。
而且搬移的順序不能隨便,必須從最後面開始搬。
以四筆訂單、要插在 index 1 為例,完整流程如下:
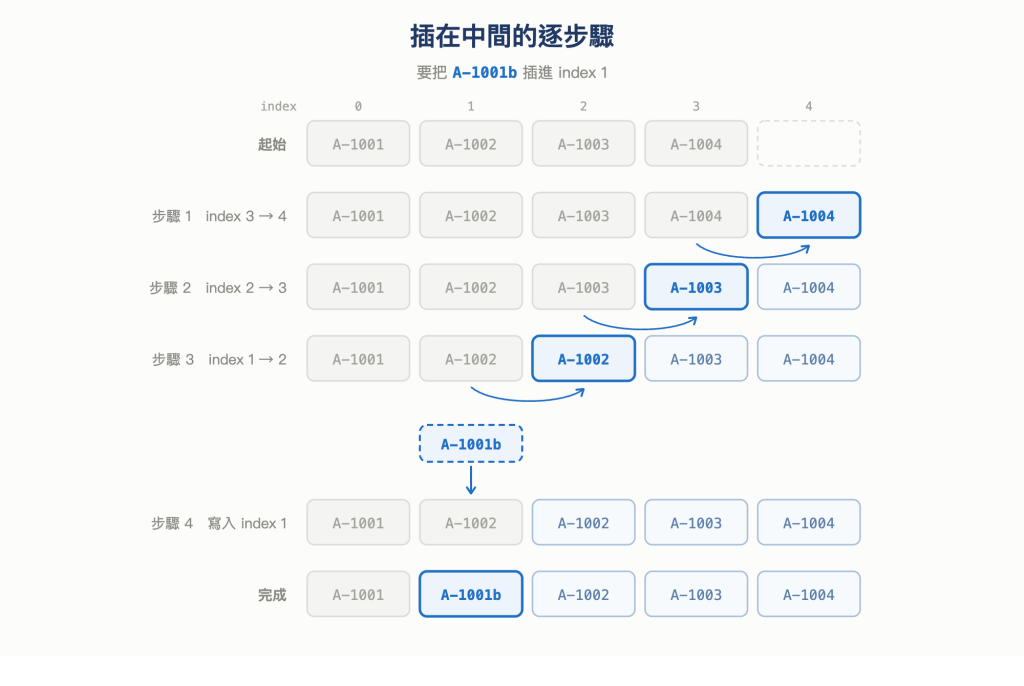
圖 6 插在中間的逐步驟:從最後面開始搬,才不會蓋掉還沒處理的資料
那為什麼一定要從後面開始呢?
這裡先別急著往下看,可以自己想一下:如果反過來,從 index 1 開始往後搬,第一步會發生什麼事?
第一步是把 index 1 的值寫到 index 2,但 index 2 原本住著的那筆資料還沒被搬走就這樣被蓋掉了,等到下一步要處理 index 2 的時候,會發現它已經變成剛剛複製過來的那一份、不再是原本的值,資料就這樣消失了。
從後往前搬則不會有這個問題,因為每一次要寫進去的那一格,內容都已經先被複製到更後面去了,蓋掉也沒關係。
最壞的情況是插在 index 0,因為這代表每一個既有元素都得往右挪一格。假設陣列原本有 N 個元素,這時要做 N 次搬移再加上 1 次寫入,總共 N + 1 步。
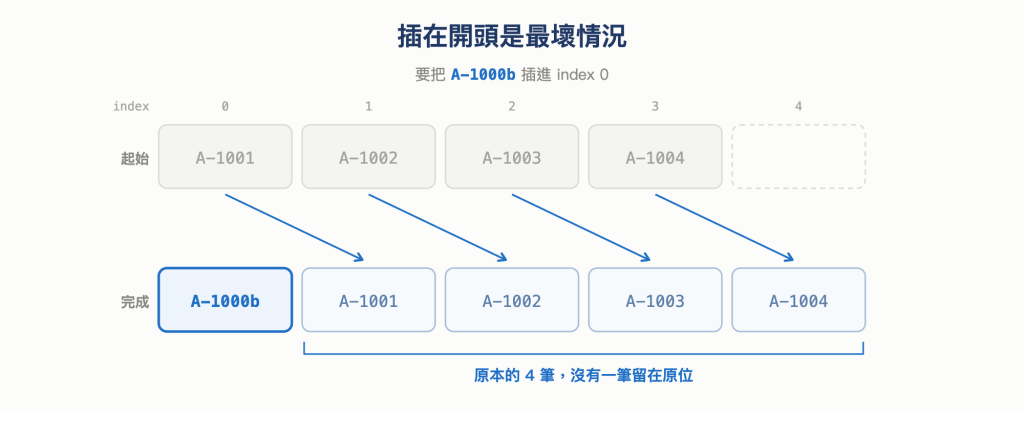
圖 7 插在開頭是最壞情況:沒有任何一個元素能留在原位
嚴格說起來,中間插入要搬幾次取決於「插入位置後面還有幾個元素」,所以插得越前面越貴,以 1000 筆資料為例,插在倒數第二格只要搬 2 次、插在最開頭則要搬滿 1000 次。我們在談複雜度時看的是最壞情況,因此尾端以外的 Insert 都記成 O(N)。
O(N)Delete 可以想成 Insert 的反方向。
Insert 是「先把後面的元素往右推,空出一格給新資料」,Delete 則是「移除一格之後,把後面的元素往左拉,把空缺補起來」。
為什麼一定要補起來呢?因為 Array 不能有洞,若中間留著一個空格,前面那條 base + index × elementSize 就會失效。洞後面那些元素的實際位置沒有變,但它們該有的 index 全部往前少了一個,於是 index 和元素就對不上了。
以四筆訂單、要刪掉 index 1 為例,流程如下:
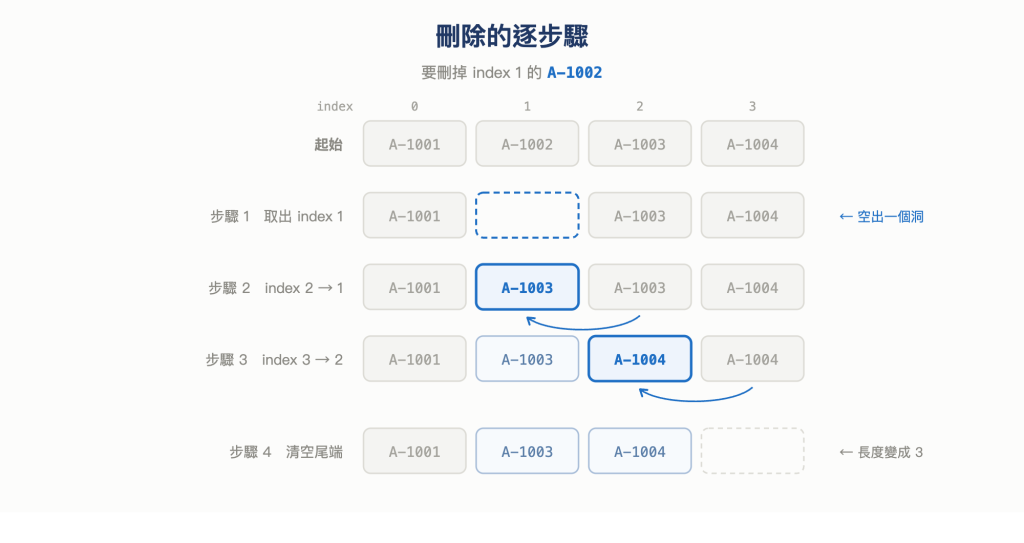
圖 8 刪除的逐步驟:和插入相反,被蓋掉的永遠是剛空出來的那一格
把 Insert 和 Delete 整理如下表:
| 元素往哪邊移動 | 處理的順序 | |
|---|---|---|
| Insert | 往右,挪出空位 | 從最後面那個元素開始往前 |
| Delete | 往左,補上空缺 | 從缺口那一格開始往後 |
兩欄剛好都相反,但背後是同一個理由:不要蓋掉還沒處理的資料。
最壞的情況是刪掉第一筆,剩下的 N − 1 筆全部都要移動,所以 Delete 也是 O(N)。
將上述四種操作整理成一張表格如下:
| 操作 | 成本 | 為什麼 |
|---|---|---|
| Read | O(1) |
位置可以直接算出來 |
| Search | O(N) |
無法從值反推位置,只能逐格檢查 |
| Insert(尾端) | O(1) |
下一個空位算得出來(前提是後面還有空位) |
| Insert(中間或開頭) | O(N) |
後方元素要往右挪出空間 |
| Delete | O(N) |
後方元素要往左補上空缺 |
從這張表格可看出,Array 的優點和缺點來自同一個設計。
位置可以計算,所以讀取很快;但要讓位置能被計算,index 就必須保持連續,所以中間的改動一定會牽動後面。
順帶把常用的 JavaScript 陣列方法也整理進來:
| 方法 | 成本 | 為什麼 |
|---|---|---|
arr[i] |
O(1) |
直接算出位址 |
push |
O(1) |
加在尾端,不動到別人(前提是後面還有空位) |
pop |
O(1) |
移除尾端,不動到別人 |
unshift |
O(N) |
加在開頭,後面全部要往右挪 |
shift |
O(N) |
移除開頭,後面全部要往左補 |
splice |
O(N) |
在中間增刪,之後的元素都要移動 |
indexOf、includes |
O(N) |
逐格比對,無法從值反推位置 |
可從上方發現一個規律,動尾端的成本都低、動開頭的都高,這是「index 必須連續」的直接後果,任何以連續 index 為基礎的結構都會長這樣。
接著把前面那兩個搬移包成一個類別,看看它們放在一起是什麼樣子~
這裡用一段固定長度的空間當底層儲存,對應前面講的那段連續記憶體:
class SimpleArray {
  constructor(capacity) {
    this.slots = new Array(capacity); // 一段固定長度的空間
    this.length = 0; // 目前住了幾個
  }

  get(index) {
    return this.slots[index]; // 直接定位,沒有迴圈
  }

  insertAt(index, value) {
    for (let i = this.length; i > index; i--) {
      this.slots[i] = this.slots[i - 1]; // 從後往前,把位置讓出來
    }
    this.slots[index] = value;
    this.length++;
  }

  removeAt(index) {
    const removed = this.slots[index];
    for (let i = index; i < this.length - 1; i++) {
      this.slots[i] = this.slots[i + 1]; // 從前往後,把空缺補起來
    }
    this.slots[this.length - 1] = undefined;
    this.length--;
    return removed;
  }
}
三個方法放在一起看,差異相當直接:get 沒有迴圈,insertAt 和 removeAt 各有一個,而迴圈要跑幾次取決於 index 的位置,最多跑 N 次。
不過 insertAt 完全沒有檢查 slots 還有沒有空位,如果 length 已經等於 capacity 會怎樣呢?迴圈第一步就會寫到 slots[capacity],也就是那段空間的外面。
而在 JavaScript 裡這樣做並不會報錯:
const slots = new Array(3);
slots[0] = 'a';
slots[1] = 'b';
slots[2] = 'c';
slots.length; // 3

slots[3] = 'd'; // 寫到那段空間的外面
slots.length; // 4  ← 沒有噴錯,陣列自己變長了
沒有噴錯其實比噴錯更麻煩,因為它悄悄破壞了我們一開始講好的前提:這段空間應該是固定長度的。一旦 slots 會自己長大,SimpleArray 就不再對應前面那個「一段連續、大小固定」的模型了。
所以這裡先假設空間永遠夠用,那真正的 JavaScript 陣列滿了會發生什麼事呢?接著就來看這件事~
先把 Array 分成兩種來看。
第一種是 static array,長度固定、建立的時候就要講好會放幾個元素,之後不會變,C++ 的 int a[20]; 就是這樣,一開始就跟記憶體要好 20 格的連續空間,好處是需求講得很明確、配置也單純,而這也正是 SimpleArray 對應的模型。
第二種是 dynamic array,可以長大。JavaScript、Python、Java 的陣列都屬於這一類,它們會自動根據目前的大小去配置記憶體,所以我們才能一直 push,不用先想清楚到底要放幾筆。
然而,「長大」這件事沒辦法就地完成。
一段連續記憶體是跟系統要來的,它後面緊接著的那些格子並不歸我們管,很可能早就被別的資料佔走了。所以不能只是把原本那段往後延長一點,唯一的做法是另外找一段更大的連續空間,把舊的元素整批複製過去,之後原本那段就用不到了。
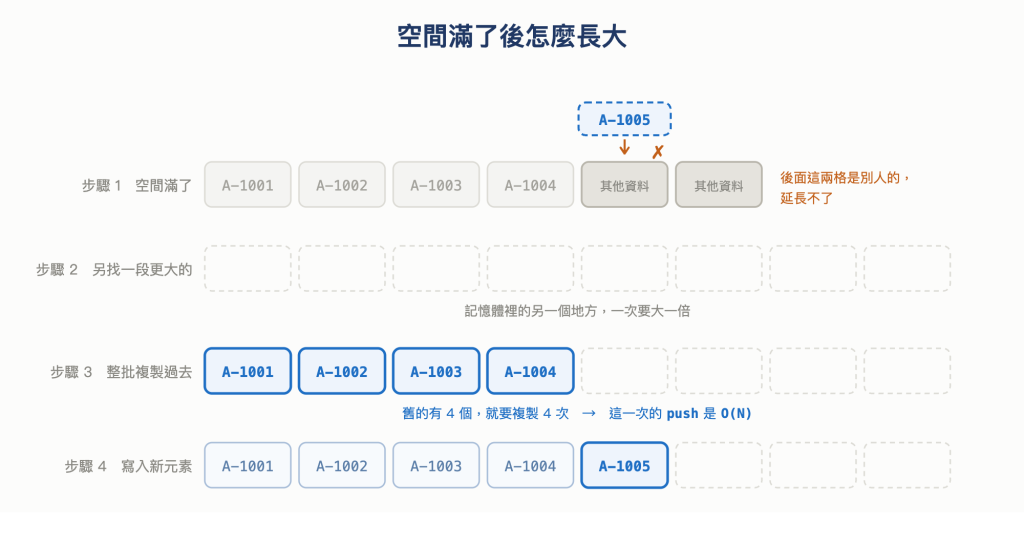
圖 9 空間滿了後怎麼長大
這個動作的成本很直接,舊的有幾個元素就要複製幾次。所以觸發到擴充的那一次 push,不是 O(1) 而是 O(N)。
也因為搬一次的成本不低,實作上通常不會只多要一格,而是一次要一塊大得多的(例如直接翻倍)。這樣接下來一段時間內的 push 都還有空位可以寫,不必每一次都搬。
所以 push 的成本要分兩種情況看,多數時候後面還有空位就是單純寫進去、是 O(1),偶爾遇到剛好滿了的那一次要整批複製、就是 O(N),前面表格裡那句「前提是後面還有空位」講的就是這件事。
而我們平常寫的 JavaScript 陣列可以一直 push 都不用管容量,是因為引擎在背後幫我們做完了上面那一整套搬移,只是這件事平常看不出來。
SimpleArray 照著前面的模型設計,但實際在用的程式語言就沒這麼單純了,它們各自做了不同的取捨,有些嚴格遵守這個模型,有些是「用起來像」。這裡稍微整理一下。
| 抽象 Array | C array | JavaScript Array |
|
|---|---|---|---|
| 元素型別 | 不限定 | 固定同一種 | 可以混放 |
| 大小 | 不限定 | 建立時決定,之後不變 | 可以長大 |
| 記憶體連續 | 假設連續 | 保證連續 | 不保證 |
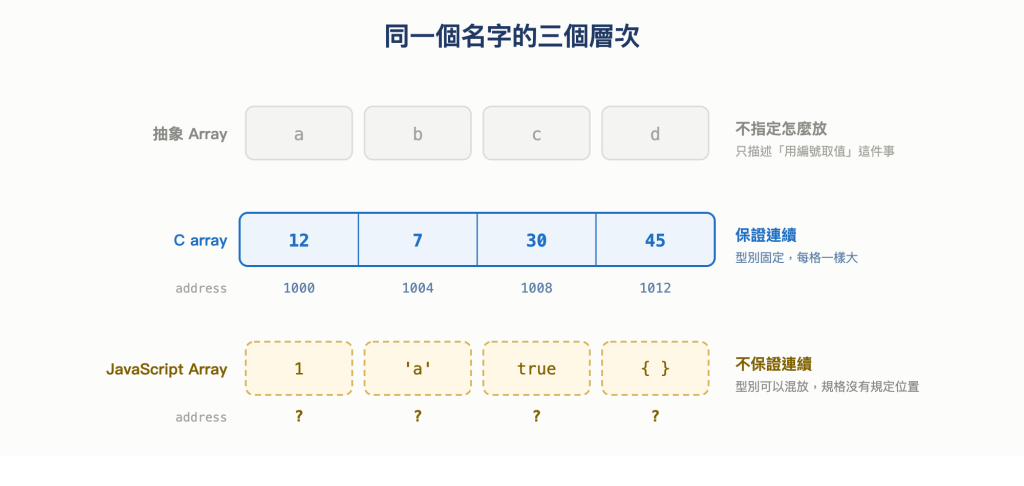
圖 10 同一個名字的三個層次:連續是 C array 的保證,不是 JavaScript 的
最需要注意的是最後一列。
前面我們都在強調 Array 的連續性質,但 JavaScript 的 Array 並不保證這件事。在規格層面,它比較接近一個「key 是數字字串的物件」,相鄰的 index 不必然對應到相鄰的實體位址。
不過引擎當然不會真的把陣列當成一般物件來處理,那樣太慢了。以 V8(Chrome 和 Node.js 都在用的 JavaScript 引擎)來說,它會盡量用接近真正陣列的方式來存放,而它判斷「這個陣列可以用多快的方式處理」的依據,叫做 elements kind。
因為想更多連結到日常應用,所以這裡是延伸小角落~剛好藉此機會更了解底層實作!
先給 V8 的 Elements Kinds 一句話解釋:
Elements kind 是 V8 替每一個陣列貼上的內部標記,用來記錄「這個陣列裡裝的是哪一類元素」,V8 會根據這個標記,決定要用多快的路徑來處理它。
這個標記主要沿著兩個方向來分類。
第一個方向是元素的型別,由窄到寬分成三級:
| 標記 | 裝的是什麼 |
|---|---|
SMI |
Small Integer,也就是小整數 |
DOUBLE |
浮點數,或是大到放不進 SMI 的整數 |
| (一般) | 其他任何值,例如字串、物件、null |
第二個方向是有沒有空洞:
PACKED:從 index 0 到最後一格,每一格都有值,中間沒有空的HOLEY:中間有洞,某些 index 沒有被賦值過兩個方向組合起來,就會得到像 PACKED_SMI_ELEMENTS、HOLEY_DOUBLE_ELEMENTS 這樣的標記。V8 目前總共區分了 21 種 elements kind。
而標記越「窄」(越靠近 PACKED_SMI),V8 能做的最佳化就越多,處理起來也越快。
elements kinds 有一個關鍵的性質:轉換是單向的,一旦掉下去就回不來了。
好奇的人可能想實際執行看看,只要在 Node.js 加上 --allow-natives-syntax 這個參數之後,就能呼叫 V8 的內部函式,其中 %HasHoleyElements、%HasSmiElements、%HasDoubleElements、%HasObjectElements 這幾個剛好可以把 elements kind 拼出來:
// 執行方式:node --allow-natives-syntax kind.js
function kind(a) {
  const hole = %HasHoleyElements(a) ? 'HOLEY' : 'PACKED';
  const type = %HasSmiElements(a)
    ? 'SMI_ELEMENTS'
    : %HasDoubleElements(a)
      ? 'DOUBLE_ELEMENTS'
      : %HasObjectElements(a)
        ? 'ELEMENTS'
        : '?';
  return `${hole}_${type}`;
}
有了這個工具函式,先來看型別方向:
const a = [1, 2, 3];
console.log(kind(a)); // PACKED_SMI_ELEMENTS  ← 最快的那一類

a.push(4.56); // 出現浮點數
console.log(kind(a)); // PACKED_DOUBLE_ELEMENTS

a.push('x'); // 出現字串
console.log(kind(a)); // PACKED_ELEMENTS

// 此時 a 是 [1, 2, 3, 4.56, 'x'],浮點數在 index 3、字串在 index 4
a[3] = 2;
a[4] = 3;
console.log(a); // [ 1, 2, 3, 2, 3 ]   ← 值全部變回整數了
console.log(kind(a)); // PACKED_ELEMENTS     ← 標記卻回不去
最後那幾行才是重點:陣列裡的值明明已經全部改回整數了,標記卻不會變回 PACKED_SMI_ELEMENTS,它會一直停在比較通用、也比較慢的那一級。
接著看空洞方向:
const b = [1, 2, 3];
console.log(kind(b)); // PACKED_SMI_ELEMENTS

b[9] = 1; // index 3~8 被跳過,中間留下六個洞
console.log(kind(b)); // HOLEY_SMI_ELEMENTS
還有一個很容易踩到的狀況,是用 new Array(n) 建立陣列:
const c = new Array(3);
console.log(kind(c)); // HOLEY_SMI_ELEMENTS

c[0] = 'a';
c[1] = 'b';
c[2] = 'c';
console.log(kind(c)); // HOLEY_ELEMENTS   ← 填滿了仍然是 HOLEY

const d = ['a', 'b', 'c'];
console.log(kind(d)); // PACKED_ELEMENTS  ← 字面值直接就是 PACKED
同樣是三個字串的陣列,c 和 d 的內容完全一樣,標記卻不同,而且 c 沒有機會再變回 PACKED。
補充:上面的輸出是實際跑出來的(由 Claude Code 執行並驗證)
完整的程式碼放在 gist 的
kind.js,用 Node.js 這樣執行:node --allow-natives-syntax kind.js
%開頭的那些函式是 V8 的內部介面、不是 JavaScript 語法,少了--allow-natives-syntax會直接噴SyntaxError。而這個參數是 V8 啟動時的旗標,沒辦法直接貼進瀏覽器的 console 執行。V8 官方那篇 Elements kinds 文章發表於 2017 年,距今有一段時間,所以這裡特地重跑確認過:上面每一行輸出都和文章描述一致,機制到現在仍然是這樣運作的。
因為讀到洞的時候,事情沒有想像中單純。
當 V8 讀取一個 PACKED 陣列的某個 index,只要位置在範圍內,那裡就一定有值,直接拿走就好。但如果陣列是 HOLEY,讀到某個 index 卻發現是洞的時候,V8 不能直接回答 undefined,它必須沿著原型鏈(prototype chain)往上找,確認 Array.prototype 或 Object.prototype 上面有沒有剛好定義了這個 index。
確認的動作本身就是額外成本,且它會讓很多原本可以套用的最佳化沒辦法生效。
V8 官方那篇文章給了幾個建議,其中比較常遇到的是下面這些。
new Array(n):new Array(3) 一建立就是 HOLEY,逐格填滿也回不去。如果一開始還不知道要放什麼,用空陣列加 push 也能維持 PACKED。(item = items[i]) != null 這種靠讀到 undefined 才停下來的迴圈條件,會讀到界線外,一樣觸發原型鏈查找。改用 i < items.length 或 for...of 就好。delete arr[i] 或跳號賦值(例如 arr[100] = x)都會讓陣列變成 HOLEY,而且回不來。要移除元素的話,用 splice 或建立一個新陣列會比較好。NaN、Infinity 和 -0 也會讓 SMI 掉到 DOUBLE。更多詳細敘述可參考文末 Reference 的原文。
看完 elements kinds,可能有人會冒出一個疑問:既然 JavaScript 的 Array 連「連續」都不保證,那前面花那麼多篇幅講的 base + index × elementSize,對 JavaScript 來說還算數嗎?
算數,只是要換一個方式來理解它。
那條算式描述的是 Array 這個結構的設計意圖,而各家引擎都在盡力逼近它,因為只有逼近它,arr[i] 才可能快。所以前面那張成本表在實務上仍然成立:push 就是比 unshift 快,這件事不會因為換了一個引擎就翻轉。
受影響的是更細的那一層,同樣被歸成 O(1),實際跑多快還是要看這個陣列有沒有被引擎放進比較快的那一類,也就是剛剛講的 elements kind。所以 elements kinds 影響的是 Day 02 提過的那個「被 Big O 藏起來的常數」,而不是複雜度,arr[i] 不管是 PACKED 還是 HOLEY 都仍然是 O(1)。
Int32Array?cache 那一段的實測,JavaScript 版用的是 Int32Array,而不是我們平常在寫的 Array,這是為什麼呢?
先說 Int32Array 是什麼,它屬於 TypedArray(型別化陣列),是 JavaScript 為了處理大量數值資料而提供的一組結構,同一家族還有 Float64Array、Uint8Array 等等。它和一般 Array 的差別如下表:
一般 Array |
Int32Array(TypedArray) |
|
|---|---|---|
| 元素型別 | 可以混放任何值 | 固定,只放 32 位元整數 |
| 每格大小 | 不固定 | 固定,每格就是 4 bytes |
| 記憶體連續 | 不保證 | 保證,背後就是一整塊連續的記憶體 |
| 長度 | 可以變動 | 建立時決定,之後不變 |
看到這幾列應該會有點眼熟,它們正好就是這篇文章從頭到尾在描述的那個模型:型別一致、每格一樣大、整段連續、大小固定。換句話說,TypedArray 是 JavaScript 裡比較接近 C array 的東西,也是能對應前面那條 base + index × elementSize 的選項。
而那份實測想量的是「連續存取 vs 跳著存取」這一件事,若改用一般 Array,量到的數字裡就會混進 elements kinds 掉級、數值裝箱、引擎最佳化有沒有生效等等一堆變因,最後分不出哪一部分是走訪順序造成的。用 Int32Array 才能把其他變因壓掉,只留下我們真正想觀察的那一個。
小小總結一下今天對 Array 的認識~
最後補充幾點~
indexOf、includes 這類方法,心裡要浮現 O(N)。push 平常是 O(1),但空間滿了的那一次要整批搬到新的地方,那一次是 O(N)。圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術