
Day 3 我給自己立了一個判準:從一張圖上的異常點出發,要幾次點擊才能看到造成它的那筆 log?如果答案是「開三個瀏覽器分頁」,那我有的是三個孤島,不是三大支柱。
今天回答這個問題,順便破第二個案。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=false LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=true
kubectl port-forward -n monitoring svc/kps-grafana 3000:80
Day 17 停在一個缺口:我看著 P99 的圖,看到一個 1 秒的點,但那個點是聚合值,它不記得自己是哪些請求算出來的。
exemplar 就是補這個缺口的東西。概念很簡單:程式在把一筆請求的耗時丟進 histogram 的時候,順手夾一個這筆請求的 trace_id。Prometheus 抓指標時把它一起收下,於是每個桶旁邊都留著一筆「代表性請求」的編號。那筆請求就叫 exemplar(範例點)。
Grafana 畫圖時會把它們畫成線旁邊的小點,點下去直接跳到那條 trace。工作流程從「看到異常、猜可能是什麼、去別的系統找證據」變成「看到異常、點它、看到證據」。
這是今天最容易卡的地方,因為程式、Prometheus、Grafana 三邊各要改一處,漏掉任何一邊的結果都一樣:圖上就是沒有小點,沒有錯誤訊息。
一、程式要用 OpenMetrics 格式,而且要真的夾 trace_id。 exemplar 沒辦法用 Prometheus 傳統的文字格式傳,要用它的後繼者 OpenMetrics。common.py 改兩處,先換輸出格式:
from prometheus_client import REGISTRY, Counter, Histogram
from prometheus_client.openmetrics.exposition import CONTENT_TYPE_LATEST, generate_latest

@app.get("/metrics")
def metrics():
    return Response(generate_latest(REGISTRY), media_type=CONTENT_TYPE_LATEST)
這裡有一個小坑:OpenMetrics 版的 generate_latest 沒有預設的 registry,忘了傳 REGISTRY 進去,/metrics 會直接 500。我第一次就是這樣。
然後在中介層記耗時的那行夾上 trace_id:
ctx = trace.get_current_span().get_span_context()
exemplar = {"trace_id": format(ctx.trace_id, "032x")} if ctx.is_valid else None
request_duration.labels(SERVICE, path).observe(elapsed, exemplar=exemplar)
改完 /metrics 的 histogram 桶長這樣,# 後面就是 exemplar:
http_request_duration_seconds_bucket{le="0.1",path="/prices",service="pricing"} 1.0 # {trace_id="8937de20b8dcca5da44f29c91858eb90"} 0.0009 1789404529.02
image 升到 0.3,重 build、kind load、apply,跟昨天一樣。
二、Prometheus 要開功能旗標。 exemplar 儲存在 Prometheus 3.14 還是實驗功能,要用 --enable-feature=exemplar-storage 打開。Day 8 裝的 kube-prometheus-stack 沒帶任何 values,所以補一個檔案,放在 repo 的 helm/kube-prometheus-stack-values.yaml:
prometheus:
  prometheusSpec:
    enableFeatures:
      - exemplar-storage
三、Grafana 要知道 trace_id 該往哪裡跳。 這件事正常是在 Prometheus 資料源的設定頁做,但 Day 8 那個資料源是 chart 用 ConfigMap 自動建的,Grafana 標成唯讀,設定頁改不了。要走 values 檔:
grafana:
  sidecar:
    datasources:
      exemplarTraceIdDestinations:
        datasourceUid: tempo
        traceIdLabelName: trace_id
datasourceUid: tempo 這行有一個前提:Tempo 資料源的 uid 要真的叫 tempo。Day 18 用 UI 加的那個 uid 是隨機的,所以我把 Loki 和 Tempo 兩個資料源也一起搬進 values 檔宣告(grafana.additionalDataSources,完整內容在 repo),uid 固定叫 loki 和 tempo。
然後 helm upgrade:
helm upgrade kps prometheus-community/kube-prometheus-stack -n monitoring --version 90.0.0 \
  -f helm/kube-prometheus-stack-values.yaml
upgrade 跑完,Grafana 的 Pod 重啟,我重新登入——Day 9 的儀表板、Day 11 的九宮格、Day 12 的節點 USE、Day 15 加的 Loki、Day 18 加的 Tempo,全部不見了。
原因是 kube-prometheus-stack 的 Grafana 預設沒有持久化。它把儀表板和資料源存在 Pod 裡的一個 SQLite 檔,Pod 一換,檔案跟著沒了。Grafana 從 Day 8 起連續跑了七天沒重啟,所以我一直沒發現這件事;今天 upgrade 改了它的 ConfigMap,Pod 重建,十天的手工全部歸零。
Prometheus 也一樣。 它的資料目錄預設是 emptyDir,重啟後 Day 8 到今天的指標歷史也沒了。延遲圖上的線從 upgrade 那一刻才開始。
補救方式是同一個 values 檔再加兩段,兩邊都掛 PVC:
prometheus:
  prometheusSpec:
    storageSpec:
      volumeClaimTemplate:
        spec:
          resources:
            requests:
              storage: 5Gi

grafana:
  persistence:
    enabled: true
    size: 2Gi
掉的東西救不回來。資料源已經改成宣告的,不會再掉;儀表板我把 Day 9 那張照文章裡的設定重建成 JSON,用 ConfigMap 掛進去(在 repo 的 grafana/),chart 的 sidecar 會自動載入,之後重啟也不會掉。這才是儀表板該有的存法——後面講 IaC 的時候會回來講。
再 upgrade 一次之後,還遇到一個。
儀表板回來了,但兩個面板都是紅色三角形、No data。去看 Grafana 的 log:
Plugin registered  pluginId=prometheus
Installing plugins [mysql, loki, prometheus, tempo, ...]
plugin process exited  plugin=.../plugins-bundled/prometheus/...
Failed to install plugin  pluginId=prometheus
  error="unlinkat /usr/share/grafana/data/plugins-bundled/prometheus: read-only file system"
Grafana 13 把 Prometheus、Loki、Tempo 這些資料源做成「預裝 plugin」,啟動後會在背景嘗試從網路更新它們。更新的做法是先停掉正在跑的、刪掉舊目錄、再寫新的——但 chart 給容器的是唯讀根檔案系統,刪不掉,於是舊的已經停了、新的裝不上,plugin 就消失了。Prometheus 資料源還在列表裡,但背後沒有東西在服務它。
之前七天沒事,很可能是那段時間 plugin 沒有新版,安裝器沒動作;今天剛好有。修法是關掉背景預裝,用 image 裡內建的版本:
grafana:
  grafana.ini:
    plugins:
      preinstall_disabled: true
這一段也在同一個 values 檔裡。
我是分三次 upgrade 把上面這些踩出來的。repo 裡的 helm/kube-prometheus-stack-values.yaml 已經是最後的版本,五件事都在裡面:exemplar、Prometheus 持久化、Grafana 持久化、資料源宣告、關掉 plugin 背景更新。你跑一次就好。
但有一件事要在 upgrade 之前做:把你手工做的儀表板匯出。 持久化是 upgrade 之後才生效的,這次重啟你 Day 9、11、12 做的儀表板一樣會掉。到每張儀表板右上角 Share → Export → Export as JSON,存下來。之後想放回去,照 repo 裡 grafana/dashboard-checkout-sli.yaml 的樣子包成 ConfigMap 再 apply,就會自動載入而且不會再掉。Day 15 和 Day 18 用 UI 加的 Loki、Tempo 資料源不用管,values 檔會用宣告的版本補回來。
匯出完再跑:
helm upgrade kps prometheus-community/kube-prometheus-stack -n monitoring --version 90.0.0 \
  -f helm/kube-prometheus-stack-values.yaml
kubectl rollout status deploy/kps-grafana -n monitoring
kubectl apply -f grafana/          # Day 9 的儀表板,我已經改成 ConfigMap 了
port-forward 要重開,Grafana 也要重新登入。進去之後 Dashboards 裡會有「結帳服務 SLI」,Connections → Data sources 裡會有 loki 和 tempo,都是灰的唯讀。
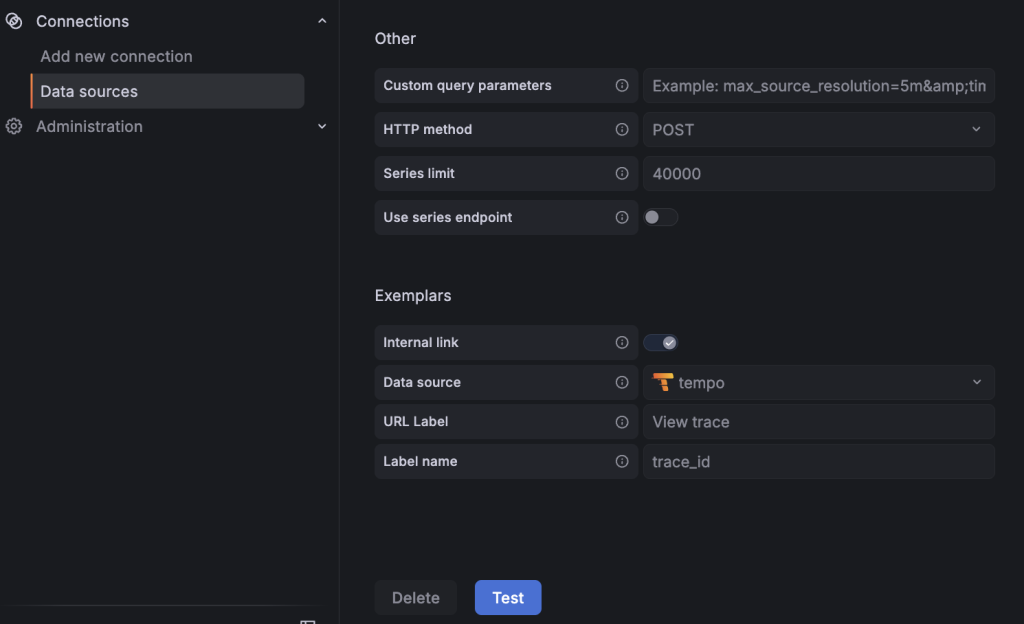
Prometheus 資料源的設定頁最下面,Exemplars 區塊四個欄位都填好了:Internal link 開著、Data source 是 tempo、Label name 是 trace_id。
三邊都改完,打開延遲圖,線的旁邊應該多出小點。沒有的話,三邊回頭一個一個查:程式那邊 curl 一下 /metrics 看 Content-Type 是不是 openmetrics、桶旁邊有沒有 # {trace_id=...};Prometheus 那邊查 /api/v1/status/flags 看 enable-feature 有沒有 exemplar-storage;Grafana 那邊看資料源設定頁的 Exemplars 區塊。
Day 9 的延遲面板,P50 / P95 / P99 三條線:
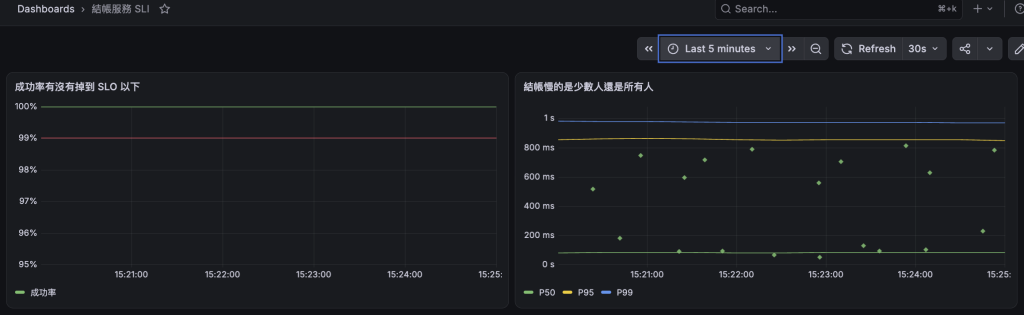
長尾。P50 貼著 80 毫秒不動,P95 在 800 毫秒、P99 在 1 秒,跟 Day 10 看到的一樣。但這次線旁邊多了綠色的小菱形——每一個都是一筆真實請求的耗時,散在 100 毫秒到 900 毫秒之間。
滑鼠移到最上面那個小點上:
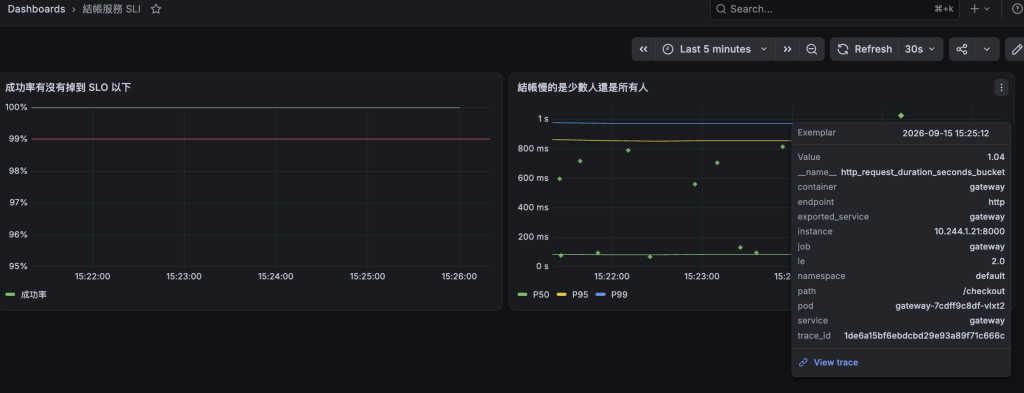
Value 1.04,也就是這筆請求花了 1.04 秒;le=2.0 是它掉進的桶——Day 13 說過桶要圍繞門檻設,1 秒和 2 秒之間沒有刻度,所以它只能記在 2.0 那格。最下面是 trace_id 和一個 View trace 的按鈕。按下去,Tempo 打開了那條 trace,trace_id 跟剛才小視窗裡的一樣:
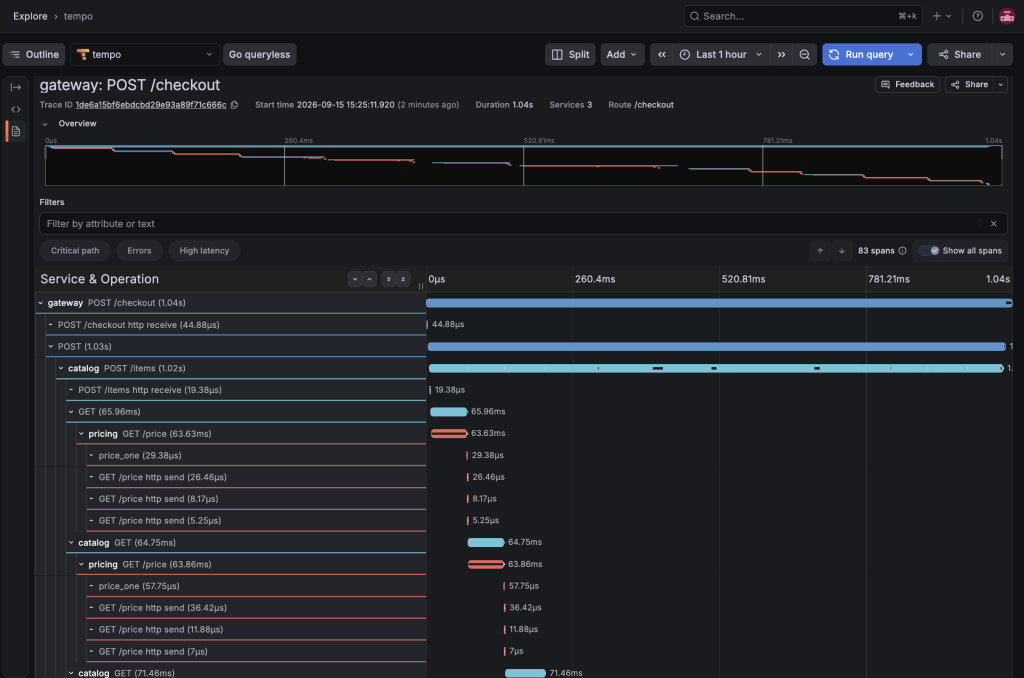
1.04 秒、83 個 span、三個服務。上面 Overview 那條縮圖是樓梯狀的,往下看 catalog 的 POST /items 佔了 1.02 秒,它底下是一排 catalog GET → pricing GET /price,每一組 64 毫秒左右,一個接一個排成一排,前一個結束下一個才開始。
每一次呼叫只花 60 幾毫秒,單獨看完全正常——這就是為什麼 metrics 查不出來,pricing 自己的延遲指標一切健康。問題不在單次呼叫慢,在於呼叫了十幾次,而且是串著打。
這張圖就是 Day 17 那張 ASCII 的真實版。
昨天在 catalog 加的那個屬性派上用場了。點開 catalog 的 span,看它的屬性:
cart.item_count = 12
pricing.mode    = n_plus_one
再找一條正常的 trace 對照,cart.item_count = 3、pricing.mode = batch,pricing 只有一個 span,總耗時 80 幾毫秒。規律出現了:pricing 的呼叫次數等於購物車商品數,而且只在超過 5 件時發生。
用 TraceQL 撈出所有大購物車的慢請求,門檻用 Day 2 定的 SLO 300 毫秒:
{ span.cart.item_count > 5 && duration > 300ms }
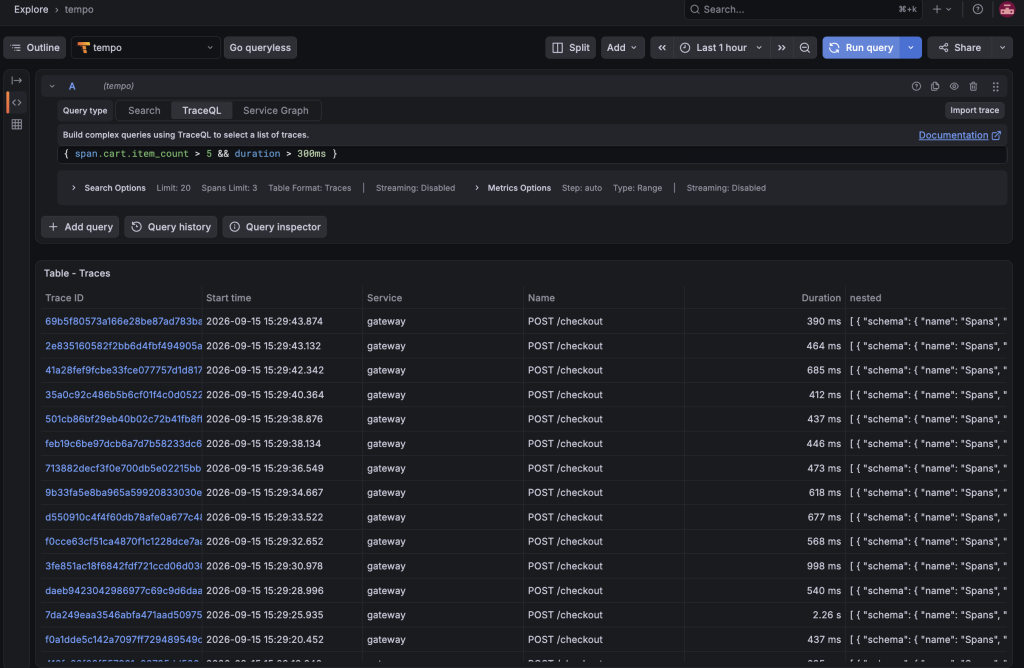
一整排,390 毫秒到 2 秒都有。再反過來查小購物車有沒有慢的:
{ span.cart.item_count <= 5 && duration > 300ms }
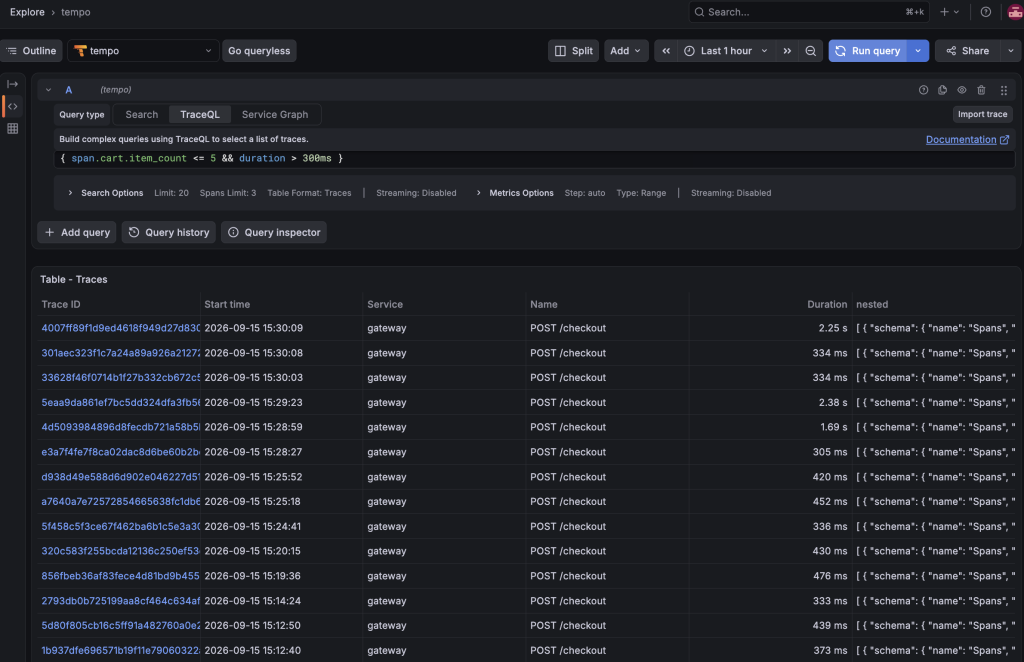
我原本以為這條會是空的,結果有東西,而且不只一兩筆。先別急著推翻假設,把數量算出來——過去 30 分鐘:
| 總數 | > 300ms | 比例 | |
|---|---|---|---|
| 大購物車(> 5) | 1,225 | 1,000 以上 | 82% 以上 |
| 小購物車(≤ 5) | 4,792 | 15 | 0.3% |
82% 對 0.3%,假設成立。這就是 N+1:程式為了拿 N 件商品的價格,發了 N 次請求,而不是一次。
那 0.3% 是什麼?點進去看,形狀完全不一樣。N+1 的慢是 catalog 底下一排 pricing 串著打;這 15 筆的慢是空白——gateway 裡空了 100 毫秒、catalog 收到請求之後空了 900 毫秒才呼叫 pricing、pricing 收到之後又空了 1 秒才開始算。三個服務一起停,那是整台機器卡了一下,筆電上跑 kind 偶爾會這樣,跟購物車大小無關。
這是火焰圖比數字多給的東西:兩種慢,metrics 上都是「超過 300 毫秒」,trace 上一個是階梯、一個是空白。
在 trace 畫面點任何一個 span,它會往下展開細節,右上角有一個 Logs for this trace 的按鈕。原理就是昨天填進 log 的那個 trace_id 欄位。
這個按鈕要先告訴它 log 在哪、怎麼查,設定叫 Trace to logs。我把它寫在同一個 values 檔裡,跟 Tempo 資料源一起宣告:
jsonData:
  tracesToLogsV2:
    datasourceUid: loki
    filterByTraceID: true
    tags:
      - key: service.name      # span 上的服務名
        value: app             # 對到 Loki 的哪個標籤
tags 那組對應是關鍵:span 上服務名的欄位叫 service.name,Loki 的標籤叫 app,不對應的話 Grafana 會拿 service.name 去查 Loki,查不到東西也不會報錯。
點 catalog 的 span,按 Logs for this trace:
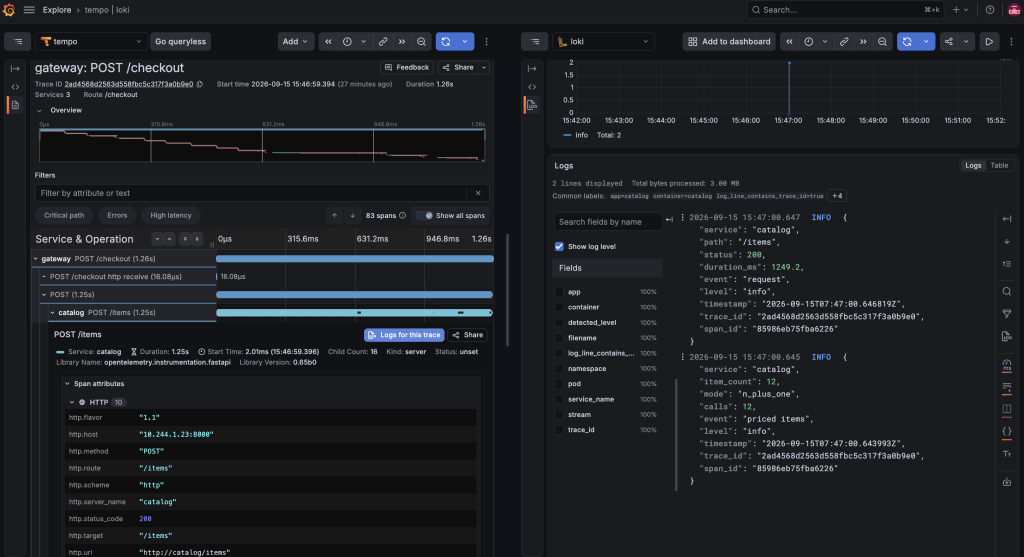
Grafana 幫你組了一條 LogQL——{app="catalog"} |= "那個 trace_id"——右邊直接是這筆請求在 catalog 印的兩行 log,trace_id 跟左邊一模一樣。
左邊 span 的 Child Count 是 16、Duration 1.25 秒;右邊 log 寫著 item_count: 12、mode: n_plus_one、calls: 12。trace 說「這一段底下有很多小孩」,log 說「因為我打了 12 次」——兩邊講的是同一件事,只是一個用結構、一個用文字。
整條路通了。
從一張圖上的異常點,到造成它的那筆 log:
| 步驟 | 動作 |
|---|---|
| 1 | 在延遲圖上點一個 exemplar 小點 |
| 2 | 按 View trace 看火焰圖 |
| 3 | 按 Logs for this trace 看 log |
三次點擊,全程沒離開 Grafana,沒有手動輸入過任何一次時間範圍或 ID。 Day 3 的答案是「開三個瀏覽器分頁」,今天是三次點擊。
而且這條路是雙向的:在 Loki 看到一行可疑的 log,它的 trace_id 欄位旁邊也會有一個按鈕跳去 Tempo。
cart.item_count 驗證條件Day 7 那句「只有單點,無法跨服務關聯」,正式劃掉。四句天花板現在只剩最後一句:只能被動查,不會主動通知。
明天開始告警區塊,處理最後一句天花板。Day 6 的第三個故障——那個記憶體洩漏——還在那裡慢慢長大。


 iThome鐵人賽
 看影片追技術