
上一篇我們實際使用 Python 對圖片進行讀取、縮放與裁切,但圖片調整好大小之後,就可以直接丟進模型了嗎?
我們前面提過,一張彩色圖片中的每個 Pixel,都是由 RGB 三個數值組成,例如:[214, 153, 152],這些數值對我們來說只是顏色,但對模型來說,它們就是接下來要進行計算的資料
因此在正式把圖片交給模型之前,通常還會先經過 Image Preprocessing(影像前處理),讓圖片資料更適合模型進行學習
Image Preprocessing 中文通常稱為「影像前處理」,簡單來說就是在圖片正式進入模型之前,先將圖片整理成適合模型處理的形式
就像我們在煮飯前,會先把食材清洗、切成適合的大小一樣,圖片在交給模型之前,也需要先整理成模型比較適合處理的形式
例如,每張圖片原本的尺寸可能不同,Pixel 的數值範圍也可能需要調整,因此我們會透過縮放、數值轉換、正規化等方式進行處理
影像前處理的目的並不是讓圖片「看起來更漂亮」,而是讓不同圖片的資料形式更加一致,並轉換成適合模型計算與學習的形式
而上一篇介紹的 Resize(縮放),其實就是 Image Preprocessing 中很常見的一個步驟
我們先把圖片轉換成 NumPy 可以操作的數值陣列(Array) ,使用 PIL 讀進來的圖片:
from PIL import Image
img = Image.open(image_path)
透過 NumPy:
import numpy as np img_array = np.array(img)
print(img_array.shape)
print(img_array[0, 0])
得到
(450, 600, 3)
[214 153 152]
目前圖片中的 RGB 數值通常介於 0 ~ 255,在訓練神經網路時,常見的做法之一是將這些數值縮放到 0 ~ 1
這個過程就是 Normalization(正規化) 的一種常見形式,做法非常簡單:
normalized_img = img_array / 255.0
可以實際看看: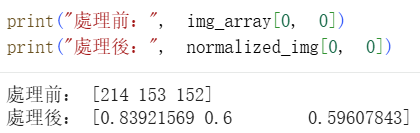
這時候就可以看到,同一個 Pixel 的數值從原本的 0~255,被縮放到了 0~1
0~255 變成 0~1?看到這裡可能會有一個疑問:
模型明明也可以計算 214、153、152,為什麼還要特別除以 255?
原因和神經網路的訓練方式有關,模型在訓練過程中會不斷進行大量的數學運算,並根據計算結果調整自己的參數
如果輸入數值的尺度較大,可能使訓練過程中的數值計算較不穩定;將輸入縮放到較小且一致的範圍,通常能讓模型的訓練更穩定,也更容易進行最佳化
要注意的是,Normalization 並不是把圖片變得更清楚,也不是增加圖片資訊,它做的事情其實就是調整圖片的數值尺度,讓這些數值更適合後續的模型運算
另外,÷ 255 也不是所有模型唯一的做法,之後學到 Transfer Learning 時會看到,有些預訓練模型會要求使用自己的 Preprocessing 方法
我們可以把處理前後的圖片顯示出來:
import matplotlib.pyplot as plt
plt.figure(figsize=(10, 4))
plt.subplot(1, 2, 1)
plt.imshow(img_array)
plt.title("Before Normalization")
plt.axis("off")
plt.subplot(1, 2, 2)
plt.imshow(normalized_img)
plt.title("After Normalization")
plt.axis("off")
plt.show()
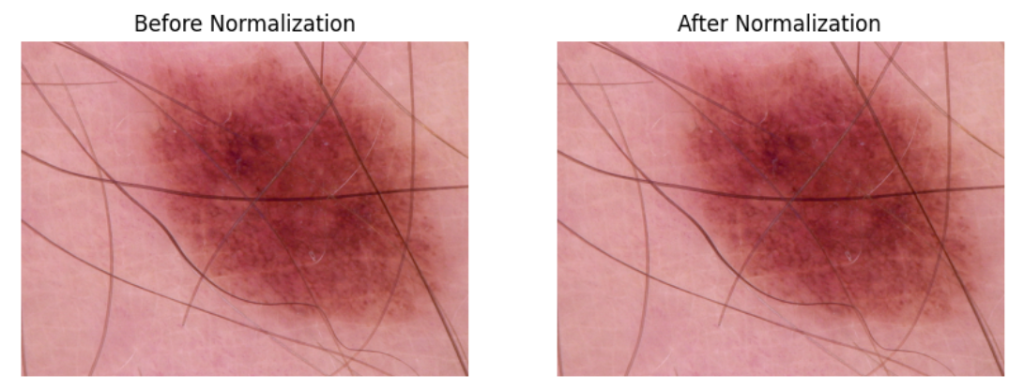
我們可以發現兩張圖片看起來幾乎一樣,這是因為 Normalization 並沒有改變 RGB 彼此之間的比例關係
RGB三個數值都使用相同的比例縮小,所以它們所代表的顏色關係仍然存在,也就是說人眼看到的圖片沒有明顯改變,但電腦拿來計算的數值範圍已經不同了
今天認識了 Image Preprocessing(影像前處理)
圖片在送進模型之前,通常需要先整理成一致且適合計算的形式,我們也實際把圖片轉換成 NumPy Array,並透過 Normalization 將 Pixel 數值從 0~255 縮放到 0~1
前幾天我們一直都只拿一張圖片來練習,但真正訓練 AI 時,當然不可能只靠一張圖片
下一篇我們就要正式打開 HAM10000,看看這個資料集到底有哪些皮膚病灶類別,以及每一類到底有多少張圖片


 iThome鐵人賽
 看影片追技術