
前幾天我們都是從 HAM10000 中拿出其中一張圖片,練習 Pixel、RGB、Resize 和 Image Preprocessing,但如果接下來真的要拿 HAM10000 訓練模型,只看一張圖片當然不夠
在開始訓練之前,我們至少要先知道這個 Dataset 裡到底有什麼?有幾張圖片?分成哪些類別?每個類別的圖片數量一樣嗎?
所以今天先不急著建立模型,而是正式來認識接下來會一路使用的 HAM10000 Dataset
HAM10000 的全名是 Human Against Machine with 10000 training images,是一個皮膚病灶影像資料集,資料集中包含 10,015 張皮膚鏡(dermatoscopic)影像,並將病灶分成 7 個類別
我們這次使用的是 Kaggle 上整理好的 HAM10000:
import kagglehub

path = kagglehub.dataset_download(
    "kmader/skin-cancer-mnist-ham10000"
)
print(path)
下載完成後,除了前幾天使用的圖片資料夾之外,還會看到HAM10000_metadata.csv ,這個 CSV 就像是這 10,015 張圖片的資料表
在開始建立模型之前,我們要先知道自己手上的資料有哪些欄位、資料是否完整,以及資料的分布情況,我們可以使用print(df.info()),看看資料表的欄位,因為如果連自己的 Dataset 長什麼樣子都不知道,就直接開始訓練模型,即使最後得到一個很高的 Accuracy,也很難知道這個結果到底可不可信
使用 Pandas 讀取:
import pandas as pd
import os

metadata_path = os.path.join(path, "HAM10000_metadata.csv")
df = pd.read_csv(metadata_path)

df.head()
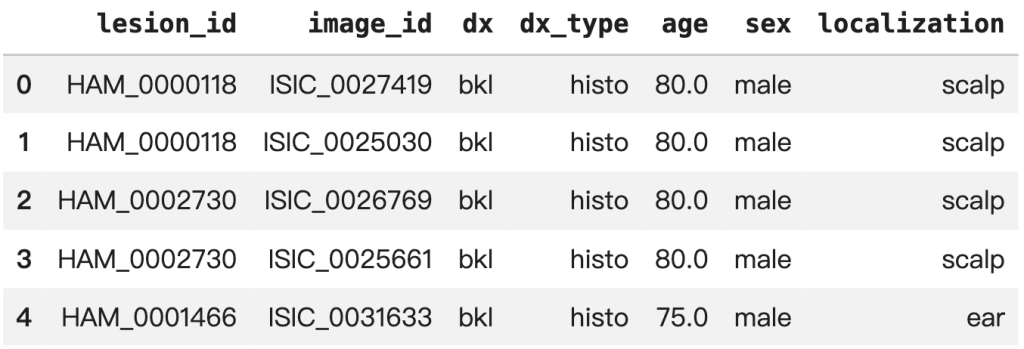
接著可以看看 dx 到底有哪些不同的值:
print(df["dx"].unique())
得到['bkl' 'nv' 'df' 'mel' 'vasc' 'bcc' 'akiec']
因此可以確認有7種病灶類別
知道有 7 類之後,下一個需要知道的是每一類別的圖片數量有多多?
可以直接使用:
class_counts = df["dx"].value_counts()
print(class_counts)
再將數據轉為視覺化的圖表
import matplotlib.pyplot as plt
class_counts.plot(kind="bar")
plt.title("HAM10000 Class Distribution")
plt.xlabel("Class")
plt.ylabel("Number of Images")
plt.xticks(rotation=45)
plt.show()
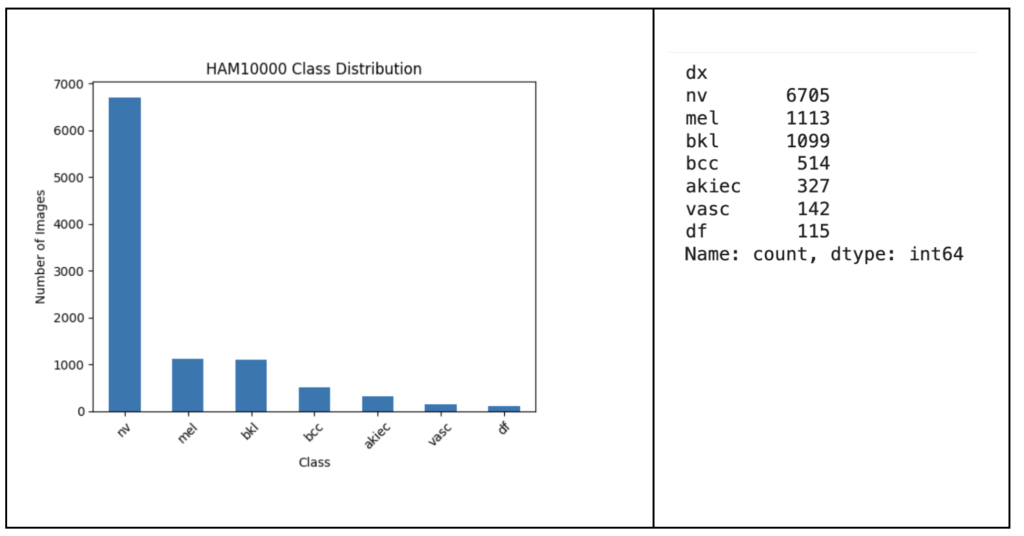
畫出來之後,我們很快發現每個類別的圖片數量差非常多,其中 nv 的圖片數量特別多,而有些類別的圖片則少很多,這種現象稱為**「Class Imbalance(類別不平衡)」**
假設我們今天要教模型分辨「貓」和「狗」,但準備的資料是:
貓:9,500 張、狗:500 張
模型在訓練過程中會看到非常多貓,卻很少看到狗,這時候即使模型很常猜「貓」,整體 Accuracy 看起來可能還是不錯,但這不一定代表模型真的學得很好
HAM10000 也有類似的問題,如果某一個病灶類別的圖片非常多,而其他類別非常少,那麼只看整體正確率,就可能讓我們對模型產生錯誤的判斷,所以在開始訓練之前,我們要先知道「我的資料本身是不是平衡的?」,那麼如果不平衡的話要怎麼辦呢,我們下一篇來討論Class Imbalance


 iThome鐵人賽
 看影片追技術