

上一篇最後留了一個問題:模型給出一個答案,不代表下一段程式就能安全使用。當 AI 真正被放進一條程式 pipeline 裡,我開始覺得 input / output 也應該用一般軟體工程的方式看待:上一段的 output,必須能被下一段當成 input 精確地接住。
這和「人看不看得懂」是兩回事。人可以理解「這看起來是一個品牌,我滿有信心的」,但下一段程式需要知道的是:哪個欄位代表判斷結果、型別是 boolean 還是 string、信心程度有哪些允許值,以及欄位不存在時該怎麼處理。
Structured Outputs 想解決的,就是這個交界處的問題:讓模型保留語意判斷的能力,但要求交給程式的結果遵守一份明確、可驗證的輸出契約。 這份輸出契約,就是這篇所說的資料契約。
前面有談過這個專案想要設計一個收錄台灣中小品牌的平台。當資料一進來時,第一個很實際的問題其實更前面:目前這個網站代表的,到底是不是一個有自己產品的品牌? 至於它是不是台灣品牌、最後是否符合收錄條件,留給後面的流程再判斷。
這個問題沒有想像中簡單。選物店可能只是在販售別人的商品,也可能同時有自己的產品線;插畫家可能只是創作者,也可能真的把角色做成自己設計、生產的實體商品;有時候搜尋結果又少到根本無法確定是不是同一個對象。
我現在實際使用的 prompt,會刻意把這些判斷邊界寫清楚。例如:
「是不是品牌」和「是不是符合我們最後的收錄條件」也是兩個不同問題;把它們拆開,比較容易測試,也比較容易知道模型到底是哪一個判斷出了錯。
因此,模型在這一步不只是要回答 yes / no,而是要把判斷整理成下一段程式可以使用的資料。如果先省略 reasoning 等其他欄位,簡化後的結果會像:
{
  "isNonBrand": false,
  "nonBrandReason": null,
  "brand_name": "品牌ABCD",
  "confidence": "medium"
}
後續程式就能直接用 isNonBrand 決定是否繼續,用 confidence 決定這個判斷能不能直接採用。
如果沒有進一步限制,LLM 不只會決定「答案是什麼」也會自行決定「答案長什麼樣」。假設 prompt 只寫一句「請用 JSON 回覆」,模型可能產生下面幾種結果:
版本一:改掉欄位名稱和型別
{
  "is_brand": "yes",
  "name": "島嶼紙品",
  "confidence": 0.92
}
版本二:自己重新設計巢狀結構
{
  "decision": {
    "type": "brand",
    "confidence": "medium"
  },
  "brand": {
    "name": "島嶼紙品"
  }
}
版本三:改成另一套分類方式
{
  "result": [
    {
      "label": "VALID_BRAND",
      "score": 92,
      "reason": "有自有產品線"
    }
  ]
}
這三段都是合法 JSON,人也都能理解模型想表達什麼,但對原本預期 isNonBrand: boolean、brand_name: string、confidence: high | medium | low 的程式來說,它們是三套完全不同的資料介面。
如果這份結果會決定流程是否繼續,問題就不只是解析比較麻煩而已:下一段程式可能讀不到欄位、走到錯誤分支,或必須塞進越來越多相容性邏輯去猜模型這次用了哪一種格式,因此只要模型的輸出還要交給程式繼續處理,我們需要學會用 Structured Outputs 固定資料格式:模型可以保留內容判斷的彈性,但不能自行改變欄位名稱、型別或資料結構。
我會把模型輸出的失敗分成三層:
從 OpenAI 的 Structured Outputs 指南 可以整理出幾個很實用的原則:不要只要求模型「輸出 JSON」,而是直接用 JSON Schema 定義資料格式;欄位名稱要清楚、型別要明確,像 confidence 這種只有固定幾種可能值的欄位,就適合用 enum 限制。OpenAI 的 strict schema 也要求預期欄位都要存在,因此「可能沒有值」的欄位,可以明確允許 null,而不是讓同一個 key 有時出現、有時消失。
Anthropic 的 Structured Outputs 文件 處理的其實也是同一類問題:如果沒有 schema 約束,模型可能產生無法解析的 JSON、漏掉必要欄位、使用錯誤型別,或回傳不符合預期結構的資料。Structured Outputs 會透過 constrained decoding,也就是在生成過程中限制模型可選擇的輸出,讓最後結果符合指定的 schema。
兩家的做法指向同一件事:不要只靠 prompt 要求模型「記得照格式回答」,而是把輸出規格直接放進 API 呼叫裡,讓格式本身成為系統的一部分。
Structured Outputs 主要處理前兩層,第三種「語意錯誤」不會因為 schema 存在就消失:一份格式完全正確的結果,還是可能把商店判成品牌,或非常有信心地選錯分類。這部分後面談 Eval 時再處理;Structured Outputs 先把「下一段程式能不能穩定接住這份資料」這件事處理好。
Structured Outputs 本身不綁定某一個實作工具。最直接的方式是手寫 JSON Schema,也可以用不同語言的 schema 工具來產生。
這條資料流程使用 TypeScript,所以我選擇 Zod:一個 TypeScript-first 的 schema validation library。它可以用程式碼定義 object、string、boolean、enum、nullable 等資料型別,也可以在程式執行時驗證外部資料是不是真的符合定義。OpenAI 的 JavaScript SDK 直接示範用 z.object 搭配 Zod helper 定義 Structured Outputs;Anthropic 的 TypeScript SDK 也提供 zodOutputFormat();Gemini 的 JavaScript structured output 文件同樣支援 Zod。
以剛才「是不是品牌」的實際 schema 為例,邏輯大致如下:
const confidenceShape = z.enum(["high", "medium", "low"]);

const detectShape = z.object({
  reasoning: z.string(),
  isNonBrand: z.boolean(),
  nonBrandReason: z.string().nullable(),
  brand_name: z.string().nullable(),
  confidence: confidenceShape,
});
這裡我們清楚地定義 nonBrandReason 和 brand_name 為 nullable,也就是要求模型在沒有值時明確回傳 null,而不是直接省略欄位。這樣下一階段就不需要猜「欄位是遺失了,還是真的沒有值」。這和 OpenAI strict Structured Outputs 要求預期欄位都存在的設計剛好一致,也比「有時有這個 key、有時沒有」更容易處理。
這裡真正重要的,是讓模型的 output 和下一段程式的 input 受到同一份介面契約約束。因此目前做法是把 Zod 當成這份契約的唯一定義來源:送出請求時,由它產生模型端需要的 JSON Schema;模型回傳後,再用同一份 Zod schema 驗證資料。這樣資料怎麼產生、又怎麼被下一段程式接收,都依賴同一套定義:
schema: toStrictJsonSchema(detectShape)
模型回來之後,應用程式端再驗證一次:
const result = detectShape.safeParse(parsed);

if (!result.success) {
  // 記錄欄位層級的驗證錯誤
}
這樣同一份 schema 同時服務兩端:送給模型時限制輸出格式,回到程式後再確認資料符合約定,也避免模型端和程式端各自維護一套規格,時間久了逐漸不一致。
當然 schema 也不是所有驗證的終點。「名稱必須真的來自候選集合」、「URL 必須屬於允許來源」這些應用規則,仍然要由 deterministic code 負責。Structured Outputs 解決的是資料形狀,不是把所有商業邏輯都塞進 schema 中。
Structured Outputs 決定的是模型產生的資料要怎麼交給下一個階段,只要某一步的模型輸出還要被後續程式使用,就需要穩定的輸出契約,因此回頭看整條資料流程我們可以發現每一個步驟都會因此而受益。
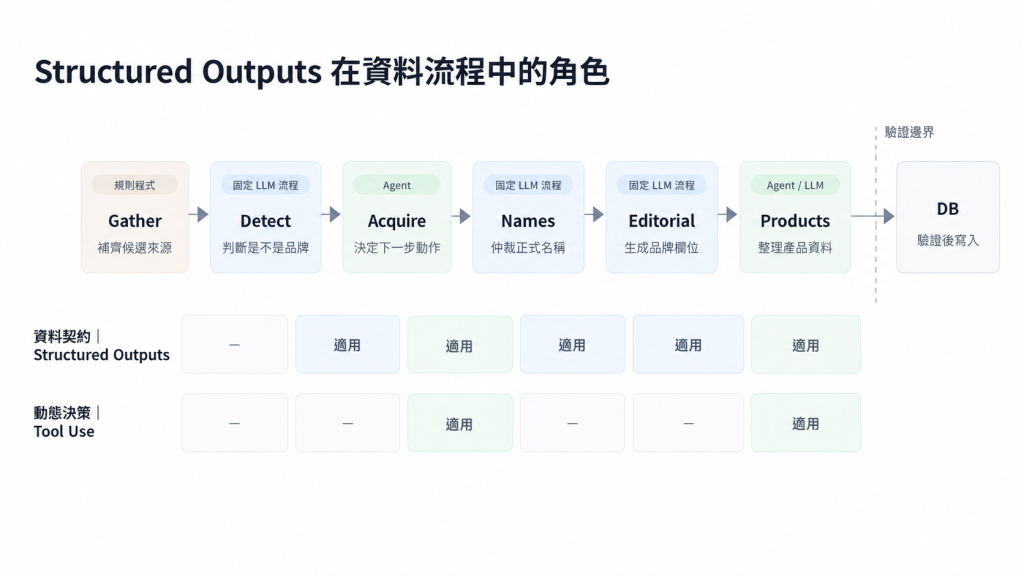
差別在於每個階段收到資料之後,要怎麼做決策並不一定相同:有些情況可以直接交給 deterministic code,例如 Detect 回傳 isNonBrand 和 confidence 後,程式可以按照固定規則決定要不要繼續;但有些情況沒辦法事先把下一步寫死。像 Acquire 取得新的頁面資訊後,模型可能要根據目前狀態決定接下來讀哪個頁面、是否改用瀏覽器渲染,或是不是已經拿到足夠資訊。
這裡先偷跑一個下一篇會談的概念:這種「根據目前資訊動態選擇下一步」就是 Tool Use 開始發揮作用的地方。但要讓模型做出好的動態決策,前提仍然是它能拿到完整、結構清楚、可以信任的上游資料。 Structured Outputs 不負責替 Agent 做決策,但能確保 Agent 接到的狀態資料足夠穩定;這也是 Agent 能不能有效解決問題的重要基礎之一。
今天先把模型的 output 和下一段程式的 input 接穩。下一個問題就是:當接收這些資料的不再只是固定規則,而是需要模型自己決定下一步時,該怎麼做?
下一篇會回到 Acquire,從 Tool Use 開始看模型怎麼選擇下一個動作,以及這份動態決策能力要怎麼限制在可控的範圍內。
我們明天見!


 iThome鐵人賽
 看影片追技術