

上一篇先把模組之間的資料交接處理好:透過明確的欄位、型別與結構,讓上一個階段的輸出可以被下一個階段穩定讀取。有了這個基礎,這篇開始往 Agent 內部走,看看一個階段收到資料之後,究竟怎麼決定接下來要做哪些事。這邊我們先複習一下我們之前提到會把資料獲取的流程拆成六個步驟:
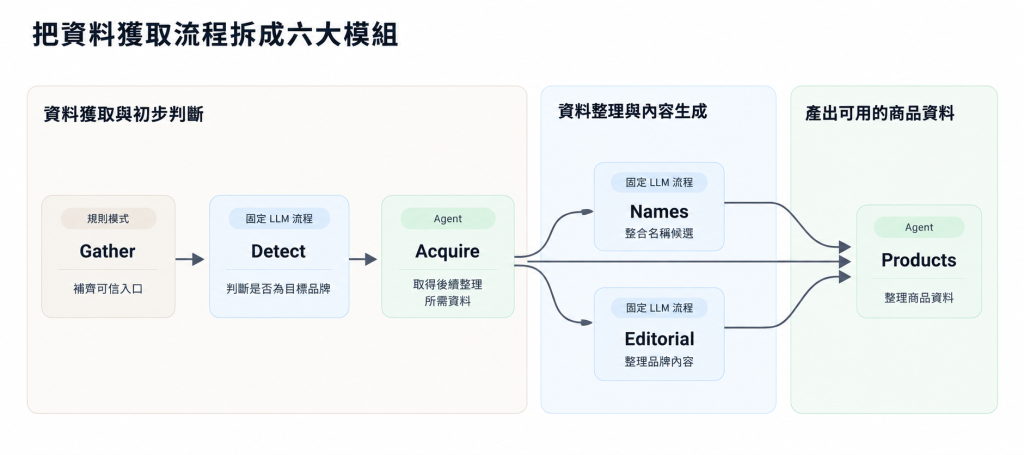
這邊我們會用 Acquire 這個步驟來當作為主要案例討論該怎麼執行:Acquire 從前一個階段拿到品牌資訊與一組可能的網站來源,但它還不知道真正值得讀的資料在哪裡,也不知道每個網站應該用什麼方式才能拿到有效內容。這篇要處理的核心問題因此是:當任務本身可以定義清楚,但執行路徑必須隨著當下資訊改變時,Agent 到底靠什麼能力決定下一步?
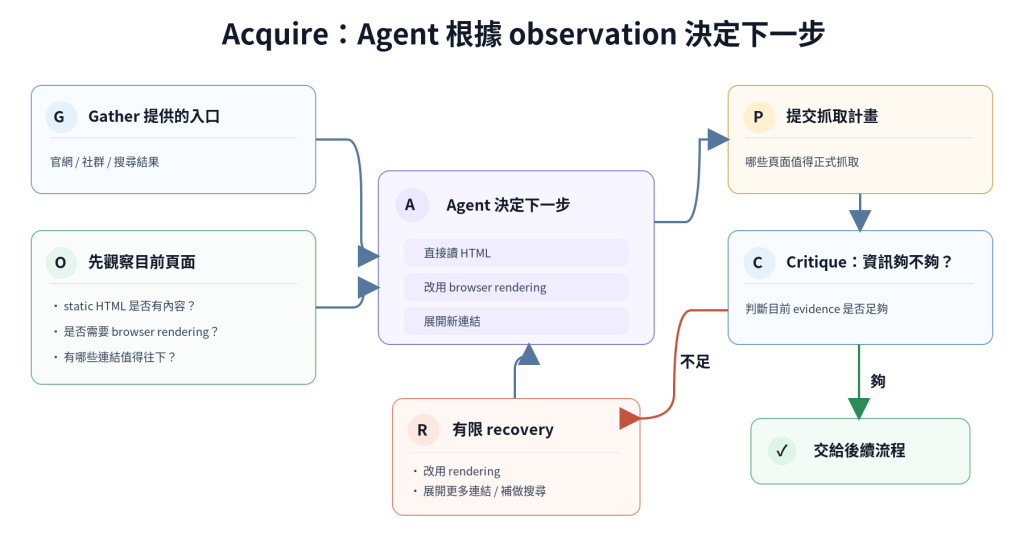
而讓模型能把這種判斷真正轉成行動的關鍵,就是接下來要談的 Tool Use。
當模型沒有任何「工具」或「能力」時,模型可以知道應該要去「商品分類頁」看看,但模型本身並不知道該怎麼實際完成這件事情。Tool Use 補上的就是從判斷到行動之間的那一段:模型提出要使用哪個工具與參數,外部系統執行後把結果送回模型,新的觀察結果再成為下一輪判斷的依據。
這裡想先稍微提一下各家 API 的命名不完全相同:
這裡我們關心的不是某一家 API 的 function schema 細節,因此後面統一使用 Tool Use 來稱呼我們這邊想解釋的觀念。
釐清這些名詞之後,接下來真正重要的是 Tool Use 如何改變模型的執行方式。先把它濃縮成一個最基本的互動迴圈:
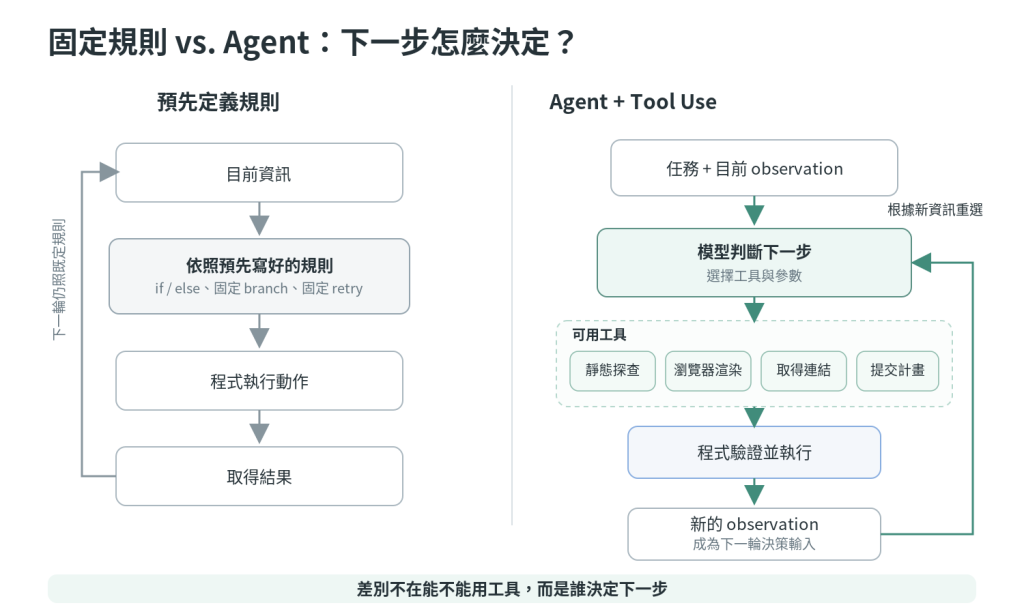
有了這個迴圈,模型就能根據每次工具回傳的新資訊調整下一步,而不需要沿著開發者事先寫好的固定流程前進。
然而,這個動態決策的能力本身也是有成本,因此不是所有流程都需要做成 Agent。如果可能遇到的情況有限,而且規則可以合理窮舉,直接把判斷寫成 if / else 通常更便宜、更快,也更容易測試;例如某個平台只有固定 API 與固定分頁規則,就沒有必要讓模型每次重新決定下一步。
真正適合讓 Tool Use 發揮價值的,是當狀況很難事先分類完整、不同觀察結果會改變後續路徑,而且我們無法合理列出所有分支時。這份彈性的代價是更多模型呼叫、等待時間,以及選錯工具或多做一步所產生的成本,所以我要保留的是難以規則化的選擇,而不是把所有資料處理都改成 Agent。
我們先稍微釐清一下 Acquire 這個階段的內容:
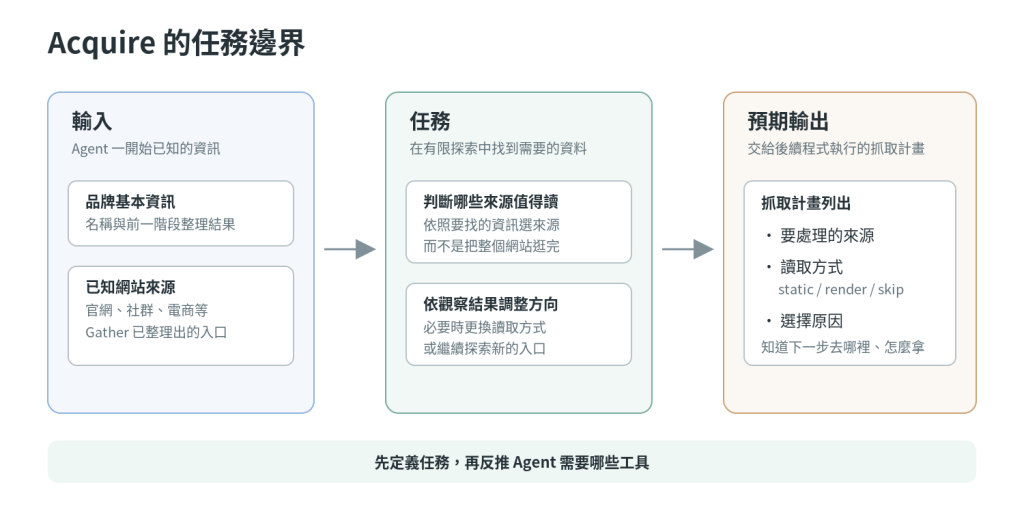
這裡會一個疑問:既然 Agent 已經知道該怎麼抓取資訊,為什麼不讓它在探索階段直接抓取資料?
原因不是 Agent 做不到,而是當「去哪裡抓、該怎麼抓」已經決定之後,後面的工作就逐漸變成機械性的執行問題。
當模型在探索時,模型需要針對現有的線索來做判斷,例如首頁值不值得繼續讀、是否需要瀏覽器渲染、哪個連結比較像商品入口等,這些資訊是我們沒辦法事先了解的內容,且也難以窮舉窮盡,但當抓取計畫已經確定並使用 Structured Outputs 整理成固定形式之後,按照指定 URL 取得內容、處理逾時、重試與錯誤記錄等反而更適合交給 deterministic code 進行可控且高效率的資料處理,而這樣可以把 LLM 的資源運用集中在真正需要語意與動態決策的地方,也讓正式抓取的成本與失敗行為比較容易控制。
從執行位置來看,Tool Use 大致可以分成兩類,差異在於「真正執行程式碼的是誰」:
這裡我們根據 Acquire 所需要執行的任務建立了許多不同的自訂工具,讓模型能自行決定「下一步想要做什麼」,以下四個為簡單範例:
// 簡化示意,不是完整 production code
probe_static({ url })    -> ProbeSummary
probe_rendered({ url })  -> ProbeSummary
extract_links({ url })   -> { links: string[] }
submit_plan(plan)        -> { accepted: boolean }
如果按照它們在任務裡扮演的角色來看,可以分成兩組:
probe_static 先用較便宜的靜態方式探查頁面;probe_rendered 在需要 JavaScript 時取得渲染後的結果;extract_links 則從實際頁面找出可以繼續探索的連結。submit_plan 接收符合 AcquisitionPlan 的抓取計畫;驗證通過後,規劃階段就可以結束。假設現在要替一個戶外用品品牌找出可讀的商品來源,一條可能的探索路徑會像這樣:
probe_static(首頁)→extract_links(首頁)→probe_static(商店頁)→probe_rendered(商店頁)→submit_plan(...)
這只是一條可能的路徑,不是固定流程。首頁的靜態內容如果已經足夠,Agent 可以直接提交計畫;商店頁如果不需要 JavaScript,也不必多做 rendering。Tool Use 真正帶來的彈性,就在於每次工具回傳結果後,模型都可以重新判斷「現在還缺什麼資訊」,而不是事先把所有網站都塞進同一條流程。
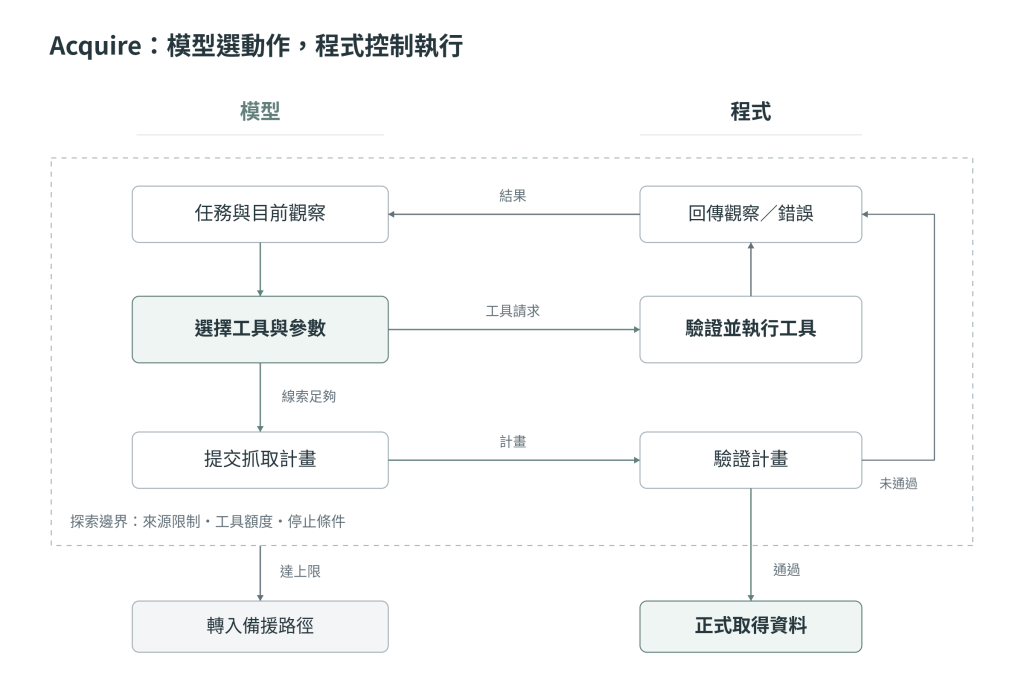
這張圖也把控制權的分工畫得比較完整:模型負責選動作,程式負責決定這個動作能不能執行。 在這個流程中我們也需要注意 Structured Outputs 的概念,工具參數與最後提交的抓取計畫都必須先通過 schema validation,才能確保後續的內容程式能夠正確的執行。
最後想要提到的一點:Tool 不是越多越好。每多一個工具,模型就多一個需要判斷的選項;試想當你十萬火急的時候打開了一個巨大的工具箱,裡面有各種可能可以解決這個問題的工具,這時候你要選擇一個好的工具反而會耗費非常多的氣力。真正重要的是把每個工具的責任定義清楚,讓模型能根據當下資訊選到正確的工具,而不是把所有可能的能力都塞進工具箱。
回到最初的問題,Acquire 之所以需要 Agent,不是因為它會呼叫 API,而是它必須在每次取得新資訊後重新判斷下一步。Tool Use 提供了這個「觀察 → 行動 → 再判斷」的迴圈;程式則定義哪些工具能用、哪些請求能執行,以及什麼時候必須停下來。
下一個問題則出現在資料真的抓回來之後,我們要怎麼有效率的清理資料並得到我們需要的內容呢?以照片為例,網站上的圖片可能是商品照、Logo、促銷橫幅,也可能只是無關的裝飾照片;能下載、畫質清楚的照片也並不代表適合放進品牌或商品資料。我們要怎麼使用 LLM 來高效率幫助我們解決這個問題呢?


 iThome鐵人賽
 看影片追技術