
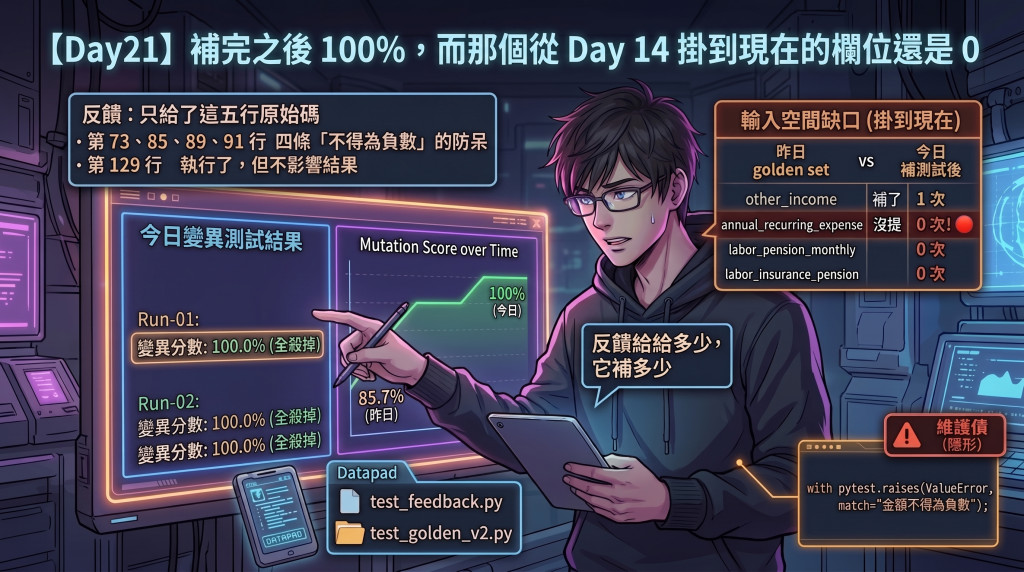
昨天留下兩個殺不掉的變異體:M09(移除金額負值校驗)與 M14(收入不隨通膨調升)。兩個的成因一樣:不是斷言太鬆,而是 23 組案例從來沒餵過會讓它們出錯的值。
今天把這件事餵回 AI,要它補測試。
反饋刻意只給一半,而且把昨天那兩種盲區分開講:
有四行從未被執行:第 73、85、89、91 行(四條「不得為負數」的
raise)。
另外有一行雖然每次都被執行,但它對最終結果沒有產生任何影響:第 129 行。
五行的原始碼都貼給它,但不告訴它要餵什麼值才會踩到。
給太多沒意義:直接貼上變異體的內容,它照著寫一條斷言就過了。給太少,單獨跑一輪也讀不出東西:只說「你有盲區自己找」,失敗了分不清是反饋不夠還是它不行——那個強度要成立,得有另一種強度擺在旁邊對照。
另外三條防作弊的約束寫進提示詞:不准改受測物、不准改 golden set、不准改現有測試(新測試另開一個檔案)。如果不擋這三條,最省力的方法就是回頭去改期望值:這樣測試會全綠,但盲區原封不動。
三輪,每輪開新對話,六個工具全關。
三份產物要依序過三道關:Day 16 的斷言檢核器、未變異時的基準線全綠、最後才是十四個變異體。
第一關三份都過,忠實性都是 100%。
run-03 卡在第二關。它的最後一條測試為了讓手算的 6300.0 成立,把退休與預期壽命設定為同年(retirement_age=65, life_expectancy=65)。這違反了規格中「退休年齡必須小於預期壽命」的限制,calculate() 直接拋出 ValueError,而它卻期待拿到一個計算結果。
有意思的是,同一個檔案上面四條測試,驗的正是「非法輸入必須拋錯」。它為了湊一個乾淨的數字,自己餵了一組非法輸入,而那組輸入就是 golden set 裡被拒絕的案例。
依驗收順序,run-03 不進第三關,也不代改。
另外兩份跑完,兩輪都是同一個結果:
基準線:未變異時 tests/test_golden_v2.py + tests/test_feedback.py 全綠

  ✓ 殺掉 M01 實證・第一幕實測(缺陷 A 驗屍)
  ✓ 殺掉 M02 實證・2 檔 2 處(進階 374、對照組 438)
  (中略,十四個全部殺掉)

殺掉 14 / 計分 14(總數 14、ERROR 0、等價 0)
變異分數 = 100.0%
85.7% → 100%。 M09 與 M14 雙雙被殺。
AI 這次處理負值校驗的表現,比封存在 manifest.yaml 裡的事前預測還要好。第 85 行只寫著「金額不得為負數」,要往上讀幾行才會知道 amounts 具體包含哪些欄位。那份預測擔心它會誤植為負的年齡或報酬率,但三份產物都正確用 parametrize 把七個金額欄位一次掃完,沒有遺漏。
三份裡 run-02 的 other_income 測試設計得最好。它建三個參數組合(無收入、有收入 1000、支出少 1000),然後斷言後兩者的計算結果必須相等:
assert r_with_income.target_fund == pytest.approx(r_equivalent.target_fund, rel=1e-12)
不依賴任何手算常數。通膨基準錯了、乘數 12 錯了,這條都會紅。
相較之下 run-01 是讓收入剛好等於支出,然後斷言 target_fund == 0.0。它殺得掉 M14(因為收入不隨通膨長大,兩邊的對稱就破了),但它只驗了「收支剛好相抵」這一個特例,在那個特例裡,任何維持兩邊相等的改動都不會被發現。
昨天順手掃了 golden set 的五個輸入欄位,其中四個幾乎沒被餵過值。補完之後再掃一次:
| 欄位 | golden 23 組 | 新測試給正值 |
|---|---|---|
other_income |
0 / 23 | 1 次 |
annual_recurring_expense |
0 / 23 | 0 次 |
labor_pension_monthly |
1 / 23 | 0 次 |
labor_insurance_pension |
4 / 23 | 0 次 |
other_income 補了,因為反饋點名了第 129 行。
annual_recurring_expense 是 PRD-08 的固定年支出,Day 14 列的三條待補測試之一,昨天掃出它是 0 / 23。
它其實被碰到了。三份產物都把它寫進「金額不得為負」的參數清單,餵了負值去驗拋錯。但從來沒有人給它一個正值,讓它真的參與一次計算。 反饋講的是「這四行 raise 沒被執行」,它就把七個欄位的負值那一側補滿了——正值那一側一個字都沒動。
反饋給多少,它補多少,一分不多。
而且 AI 並沒有做錯什麼。提示詞列了五個行號,它補了那五個行號,三條約束一條沒犯,忠實性 100%。照著要求做到滿分,跟把問題解決,是兩件事。
match=,三把尺都照不到三份產物加起來十四處 pytest.raises,每一處都帶了 match=:
with pytest.raises(ValueError, match="金額不得為負數"):
    calculate(p)
這樣寫抓 M09 是對的:match 綁住「哪一種錯」,不只「有錯」。移除金額校驗之後訊息就對不上,測試會紅。
但它同時把測試綁死在錯誤訊息的字串上。哪天有人把「金額不得為負數」改成「金額不可為負」,綁著這句話的測試會立刻變紅,而程式的行為一個字都沒變。 四種訊息各自綁了一批,改哪一句就紅哪一批。
而這件事,現有的三把尺一把都照不到:
| 看得到嗎 | |
|---|---|
| 斷言忠實性 | 看不到。pytest.raises 歸類為契約斷言,不進忠實性分母 |
| 行覆蓋率 | 看不到。那幾行確實被執行了 |
| 變異分數 | 看不到。它只問「改壞程式碼測試會不會叫」 |
三個指標同時給綠燈,而新欠下的這筆維護債,沒有任何一把尺照得到。
反饋原本規劃兩種強度:今天用的這種(給行號與原始碼),還有更弱的一種(只說一句「你的測試有盲區,自己找」)。為了省時間,我砍掉更弱的那種。
結果因為給了具體行號,三份產物全部順利補齊。放棄弱反饋的代價,就是無從得知「如果不給行號,它自己找不找得到漏洞」。省下來的那一小時,換掉的是整場實驗最該驗證的問題。
排測試計畫也是這樣。先被砍的永遠是花時間、可能難看、說不定什麼都測不出來的那些,而那些通常才是會讓你學到東西的。
這個 100% 不能拿來做什麼
它的意思是「目錄裡那十四個變異體都被殺掉了」,不是「測試變好了」。目錄沒有長大,annual_recurring_expense 仍然沒有任何測試在算它的值。
三次生成,單一模型、單一反饋強度,其中兩份進到變異關,標明為初步觀察。原本規劃的人工對照組取消:流程上出了差錯,對照組在寫之前就被 AI 產物汙染了,與其留一份看起來像證據的東西,不如不留。
三份的斷言組成偏斜:加起來十六條測試函式、十九處斷言,其中十四處是 pytest.raises,真正在比數字的只有五條。「非法輸入要拋錯」最好寫,也最容易讓分數變漂亮。
只帶走一件事
把盲區指給 AI 看,它會把那個盲區補起來:只補那一個。
反饋的邊界,就是它視野的邊界。
今天做的是補救:盲區已經冒出來了才餵回去。下一個問題比較根本:如果一開始的規格就寫得夠清楚,這些盲區還會出現嗎?
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day21


 iThome鐵人賽
 看影片追技術