

昨天把盲區餵回去,AI 把被點名的那個補起來了。今天換一個更前面的問題:盲區一開始是怎麼來的。
假設是規格。規格寫得細,測試就知道要驗什麼;規格只有一句話,它連該驗什麼都不知道。這個假設合理到不驗證就會直接寫進結論。
所以今天做一張對比矩陣。原本規劃四個規格等級乘以兩臺模型、三十二次生成,一天做不完,砍掉中間兩級只留兩個極端:L1(一句話)與 PRD 組(PRD v1.2 十二條條款),兩臺各五輪,共二十次。砍中段不砍模型,因為只剩一臺模型的結論永遠可以被一句話推翻:「你量到的是那臺模型的脾氣」。
Day 21 的提示詞附了 calc_fixed.py 全文,因為那天的任務是補測試。但今天要量的是規格細度,而實作本身就是最細的規格:兩組都附實作的話,一句話那組直接讀程式碼寫測試,差距會被抹平。完全不給也不行:不知道 Params 有哪些欄位,產物根本跑不起來。
折衷是只給簽名,不給函式本體,介面裡的中文註解只留符號對照。所以 labor_insurance_pension 是月額還是年額,PRD 組讀 PRD-10 知道,L1 組只能猜。那個猜不猜得中,正是今天要量的東西。
兩份貼上檔由程式拼接,共用段只寫一次,拼完自檢「挖掉規格區塊之後兩份逐位元相同」。手寫做不到:改了一邊忘了另一邊,自變數就從「規格細度」偷偷變成「指令用字」。
每一份產物依序過三道關:Day 16 的斷言檢核器、未變異時的基準線全綠、最後才是 Day 19 那十四個領域變異體。
可評分率 = 過了前兩關的套數 ÷ 該格生成套數,排在變異分數前面。因為 L1 格很可能整格走不到第三關,沒有這個指標那一格會是空白,矩陣塌成一欄。
| A:Gemini 3.1 Pro | B:Gemini 3.8 Flash | |
|---|---|---|
| L1(一句話) | 1 / 5 | 0 / 5 |
| PRD 組(十二條) | 2 / 5 | 1 / 5 |
規格效應在兩臺模型上方向一致,模型維度要回答的就是這件事。
表底下還藏著一個更大的數字:二十份產物,在未修改的實作上跑得出全綠的只有八份。 另外十二份,測試自己就是紅的。
八份有分數。量兩次:合計是 golden v2 加上該份腳本,單獨是只跑該份腳本。要分開量,是因為 golden 自己就有 85.7%,一份什麼都沒加的腳本,合計也會顯示 85.7%:那個數字大半是別人的功勞。
| 規格 | 單獨變異分數 | 份數 |
|---|---|---|
| L1(一句話) | 0.0% | 4 份,全部 |
| PRD 組(十二條) | 85.7% | 4 份,全部 |
一句話組殺掉 0 個,PRD 組殺掉 12 個。
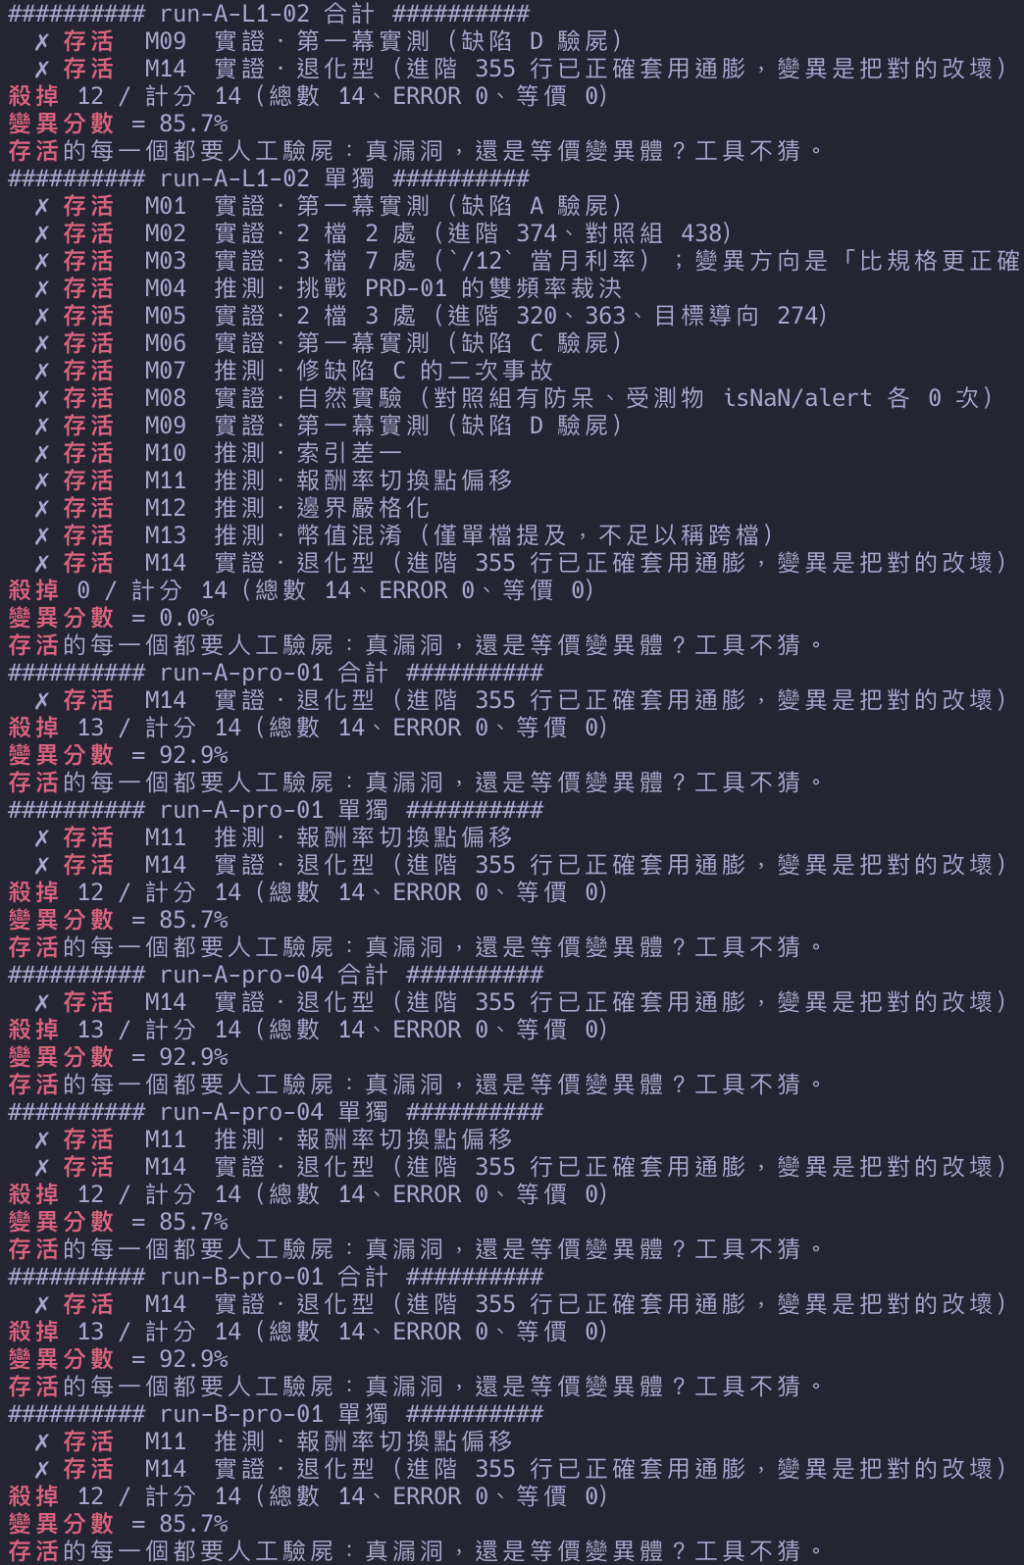
上圖第二段是 run-A-L1-02 的單獨結果:十四個變異體,十四行「存活」。它不是殺得少,是一個都沒殺。
而這份產物過了斷言檢核器,也過了基準線全綠。它的測試長這樣:
def test_lumpsum_dataclass():
    ls = LumpSum(age=50, amount=500000.0)
    assert ls.age == 50
    assert ls.amount == 500000.0
== 比的是精確值,嚴格得無可挑剔。但它驗的是 Python 的 @dataclass 有沒有把參數存進去,calculate() 裡面改壞哪一行都不會讓它紅。
十條測試裡另外五條長這樣:
def test_calculate_math_formula():
    pytest.skip("規格未定義具體計算公式 (例如:月/年複利、期初/期末投入),無法進行數值驗證")
它沒有亂編公式,是把規格缺口一條一條列出來然後跳過。照 Day 13 立的那把尺,這是滿分行為:罪在不標示,不在推論。
它誠實地告訴你它不知道要驗什麼,然後交出一份跑得動、綠燈全亮、什麼都沒驗的測試。
同樣是一句話的規格,兩臺模型選了相反的策略。
| 測試函式數 | 關 B 全綠 | 單獨殺傷力 | |
|---|---|---|---|
| Pro | 8–13 條 | 4 / 5 | 0.0% |
| Flash | 19–27 條 | 0 / 5 | 無法計分 |
Pro 寫得少,不知道的就 skip 並寫明理由,保持全綠。Flash 寫了兩三倍的量,幾乎不 skip,改成大量弱斷言硬填,五份全部在未修改的實作上就是紅的。
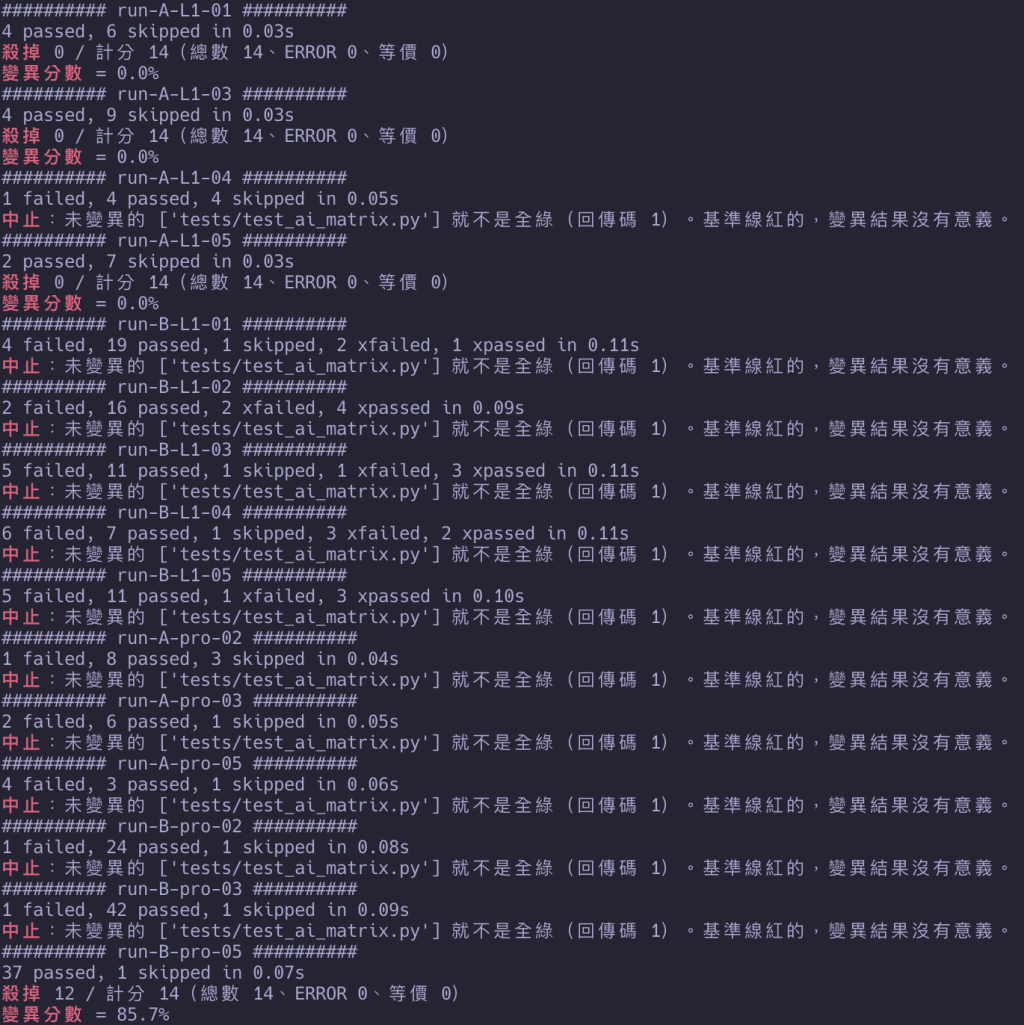
基準線紅的產物無法計分:引擎直接中止,因為未變異時就是紅的,那變異之後的紅代表不了任何事情。這是 Day 18 立的規矩,今天擋下十二份。
兩邊都沒解決問題。差別在於,只有一邊看得出來自己沒解決。
事前預期裡還寫著「輕量模型產出語法錯的機率較高」。實測二十份全部可解析。Flash 交出來的不是語法錯的東西,是語法正確但邏輯錯的東西,那比語法錯難發現得多。
PRD 組四份的單獨分數都是 85.7%,而且存活的變異體完全相同:M11 與 M14,四份一模一樣。四次獨立生成、跨兩臺模型、temperature 為 1,沒有一次超過那條線,也沒有一次低於。
盲區不是隨機的。 規格畫出的不是平均值,是天花板。
而 M14 那個洞可以一路追回到條款。它是「退休後收入不隨通膨調升」,要餵非零的 other_income 才踩得到。PRD-10 對 other_income 寫了幣值基準、寫了通膨鎖哪一年,就是沒寫單位是月額還是年額:旁邊站著 labor_pension_monthly、monthly_investment、monthly_expense_today,三個都標了 monthly,只有它沒標。
四份產物的反應分成兩種。一份在測試裡留下這句:
PRD-10 中
other_income規格未明確定義為月額或年額,跳過精確數值測試以免斷言失準
另一份沒發現,當年額算,實作當月額,基準線直接紅。
規格沒寫清楚 → 測試不敢寫或寫錯 → 變異體活下來。 從一句沒寫完的條款接到一個殺不掉的變異體,中間每一步都看得見。
順帶一個對照:人手寫的 golden set 單獨也是 85.7%,分數一樣,但活著的是 M09 與 M14。兩邊合起來 92.9%:各自補了對方的洞,只有 M14 兩邊都攔不住。
八份有分數的產物,把它們的忠實性和殺傷力排在一起:
| 忠實性 | 閘門 3 | 單獨殺傷力 |
|---|---|---|
| 100% | PASS | 0.0% |
| 83% | FAIL | 0.0% |
| 67% | FAIL | 0.0% |
| 56% | FAIL | 0.0% |
| 100% | PASS | 85.7% |
| 100% | PASS | 85.7% |
| 91% | PASS | 85.7% |
| 72% | FAIL | 85.7% |
忠實性最高的那一份,殺傷力 0%;忠實性最低、檢核器判不及格的那一份,殺傷力 85.7%,跟三份滿分的完全相同。忠實性從 56% 橫跨到 100%,對殺傷力沒有解釋力,真正決定它的是「L1 還是 PRD」。
這不是說 Day 16 那把尺沒用。它量的是「斷言嚴不嚴」,而 assert ls.age == 50 確實夠嚴;它不量的是「在驗什麼」,而那正是今天分出勝負的地方。
代理指標第一次被真正的量測驗證,結果是沒過。 系列問的那句「AI 寫的測試誰來測」,今天答了一半:至少,不能只靠檢核器。
Day 16 那道門的條件之一是「不得有零斷言的測試函式」,訊息印著「什麼都沒驗,pytest 照樣綠」。而今天的提示詞第 4 條主動要求:不確定的就用 pytest.skip 標示。結果二十份裡有六份,不及格的唯一理由就是它照著要求標示了。擋下的是我自己要求的行為,而且那句「照樣綠」是假的,pytest 報的是 SKIPPED,獨立一欄。
第一反應是不能改,「跑之前定,跑完不改」,於是提了個折衷:判準不動,另外加一欄診斷。然後被問了一句:這樣達得到本篇目的嗎,還是只是因為鐵則?
翻案之後留下一條判準:這個修正,能不能在看到任何一份產物之前、只憑 pytest 的語意寫出來? 能,是修 bug;不能,是調參。「pytest 報成 SKIPPED 的不是靜默變綠的」過得了這關,「門檻從 0.8 降到 0.5」過不了:那個 0.5 是看著 56% 挑出來的。
工作上更常遇到的是另一半:驗收標準公告出去了,之後才發現它寫錯。照著錯的標準判人,跟為了想要的結果改標準,看起來是兩個極端,其實是同一件事:都在迴避「這條規則當初為什麼要有」。
守規則是最省力的選擇。省力的地方在於,守規則的人不用負責。
這個 0% 與 85.7% 不能拿來做什麼
它們是「我設計的十四個變異體裡攔得住幾個」,不是「這份測試有多好」。換一份目錄,兩個數字都會變。可評分率各格是 1、2、0、1,變異分數無法做跨格比較,只能敘述;有分數的八份是「基準線綠的那些」,不是隨機樣本。
PRD 組不是乾淨的對照組。PRD v1.2 是知道四個缺陷之後寫的,每一條都長得像修正,Day 11 已經把這件事列為效度威脅。它的優勢有多少來自「寫得細」、多少來自「規格已經指著答案」,這一輪分不開。
兩臺模型的訓練配方與資料截止日都不同,「Flash 分數低」不能歸因到模型大小;它的思考等級也是手動從預設切上去的,量的不是預設表現。
關 A 的判準在 A 模型跑完之後才修正,A 那兩格帶著這個瑕疵;B 的生成在修正封存之後才進行。逐份數字、失敗成因與七條限制都在 manifest.yaml,驗收的原始輸出在 results/。
只帶走一件事
規格決定的不是測試的平均水準,是它的天花板。
四次獨立生成,沒有一次低於那條線,也沒有一次超過。
規格寫得夠細,測試就停在規格的邊界上。那接下來該問的是:那條邊界本身,AI 踩得準嗎?
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day22


 iThome鐵人賽
 看影片追技術