
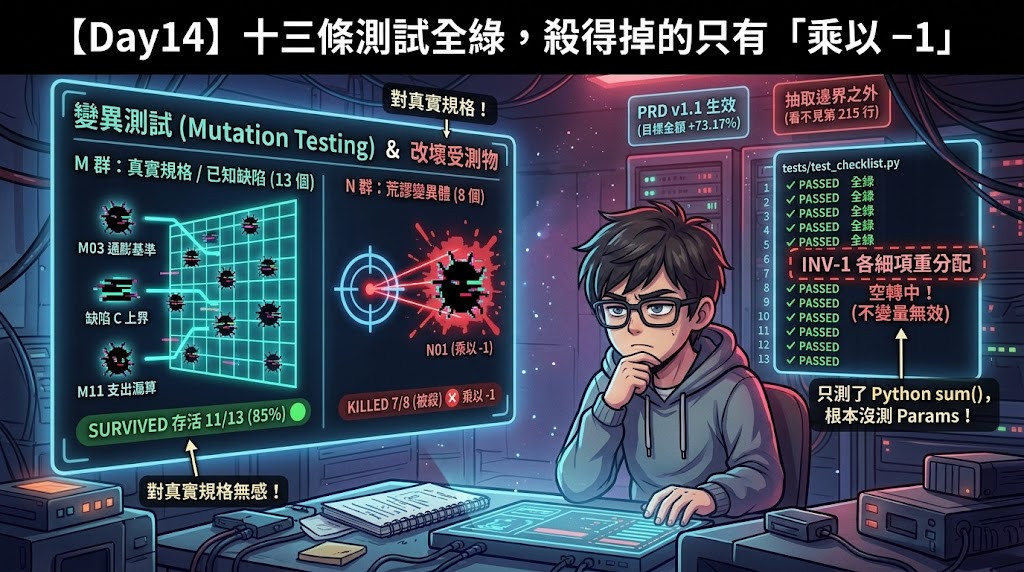
昨天裁下的三個規格缺口,今天正式落地為 spec/PRD-v1.1.md。規格書換了版,測試卻沒有。今天要查的就是這件事:這套測試究竟守不守得住新規格。
| 缺口 | 裁決 | 程式碼異動 |
|---|---|---|
| ① 月存投入時點 | 維持期末 | 0 行 |
| ② 退休後收入的通膨基準年 | 由鎖 A_c 改鎖各項自己的請領年齡 A_p |
有 |
| ③ 大筆支出是否隨通膨調增 | 維持調增、鎖 A_c,介面補標示 |
0 行 |
三個裁決背後是同一條原則:跟著使用者手上已經有的資訊走。勞保年金的數字來自勞保局試算(請領當年的名目額),大筆支出則是使用者憑今天的物價自估的,兩者的幣值基準年本來就不一樣。裁決 ② 非改不可的理由不只是「介面沒說」,而是鎖同一個基準年會讓收入與支出以相同指數成長,相減之後:
| 年齡 | 支出 | 收入(鎖 A_c) |
淨支出 |
|---|---|---|---|
| 65 | 567,684 | 378,456 | 189,228 |
| 75 | 692,003 | 461,336 | 230,668 |
| 85 | 843,548 | 562,365 | 281,183 |
收入/支出比三十年恆為 66.7%,一位小數都不動。一個宣稱在模擬通膨的模型,在它最關鍵的減法上把通膨消掉了。
代價不小。同一組參數下目標金額從 3,295,117 變成 5,706,115(+73.17%),方向保守(收入認列得少),但幅度高度依賴收入佔支出的比例:
| 月收入佔月支出 | 鎖 A_c |
鎖 A_p |
|---|---|---|
| 17% | 8,237,793 | 8,840,542(+7.3%) |
| 33% | 6,590,234 | 7,795,733(+18.3%) |
| 67% | 3,295,117 | 5,706,115(+73.2%) |
| 100% | 0 | 3,616,497 |
最後一列最刺眼:當收入等於支出時,舊規格算出的目標金額是 0,意即這個人不需要準備任何退休金。規格書現在說這樣算是錯的,而我手上那套測試從頭到尾沒有反對過。
受檢的是 tests/test_checklist.py,照 CheckList 框架(Ribeiro et al., ACL 2020)寫,13 條分三類:
這 13 條測試目前全綠。先從眼睛看得出來的那一條開始:
def test_inv_expense_category_reallocation(self):
    """INV-1: 「食衣住行育樂」各細項重分配但總額維持不變,計算結果必須逐位元完全相同。"""
    total_monthly = 45_000.0
    allocations = [
        {"food": 20_000, "housing": 15_000, "transport": 5_000, "misc": 5_000},
        {"food": 10_000, "housing": 25_000, "transport": 8_000, "misc": 2_000},
        {"food": 15_000, "housing": 15_000, "transport": 10_000, "misc": 5_000},
    ]

    results = []
    for alloc in allocations:
        assert sum(alloc.values()) == total_monthly
        p = Params(..., monthly_expense_today=total_monthly, ...)   # ← 不是 alloc
        results.append(calculate(p))
    # 然後斷言三個 results 全等
alloc 在迴圈裡只被用了一次,也就是那句 assert sum(alloc.values()) == total_monthly,它從來沒有進入 Params。三次迭代餵給 calculate() 的全是同一組參數。這條測試實際斷言的只是「同一組輸入呼叫三次結果要相同」(即 calculate() 的決定性),而那句 assert sum(...) 只是在測 Python 內建的 sum()。
它是對的,它會通過,但它什麼都沒測。這個缺陷在語意層而不在語法層:沒有型別錯誤,沒有未使用變數,沒有 linter 會叫。它甚至有工整的 docstring、三組資料與五個斷言。
另外十二條我逐條讀過,覺得都還好。但「覺得都還好」正是 Day 13 後記剛檢討過的那種主觀判準。所以我改用機器問:把受測物改壞,看這 13 條裡有誰會叫。這就是 mutation testing(突變測試,刻意改壞程式碼來檢驗測試案例抓蟲能力)的想法,只是我拿它來審一套 AI 寫的測試。
變異體分兩群:
分群是為了公平。DIR 只斷言單調性,對任何「保持單調的錯誤」結構性地看不見(例如月支出漏乘 12,方向依然正確)。要罵 DIR 沒抓到 M 群,得先看它殺不殺得掉荒謬的 N 群。
一行 python3 tools/test_mutator.py 跑完,結果:
| 變異體 | 數量 | 被殺 | 存活 |
|---|---|---|---|
| M 群(真實規格決定、已知缺陷) | 13 | 2 | 11 |
| N 群(符號反轉、結果歸零) | 8 | 7 | 1 |
存活的 M 群,每一個都是這個系列前十三天親手挖出來的東西:
| 存活的變異體 | 出處 |
|---|---|
M02 月存期末改期初、M03 收入通膨改鎖請領年齡、M04 大筆支出改鎖 A_r |
PRD v1.1 三裁決 |
M06、M07 提領與折現首年改 A_r |
Day 9 裁決「改」的 RC-01 |
M05 大筆支出補上界、M13 圖表不再夾 0 |
Day 3 驗屍的缺陷 C、A' |
M09 拿掉 max(0, ·)、M10 折現率用錯、M11 固定年支出漏掉、M12 月支出漏乘 12 |
PRD-09、PRD-08 等 |
第一列直接回答了今天的問題:PRD v1.1 的三條裁決,沒有一條有測試在守。把 M03 套上去(也就是把程式改成新規格要求的樣子),13 條依然全綠。而前三列那六個變異體的方向都不是把程式改壞,而是把已知的錯改對。這意味著 Day 30 我把缺陷一次修完時,這套測試不會告訴我修對了,也不會告訴我修錯了。它殺得掉「乘以 −1」,卻殺不掉「乘以 1/12」。
M 群只有兩個被殺,而這兩個的方向剛好相反。
M08(移除勞保起領年齡判斷)被 INV-3 殺掉。INV-3 設了一筆月領 5 萬、請領年齡 90 而壽命 80 的勞保(一筆永遠領不到的收入),然後斷言它不影響任何結果。把 if age >= start_age 拿掉這條就會紅。全套 13 條裡,只有它在守一條 PRD 條款的實際語意。
M01(本金改月複利)被 MFT-2 殺掉,而 M01 是 PRD-01 明訂的正解。
def test_mft_zero_monthly_investment_with_positive_return(self):
    """MFT-2: S=0 但 r>0,累積期退化為純現有資產單筆複利增值。"""
    expected_fv = 2_000_000.0 * ((1 + 0.05) ** working_years)   # 年複利
PRD-01 寫的是「統一採名目月利率 r/12,同為月複利」,這條測試把 (1+r)^n 釘成了預期值。說句公道話,它是對著 shadow/calc.py 寫的,而影子模型的職責本就是複製含缺陷的受測物。
問題不在它算出現況,而在於 docstring 寫成了「退化為純現有資產單筆複利增值」這種聽起來像數學真理的句子。Day 7 替這種情況發明過 locks_defect 標記,這條沒有。這導致這套測試唯一守住的規格細節,是一條 PRD 明文說寫錯了的規則。
原因出在輸入。掃一遍整份 test_checklist.py:
| PRD 條款 | 出現次數 | 其中非零/非空 |
|---|---|---|
| PRD-04 輸入校驗 | 0 | 0 |
| PRD-07 勞退月領 | 0 | 0 |
| PRD-10 其他收入 | 0 | 0 |
| PRD-06 勞保年金 | 2 | 1(start_age=90,壽命 80) |
| PRD-08 固定年支出 | 3 | 1(在 INV-1 裡) |
| PRD-05 大筆支出 | 4 | 1(在 INV-1 裡) |
退休後收入這整個子系統,在 13 條測試裡從來沒有被實際計算過。唯一一筆非零的勞保年金是 INV-3 那筆刻意永遠領不到的案例;它驗了「沒領到的不能算」,但「領到的算得對不對」卻全無測試,而 PRD v1.1 裁決 ② 改的正是後者。
另外,PRD-05 與 PRD-08 唯一的非零輸入全部都在 INV-1(那條三組輸入皆相同而空轉的測試)裡。所以當 M11 把固定年支出整段拿掉、M04 把大筆支出改基準年時,沒有任何測試在守。這證明了一條空轉的測試,不只自己沒有價值,還會把只有它碰過的輸入一起帶走,儘管從覆蓋率報告上看,那幾行程式碼都顯示為「被執行過」。
到這裡為止的處置都很明確:INV-1 是空轉,把 alloc 接上去就好。但現實是接不上去。
那個不變量本身是真的。受測物第 95–100 行有六個 expense-input 欄位(食、衣、住、行、育、樂),第 280 行以 reduce 加總,所以「怎麼分配不影響結果」確實是真實不變量,INV-1 意圖完全正確。
但 shadow/calc.py 檔頭寫著「逐行對應第 292–375 行」,而加總發生在 280 行(在抽取邊界之外)。影子模型的入口拿到的已經是總額浮點數,就算餵 total = sum(alloc.values()) 進去,三組總和都是 45,000,Params 還是全等。因此這條測試的處置不是修,而是二選一:提到 HTML 層測,或者刪除並寫明原因,因為它斷言的東西在這一層根本沒有介面。
這件事往回咬了 Day 5。閘門 2 當時為了不夾帶修正而裁決「機械式抽取 292–375 行」,這決定沒錯,但它同時決定了哪些行為永遠不會被這套測試看到。例如 280 行呼叫的 parseNumber:
const parseNumber = (str) => parseFloat(String(str).replace(/,/g, '')) || 0; // 215 行
|| 0 正是 PRD-04 明文禁止的「靜默補零」。而 PRD-04 在測試裡出現 0 次,不是測試偷懶,而是它站的那一層根本看不到 215 行。oracle 的邊界,就是測試視野的邊界。 這一點 Day 5 沒有寫下來,今天正式補上。
M 群存活 11 個,不需要 11 條新測試。挑三條打擊面最大的:
| 補的測試 | 會殺掉 |
|---|---|
勞保/勞退有領到時,第 t 年金額 = 月額 × 12 × (1+i)^(t − A_p) |
M03、M08 |
固定年支出非零時,目標金額對 annual_recurring_expense 嚴格遞增 |
M11、M12 |
大筆支出落在 A_d 之後不得計入(標 locks_defect) |
M05、M04 |
第三條實測會紅(9,694,101 vs 10,703,761),因為受測物 329 行只檢查下界(這正是缺陷 C)。依 Day 7 規則它該標 locks_defect 進 characterization,而不是留在 CheckList 裡假裝是不變量。而表單層(215 行的 || 0 與六欄位加總不變量)現有的 oracle 與影子模型都看不到,要嘛建 DOM 層測試,要嘛明寫「本系列不涵蓋表單層」。不能繼續處於「以為有測」的狀態。
這個數字不能拿來做什麼
M 群那 13 個變異體是我挑的,並非窮舉。「存活 11/13」量的是「我想得到的 13 個規格決定裡有 11 個沒人守」,而不是「這套測試漏掉了 85% 的東西」。換一組變異體,數字就會不一樣。
另外,變異跑的是 shadow/calc.py 而不是 HTML 受測物。Day 6 的 500 組差分證明的是兩者輸出等價,而不是逐行對應。這個區分今天特別重要,因為今天談的正好是「哪些行不在影子模型裡」。
只帶走一件事
測試全綠只代表它自己沒有失敗。要知道它在不在看,得把受測物改壞一次。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day14


 iThome鐵人賽
 看影片追技術