
前面幾天,我們已經把資料準備得差不多了,從認識 HAM10000、觀察 Class Imbalance,到把資料分成 Train、Validation 和 Test,接下來終於可以開始進入「模型」的部分。不過在真的建立模型之前,
我一直很好奇一件事:我們把一張圖片丟給模型,它到底是怎麼從圖片裡學到東西的?
我們常常會說「讓 AI 看很多圖片,它就會慢慢學會分類」,但 AI 並不是真的像人一樣用眼睛觀察圖片,對電腦來說,圖片最終還是前面介紹過的一大堆 Pixel 數值,那它到底怎麼從這些數字,最後判斷出這張圖片屬於哪一種病灶呢?這就要先從 Neural Network(神經網路) 開始認識
假設我們要教模型辨認 HAM10000 的皮膚病灶,首先需要兩個很重要的東西:
Feature(特徵)和 Label(標籤)
Feature 可以先理解成模型拿來進行判斷的資訊,以前面的圖片來說,圖片中的 Pixel、RGB 數值都是模型可以取得的影像資訊,而 Label 則是這筆資料真正的答案
以我這次的資料為例,Label即為dx欄位,我們希望輸入一張圖片給模型,模型能夠輸出正確的類別,而在訓練模型時,我們會把圖片交給模型,同時也告訴它正確答案,模型就是透過一次又一次的預測與比較,慢慢學習
Neural Network(神經網路)是一種由許多 Neuron(神經元) 組成的模型,這裡的 Neuron 並不是真的生物神經細胞,而是一個負責進行計算的單位
每一個 Neuron 會接收前面的數值,經過一些計算後,再把結果傳給下一層,當大量 Neuron 一層一層連接起來,就形成了 Neural Network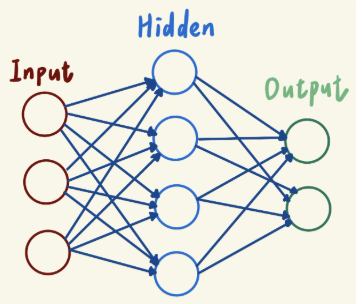
假設某個 Neuron 收到三個數值:x₁、x₂、x₃
它不會只是把三個數字直接加起來,而是每個輸入都會搭配一個 Weight(權重):x₁ × w₁x₂ × w₂x₃ × w₃
接著再把結果加起來,並加入一個 Bias(偏置):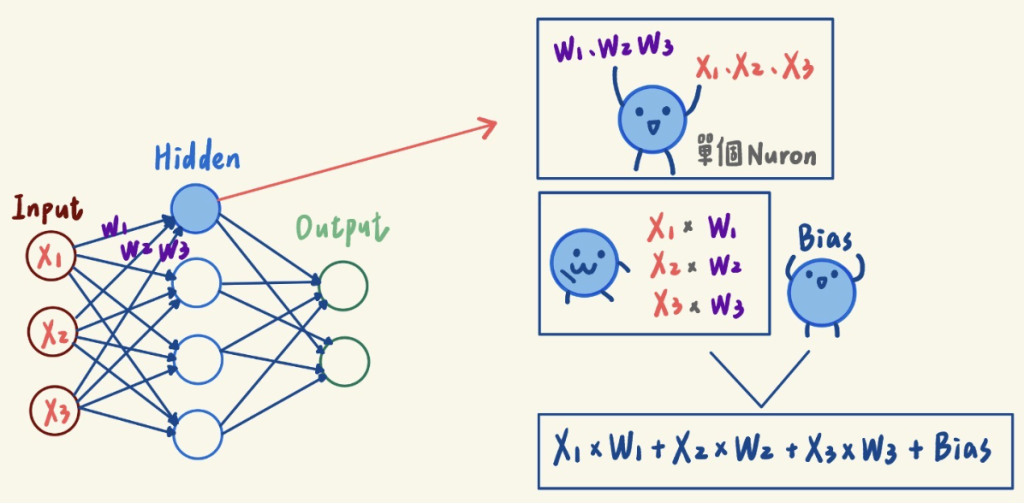
其中 x 是輸入資料、w 是 Weight,而 b 就是 Bias
Weight 可以理解成模型目前認為「這個輸入有多重要」的數值,而 Bias 則是一個額外的調整值,讓模型的計算可以更加彈性,Weight 和 Bias 都是模型在訓練過程中會不斷調整的參數
Neuron 計算完:x₁w₁ + x₂w₂ + x₃w₃ + b 之後,通常還會再經過一個 Activation Function(激活函數)
Activation Function 可以先簡單理解成對 Neuron 算出來的結果再進行一次轉換,讓 Neural Network 能夠學習更複雜的關係
例如之後建立模型時很常看到的 ReLU 就是一種 Activation Function,他的概念是:
假設模型第一次看到一張真正 Label 是 mel 的圖片,當模型猜錯時,模型會計算「他的預測和真正答案差多少?」,接著根據這個錯誤去調整 Neural Network 裡面的 Weight 和 Bias,再繼續看下一批圖片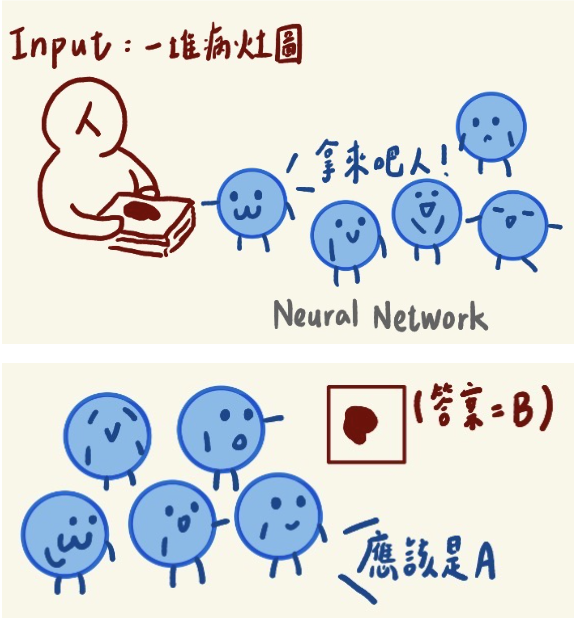
所以我們平常說的「模型正在學習」,其實背後發生的是模型透過大量資料反覆預測,根據預測錯誤不斷調整 Weight 和 Bias,逐漸找到能夠正確分類資料的參數
這樣我們就開始知道,模型並不是突然看懂了一張圖片,而是在大量的數值計算與參數調整中,逐漸找到可以幫助它完成分類的規律,不過這時又出現新的問題:
一張圖片裡有這麼多 Pixel,如果全部直接丟進一般的 Neural Network,真的適合嗎?
下一篇就可以從這個問題開始,看看為什麼處理圖片時,大家經常使用另一種特別的神經網路——CNN(Convolutional Neural Network)


 iThome鐵人賽
 看影片追技術