
上一篇我們發現 HAM10000 存在明顯的 Class Imbalance,也認識了幾種可能的處理方式,不過在真正開始訓練模型之前,還有一件非常重要的事情要做,就是把資料分開
我們手上有 10,015 張圖片,但是不能全部都拿去訓練,可以把模型訓練想像成準備考試,如果老師把所有考題和答案都先給學生練習,最後再拿完全相同的題目考試,就算得到 100 分,我們也很難判斷他是真的學會了,還是只是記住答案
一般會把資料分成三個部分:Train、Validation、Test
三份資料雖然都來自同一個 Dataset,但用途並不相同
Training Set(訓練集)是模型真正拿來學習的資料,模型會反覆看到這些圖片,計算預測錯了多少,再不斷調整自己的參數
所以可以把 Train 想成模型平常拿來練習的題目,通常也是三份資料中數量最多的一份
Validation Set(驗證集)不直接拿來更新模型參數,而是用來觀察模型對「沒有拿來直接學習的資料」表現如何?例如之後我們調整Learning Rate、Batch Size、模型架構、Epoch,就可以透過 Validation 的結果判斷這次修改有沒有改善
因此可以把 Validation 想成準備正式考試之前的模擬考
Test Set(測試集)則是最後評估模型表現時才使用,理想上,在模型訓練與調整的過程中,不應該一直根據 Test 的結果修改模型
否則就像每次考完正式考試都偷看答案,再回去修改讀書方法,久而久之,我們其實也在「針對 Test 調整模型」,那它就失去作為最後客觀評估資料的意義了
沒有一個比例適合所有 Dataset,常見的分法例如:
Train70% Validation15% Test15%
或
Train80% Validation10% Test10%
但這裡真正重要的不只是比例,因為 HAM10000 還有上一篇提到的問題:Class Imbalance
假設我們直接隨機切資料,對 nv 這種有 6,705 張圖片的類別來說,通常不會有太大的問題,但 df 只有 115 張,如果單純隨機抽取,就有可能讓某一份資料中的少數類別太少,例如原始 Dataset:
切完之後,如果比例沒有控制好,Validation 或 Test 中的 C 類可能變得非常少,這樣最後的評估結果就容易受到影響,所以我們希望切分之後,每一份資料都盡量維持原本的類別比例,這就是 Stratified Split(分層切分)
為了解決Random Split這個問題。它會在切分資料時參考原本的類別比例,讓 Train、Validation 和 Test 都盡量維持相似的分布
例如原始資料是 80% 的貓和 20% 的狗,那麼切分後的 Train、Validation 和 Test,也都會盡量保持約 80% 的貓和 20% 的狗
這樣做的目的是為了避免資料切分之後,讓原本就不平衡的類別分布變得更加偏斜,因此,Stratified Split 可以讓三份資料更接近原始 Dataset 的類別分布,之後用 Validation 或 Test 評估模型時,也比較具有代表性
在 scikit-learn 中,可以透過 stratify 來做到:
from sklearn.model_selection import train_test_split
train_df, temp_df = train_test_split(df, test_size=0.30, stratify=df["dx"],random_state=42)
stratify=df["dx"]就是告訴程式切資料的時候,盡量維持 dx 各個類別原本的比例,接著再把剩下的 30% 分成 Validation 和 Test
val_df, test_df = train_test_split(temp_df, test_size=0.50, stratify=temp_df["dx"],random_state=42)
前面透過 Stratified Split,我們可以讓 Train、Validation 和 Test 盡量維持原本的類別比例,但在真正切分 HAM10000 之前,我們還需要注意一個藏在 Metadata 裡的問題
在 Day7 中,我們曾經看到兩個欄位:
lesion_id:病灶編號
image_id:圖片編號
乍看之下,好像每一張圖片都有自己的病灶編號,但如果仔細觀察 Metadata: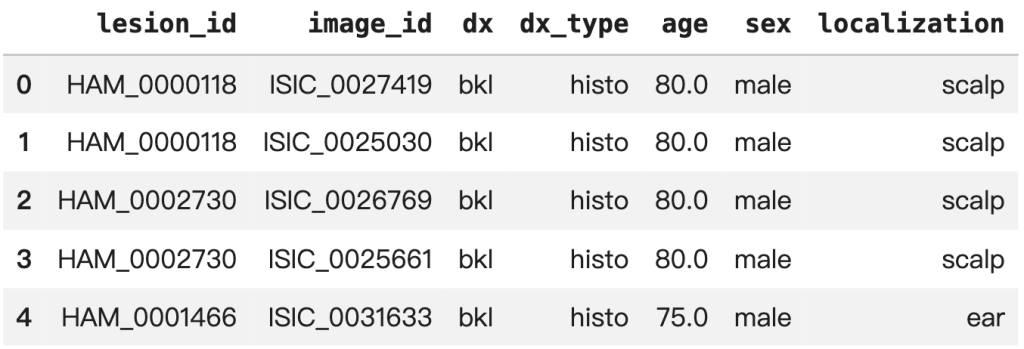
可以發現,ISIC_0026769 和 ISIC_0025661 明明是兩張不同的圖片,卻擁有相同的lesion_id,這是因為 HAM10000 中同一個病灶可能會對應到多張圖片,這時候問題就出現了,如果我們只是按照每一張圖片隨機切分資料,就有可能變成Data Leakage
雖然上述狀況 technically 是「兩張不同的圖片」,但它們其實來自同一個病灶模型在 Train 時已經看過這個病灶的其中一張照片,最後 Test 又拿同一病灶的另一張照片來考它,這就可能造成 Data Leakage(資料洩漏)
可以把它想像成正式考試雖然沒有出完全一樣的題目,但出了一題跟練習題高度相似、甚至來自同一個案例的題目
這可能讓 Test 的表現看起來比模型面對真正沒看過的病灶時更好
因此 HAM10000 的切分不能只考慮Class,還應該注意lesion_id,我們真正希望的是同一個lesion_id 的照片全部放 Train,或者全部放 Validation、Test,這種依照群組進行資料切分的概念稱為 Group Split。
而 HAM10000 同時還有 Class Imbalance,因此更理想的目標是以 lesion_id 為群組避免 Leakage,同時盡可能維持各個 dx 的類別比例
後面真正準備模型資料時,我們就可以依照這個原則進行切分,而不是單純對每張圖片 Random Split


 iThome鐵人賽
 看影片追技術