
昨天把三大支柱串起來,Day 7 的四句天花板只剩最後一句:只能被動查,不會主動通知。今天開始處理它。
這個區塊我要花四天,比 metrics 和 logs 都多。原因是告警是這整套裡最容易做壞的部分,而且做壞的代價很特別——它不會讓你查不到東西,它會讓你看到太多東西,然後全部忽略。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=false LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
寫這篇之前我做了一件從 Day 8 到現在都沒做過的事:打開 Alertmanager。
kubectl port-forward -n monitoring svc/kps-kube-prometheus-stack-alertmanager 9093:9093
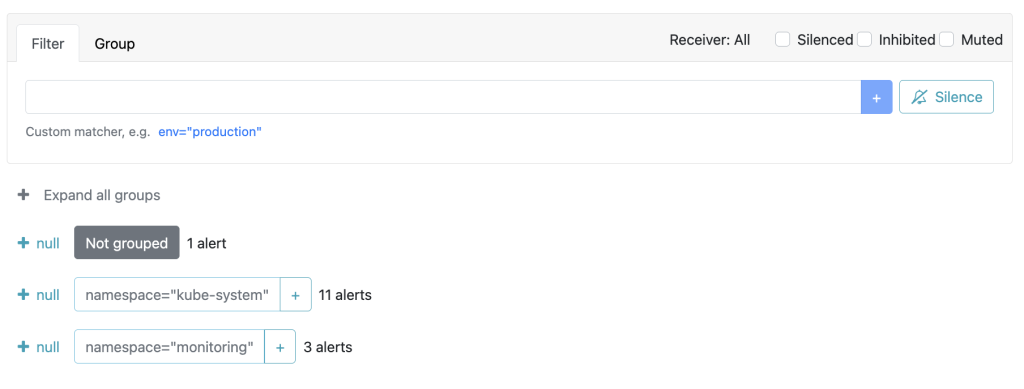
15 則,分成三組:kube-system 11 則、monitoring 3 則、還有一則沒有 namespace 標籤所以沒被分組。展開之後其中一則是 critical:etcd cluster "kube-etcd": insufficient members (0)。etcd 是 Kubernetes 存所有狀態的資料庫,它沒有成員代表整個叢集應該已經死了。
(左邊那三個 null 是接收者的名字。)
但叢集好好的,etcd 也好好的,kubectl get pods -n kube-system 看得到它 Running。這則告警從 Day 8 裝完 kube-prometheus-stack 那天就開始響,響了十三天,我一次都沒看過。
其他 14 則也一樣:kube-proxy、scheduler、controller-manager 抓不到,三個節點時間沒同步。全部是 kind 的環境問題——這些元件在 kind 裡只綁在 localhost,Prometheus 從外面抓不到;kind 的節點是 Docker 容器,本來就沒有跑校時服務。chart 的預設規則是照正式叢集寫的,不知道自己在筆電上。
我看了十三天的儀表板,從來沒看過旁邊那個一直在響的東西。這不是我不夠認真,是這 15 則告警沒有一則值得看,而我的直覺在第一天就判斷對了。問題是,如果哪天第 16 則是真的,它會跟前面 15 則長得一模一樣。
先建立一個觀念:每一則告警都在花某個人的注意力。
半夜三點響一次,隔天那個人的判斷力是打折的。而注意力這種資源,被浪費幾次之後就會產生抗體——看到通知先假設它是雜訊。這個抗體一旦形成,那則真正重要的告警也會被一起忽略。上面那 15 則就是我的抗體是怎麼長出來的。
所以告警不是加愈多愈安全。加一則告警之前要付出的舉證責任,比加一張圖高得多。 圖沒人看頂多佔螢幕,告警沒人看會把別的告警一起拖下水。
看到這則告警的人,知道下一步要做什麼嗎?
| 反例 | 為什麼不行 |
|---|---|
CPU 使用率 > 80% |
然後呢?Day 11 講過使用率高不代表在排隊 |
記憶體 > 70% |
同上,而且 70% 是哪來的 |
Pod 重啟了 |
重啟是 Kubernetes 的正常行為 |
etcd insufficient members (0) |
在 kind 上,什麼都不用做 |
這些的共同問題是:它們描述的是系統狀態,不是使用者受到的影響。 收到之後你能做的只有「去看一下」,而「去看一下」不是行動,是焦慮。
好的版本長這樣:
結帳可用性在過去一小時是 97.2%,低於 SLO 的 99%
它講的是我承諾過的事情正在被違反,而且有明確的下一步:去看 SLI 儀表板、找出哪個服務貢獻了錯誤、修它或回滾。
對症狀告警,不要對原因告警。 這句話出自 Google 的 SRE 書第六章。症狀是使用者結不了帳、結帳很慢,那該叫醒人;原因是 CPU 高、記憶體滿、連線池用盡,那不該叫醒人,但該畫在圖上。
理由有兩個。第一,原因有無限多種,你永遠列不完,但症狀就那幾種。第二,原因不一定造成症狀——CPU 100% 而使用者完全無感,那不是事故,是機器很努力。
Day 11 那個分層在這裡再嚴格一次:第一層的 RED 和 SLI 才可以拿來叫人,第二層的 USE 只能拿來查。
這則告警響的時候,誰負責?
如果答案是「大家都看得到」,實際上就是沒有人負責,每個人都會假設別人正在處理。所以主人要寫進告警規則的標籤裡:
labels:
  severity: page
  team: checkout
這在我這個一人專案聽起來很好笑,主人一定是我。但我還是要寫,因為兩件事:一是這個欄位決定了明天要講的路由,不同的主人送去不同的地方;二是寫下來會逼你面對一個問題——如果你沒辦法為某則告警指定主人,那它可能根本不該存在。上面那 15 則,我一則都指不出主人。
收到通知的那一刻,人在手機上,需要什麼資訊才能判斷?
最糟的通知長這樣:[FIRING] HighErrorRate。最起碼要有:
| 要素 | 例子 |
|---|---|
| 發生什麼 | 結帳可用性 97.2%,SLO 是 99% |
| 影響範圍 | 約 2.8% 的結帳請求 |
| 從何時開始 | 14:03 |
| 去哪裡看 | 儀表板連結 |
| 怎麼處理 | runbook 連結 |
最後一項差距最大。runbook 就是一份「這則告警響了該怎麼辦」的文件:先確認什麼、再看哪張圖、常見原因有哪幾種、怎麼緩解。
寫 runbook 的過程本身就有價值——如果你寫不出來,代表這則告警不符合條件一。你自己都不知道收到之後要做什麼,半夜被叫醒的人更不會知道。
這個系列到現在,「系統安靜地什麼都不說」這件事出現過太多次:
by (le),給你一條看起來正常的線或一張空的圖(Day 10)service 標籤被默默改名(Day 13)=~ 是整字串比對(Day 15)它們的共同點是:你做錯事的時候,系統不會告訴你。 告警系統本身也逃不掉這個問題,而且更嚴重——如果 Prometheus 掛了,你不會收到任何告警,而收不到告警的感覺跟一切正常一模一樣。
標準解法叫 dead man's switch,有時叫 Watchdog:設一則永遠都在觸發的告警,讓它定期送出通知,然後在外部設一個檢查,超過一段時間沒收到就代表監控系統死了。把「沒有消息」變成一種有消息。
回頭看那 15 則告警,第 15 則就叫 Watchdog,severity 是 none,規則是 vector(1)——永遠等於 1,永遠在響。它從 Day 8 就在那裡,我一直以為那是垃圾,今天才知道它是唯一一則設計正確的。
講一個我自己踩過、跟三個條件都有關的事。
這個系列開始之前,我寫了一個爬蟲去抓歷屆鐵人賽的文章做分析。跑到一半被網站的限流擋掉,回應全部變 429。而且那個限流是 IP 級的,擋住之後連單一請求都過不去,只能等。
當時沒有任何告警,是看資料沒進來才發現的。事後想,如果要為這件事設一則告警,它應該長這樣:
這個例子最有意思的是門檻的意義:偶發 429 和持續 429 是兩種完全不同的事件,前者不需要人,後者需要。如果告警不能區分這兩者,它就是雜訊。 這跟 Day 20 那 0.3% 的整機停頓是同一回事——超過 300 毫秒的請求有兩種,只有一種值得叫人。
「持續多久」這件事在 Prometheus 裡是一個內建欄位叫 for,而我是在截圖的時候才真正看懂它。
我把 Docker Desktop 關了幾天,重開之後去看 Alertmanager,昨天那 15 則一則都不剩。回頭查 Prometheus,才發現它們都在,只是狀態是 pending:
pending 14 則 / firing 1 則
告警規則的條件成立時,它不會馬上變成告警,而是先進 pending,要連續成立滿 for 指定的時間才轉成 firing,而 Alertmanager 只收 firing 的。chart 內建那幾則的設定是這樣:
| 告警 | for |
|---|---|
| Watchdog | 無,立刻 firing |
| etcdInsufficientMembers | 3 分鐘 |
| TargetDown、NodeClockNotSynchronising | 10 分鐘 |
| scheduler、controller-manager、proxy 抓不到 | 15 分鐘 |
| etcdMembersDown | 20 分鐘 |
所以我不是「告警消失了」,是叢集剛開機、還沒有任何一件事「持續夠久」。等了二十分鐘,15 則全部回來。
這個欄位就是上面 429 那個判準的實作:429 比例 > 10% 是條件,for: 5m 是「持續」。少了它,每一次網路抖動都會變成一則通知。
回到示範服務:
| 故障 | 該不該告警 | 怎麼設 |
|---|---|---|
| 一、算錯價回 200 | 該,但不叫醒人 | 影響六分之一的訂單但沒有立即危害,上班時間處理的工單 |
| 二、N+1 延遲 | 該,叫醒人 | 直接違反延遲 SLO |
| 三、記憶體洩漏 | 該,提前叫 | 現在無症狀,但會演變成事故 |
第一個特別值得說。它符合條件一(可行動:去補上缺的折扣規則),但不符合「需要現在處理」。這就是為什麼告警要分級,不是所有真實的問題都要在半夜處理。
第三個最有趣,因為它現在還沒造成任何症狀。前面才說對症狀告警不對原因告警,那記憶體洩漏該不該告警?該,但要用不同的方式設,而且不能用固定門檻。這個後面會專門講。
for 才算數,那是「偶發」和「持續」的分界明天動手:用 Alertmanager 把這些原則變成設定檔,順便把那 14 則誤報處理掉。


 iThome鐵人賽
 看影片追技術