

上一篇讓 Agent 根據當下資訊決定下一步,也把真正的資料抓回來了。但抓得到和格式正確的資料並不代表是我們需要的內容。
舉例來說,我們可能想抓一些商品的資訊來介紹這個品牌,Acquire Agent 成功從官方網站中找到商品頁面,並且透過後續的流程我們成功抓取下網站上的圖片。然而,一張來自商品頁的照片並不一定代表適合介紹這個品牌。圖片本身可能是有時效限制的促銷橫幅,可能是介紹品牌理念的概念圖文,可能圖片的畫質跟版型不符合我們的需求。前面幾天我們討論的流程只能確認 Agent 有沒有如實完成任務,但沒辦法很有系統性地知道這個任務完成的好不好。
我們有非常多的方式可以進行初步的資料驗證,例如我們可以透過圖片本身的屬性來篩選掉畫質過低或是版型過於狹長的圖片。然而,有些需要依賴對圖片本身理解的規則則難以用 deterministic code 來處理,這些理解需要依賴很多不同的 context:這張圖片接下來要放在什麼地方?想要達成什麼樣的目的?什麼樣的圖片叫做好的圖片?若不符合標準時要怎麼處理?
所以從這裡開始,問題就不再只是「有沒有抓到資料」,而是**抓回來的資料到底正不正確,能不能被我們拿來使用?**這件事沒有一個放諸四海皆準的標準,我們得先把「什麼叫做正確」定義清楚,後面才有辦法討論分類、內容整理,以及最後要怎麼做 Eval,這也是這篇會著重的主題。
我們來用一個真實的品牌案例來看會發生什麼情況。為了避免讓技術文章變成對特定品牌的公開評價,後面一律把它稱為 品牌 A,其中選定的一個商品則稱為 商品 A。
前面的流程已經成功找到商品 A 的頁面,接著我們的 deterministic code 會把商品頁轉化成類似以下的結構化格式:
// 簡化示意
type ProductPageEvidence = {
  title: string | null
  description: string | null
  mainText: string
  images: string[]
  jsonLd: Record<string, unknown> | null
  productSignals: boolean
}
看到這個 object 的第一反應很容易是:資料有 title、有文字、有圖片、有 JSON-LD,看起來已經很完整了,但這份結構真正告訴我們的只是**「程式抓到了什麼」**,但沒有告訴我們這些資料到底是否乾淨、可信、可用,例如 images 裡面確實可能有十張可以下載的圖片,但其中可能混著促銷 banner、Logo、尺寸表或其他商品;mainText 也可能讀得到很多文字,但內容不一定都在描述商品 A,又或是抓取到了頁面上完全跟商品無關的文字內容。
這也是我覺得 Data Quality 最容易被忽略的地方:**有資料並不代表資料就是對的;格式符合 schema,也不代表它就是我們要的答案。**如果上游抓錯頁面、混到別的商品,後面一樣可以產生一份格式漂亮、欄位齊全、甚至 reasoning 聽起來很合理的錯誤結果。這就是很典型的 garbage in, garbage out 的概念。
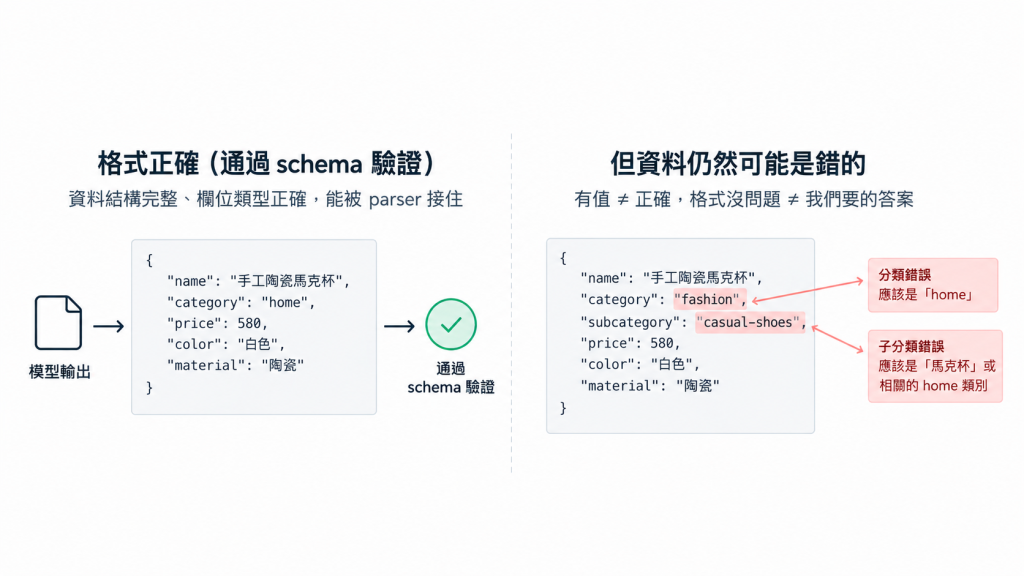
所以在這個案例裡,我們必須先把「正確」拆成三個不同層次:
| 要確認的事情 | 它代表什麼? | 商品 A 的例子 |
|---|---|---|
| 結構合規 | 資料有沒有符合我們定義的 schema、允許值與固定關係? | URL 可以解析、分類值存在、subcategory 確實屬於指定 category |
| 內容正確 | 欄位裡的資訊是不是真的在描述目標商品? | 圖片真的是商品 A,而不是同頁推薦商品;材質也真的來自商品 A 的來源 |
| 使用適切 | 即使內容本身沒有錯,它適不適合接下來的產品用途? | 促銷 banner 的確來自商品 A 頁面,但不適合拿來做長期商品主圖 |
這三個層次解決的是不同問題。先前我們提過的 Structured Outputs、type checking 或 data validation 等概念很適合處理「結構合規」這個概念,但「內容正確」與「使用適切」問的是另一件事:這個資訊真的在描述目標商品嗎?即使它是真的,放到現在這個產品用途裡還合適嗎? 這類問題也正是後面需要進一步拆解語意判斷的原因。
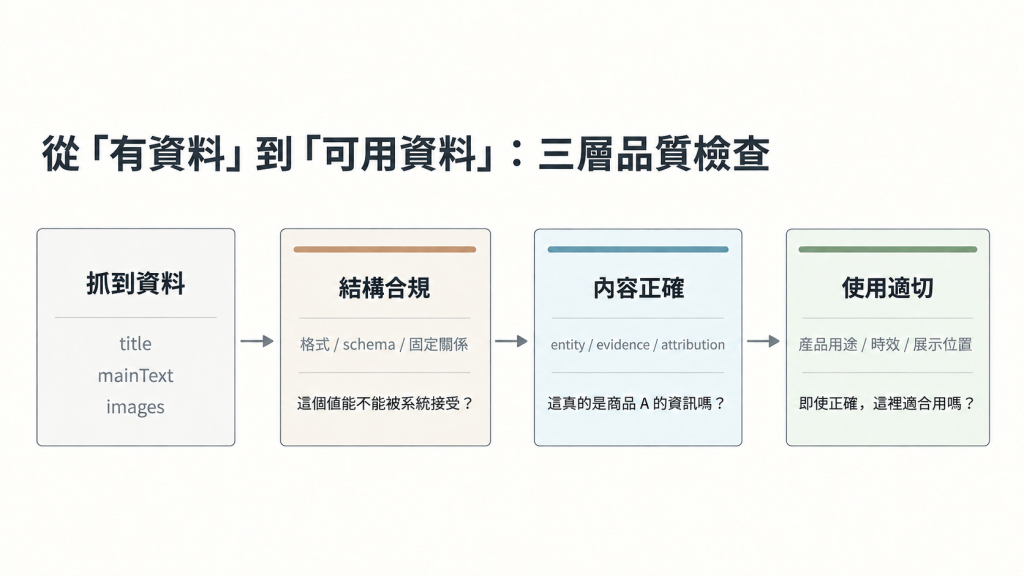
前面我們提到資料品質可以拆成結構合規、內容正確與使用適切三種問題來探討。回到前面的案例,我們提到我們已經將商品 A 轉為結構化的格式
// 簡化示意
type ProductPageEvidence = {
  title: string | null
  description: string | null
  mainText: string
  images: string[]
  jsonLd: Record<string, unknown> | null
  productSignals: boolean
}
要怎麼選擇解決問題的方式呢?比較實際的做法是先看問題本身的形狀,我們可以整理成以下的類型:
| 任務 | 答案長什麼樣子? | 商品 A 的例子 | deterministic code 的邊界 |
|---|---|---|---|
| Closed-set classification(封閉集合分類) | 從有限答案集合選 label | 從既有鞋履 taxonomy 選 subcategory | 答案集合與關係可以寫死;語意用詞與邊界案例很難全部枚舉 |
| Evidence-grounded synthesis(基於證據的內容整合) | 答案是自由文字,但每個陳述都要受來源支持 | 把多個來源整理成商品介紹 | 可以檢查格式與禁用詞,卻無法列出所有合理句子與所有可能的來源組合 |
| Multimodal / contextual judgment(多模態/脈絡判斷) | 依圖片、來源與使用位置做 keep / reject / rank | 判斷哪張照片適合商品卡或主圖 | 尺寸、比例、去重可寫規則;畫面主體與使用脈絡很難靠有限規則涵蓋 |
以下我們針對這三種任務形態做詳細說明。
第一種工作最接近傳統分類:答案集合是有限的,模型只需要從既有答案中判斷商品 A 最符合哪一個類型。舉例來說,若商品 A 本身是一個鞋款,那他可以在近一步被區分成以下幾種細部的鞋款分類:休閒鞋、樂福鞋、皮鞋、高跟鞋、涼鞋/拖鞋、靴子等。
若我們可以窮舉完所有的情形,我們則可以用簡單的 classifier 來進行分類,這部分我們可以使用傳統的 machine learning classifier 或是用簡易的 AI 模型達成。任務本身通常不需要太多的 reasoning,因此也不需要使用太過複雜跟龐大的模型。
這邊特別要留意的是,AI 仍然可能給出一個符合 Structured Outputs、但違反 taxonomy 階層關係的答案。以目前的分類為例,fashion 是 Level 1,leather-shoes(皮鞋)是其下的 Level 2,這邊還需要注意兩者之間的關係是否合理。即使模型回傳的兩個欄位各自都是合法值,也不代表它們組合起來就是合法的父子關係,因此還是需要一段邏輯來驗證來檢查這個階層關係。
第二種工作不是選一個分類,而是把分散資訊整理成可讀內容,例如商品簡介、FAQ 撰寫等。這類型的問題沒有可以窮舉盡的答案集合,相似的內容可以有很多種合理寫法,這種任務沒有唯一的標準答案:同一組 evidence 可以有很多種合理寫法,但每一個新產生的 claim 都必須能回到來源。例如來源只寫「鞋面為真皮」,我們可以改寫句子,卻不能把它擴大成「整雙鞋皆為真皮」;品牌介紹裡的設計理念,也不能直接被改寫成商品性能。
deterministic code 在這裡還是有角色:價格、禁用詞、字數、欄位完整性等條件都可以先固定檢查。但「這句話是否真的被來源支持」、「限定詞有沒有在改寫時被省略」、「兩個來源衝突時能不能這樣整合」,就沒有辦法靠列舉所有句型處理。這類問題需要理解 claim 與 evidence 之間的語意關係,因此後續的評估也不能只看 exact match,而要另外檢查 evidence support、重要資訊遺漏,以及限定條件是否被保留。
第三類型的工作則是從單一模態進入到了多模態的工作,複雜程度較先前更上一層樓。舉例來說,我們想知道所有抓到的商品 A 照片哪些適合當作宣傳產品照。我們除了需要先了解產品本身的相關資訊外(有賴於前面的內容),也需要對多模態的資訊(商品照)進行分析,去了解每一種圖片的類型來作篩選。圖片本身的尺寸、長寬比與重複圖片可以先由程式處理,但圖片本身到底是產品介紹圖、穿搭情境照、尺寸表、Logo、促銷 banner 、同一張圖的不同尺寸版本等,這些都需要模型 reasoning 後再去進行回答。
這三種任務也不互斥,同一條商品流程可能三種都用到。真正重要的是先辨認問題形狀,再決定哪一段用 code、哪一段值得交給模型,而不是把所有 data quality 問題都包成一次 LLM call。
到這裡我們已經知道有哪些判斷任務,但還有一個更麻煩的問題:模型回傳了一個答案,不代表我們知道這個答案有多可靠。
假設模型只回傳 isNonBrand: false。這個 false 可能代表「我很確定這是一個品牌」,也可能只是「目前證據太少,我沒有足夠理由把它排除」。如果系統只保存最後的 yes / no,這兩種狀況在 downstream 看起來完全一樣,因此目前實作的 Structured Output 不只有最終 decision,也要求模型一起回傳 confidence 與一段 reasoning,以下為一個範例:
const detectSingleShape = z.object({
  reasoning: z.string(),
  isNonBrand: z.boolean(),
  nonBrandReason: z.string().nullable(),
  confidence: z.enum(["high", "medium", "low"]),
})
confidence 讓系統至少知道模型怎麼描述自己的不確定性;reasoning 則提供一份可以人工檢查的判斷說明。當結果出錯時,我們比較有機會知道模型是看錯 evidence、誤解規則,還是只是資訊不足。但這兩個欄位都不是正確性的證明。模型說 high,不代表它真的有 90% 或 99% 的正確率;一段看起來很完整的 reasoning,也可能只是替錯誤答案提供一個合理敘事。
真正要回答「模型做得對不對」,還需要一個 Golden Dataset 作為基準
這裡常見的方法是先人工產生一批 golden dataset,以人工確認 input 還有 expected output,再讓不同 prompt 或模型去處理資料後比較:
confidence 的 high / medium / low,和人工判斷的不確定程度是否一致;這就是 Eval 真正開始的地方:單筆輸出讓我們看見模型怎麼回答;golden set 才讓我們知道這種回答方式在一批案例上到底靠不可靠。 至於要用什麼 metric、怎麼切 holdout、confidence 到什麼程度才能自動採用,還有如何用其他 LLM 方法進行不同的 Eval,我們後面會再深入探討。
今天這篇文章先簡單簡介了這個專案中遇到的三種問題類型,以及如何開始建立 Eval 的觀念,接下來我們會針對這些主題進行深入探討,下一篇先從三種任務裡邊界最清楚的 closed-set classification 開始。
我們明天見!


 iThome鐵人賽
 看影片追技術