
Day 13 講「用 AI 用久了驗證會鈍化」, 結尾給了五招破法. 但如果你想: 為什麼一定要防止判斷力鈍化? 反正用 AI, 有效率就好了不是嗎?
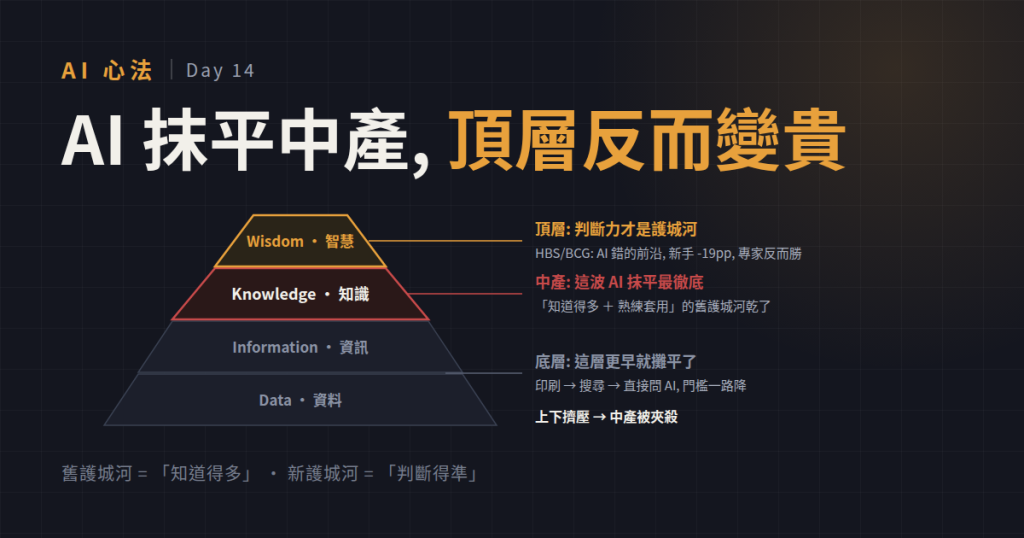
這篇回答那個 why. 判斷力不是選配, 是唯一你賣得掉的東西. AI 這波抹平了知識層 (中產吃飯的地方), 底層早攤平了, 頂層 (判斷力) 反而變得更貴、更難爬. 你如果放任判斷力鈍化, 就是主動把自己從頂層推回中產, 然後跟另外幾億人一起被 AI 夾殺.
先給地圖 (DIKW 金字塔), 再給實證 (為什麼中產被夾), 再給頂層為什麼反而變貴, 最後給隱憂 (往上爬的階梯也被抽掉了).
DIKW 是 Ackoff 1989 提的知識層級, 四層堆疊:
Data 資料 → Information 資訊 → Knowledge 知識 → Wisdom 智慧
(原始事實 → 加了脈絡 → 會應用、看出模式 → 有判斷、知道為什麼/該不該)
普遍共識: 電腦一直都擅長下層 (data / info), 上層的 knowledge / wisdom 才是人的主場. 但 LLM 這波戰線往上推到了 Knowledge 層. Knowledge 恰好是知識中產吃飯的地方.
| 層 | 誰在這層 | AI 這波動了嗎 |
|---|---|---|
| Wisdom (智慧) | 頂層專家: 判斷、品味、當責、問對問題 | ❌ 打不到, 反而變貴 |
| Knowledge (知識) | 知識中產: 靠掌握既有知識 + 熟練套用維生 | ✅ 這波抹平最徹底 |
| Information (資訊) | 加了脈絡的資料 | ✅ 這層更早就攤平了 |
| Data (資料) | 原始事實 | ✅ 這層更早就攤平了 |
三份大型研究都指同一結論: AI 對新手/低技能者的幫助遠大於專家, 兩者差距被壓縮.
| 研究 | 樣本 | 發現 |
|---|---|---|
| Brynjolfsson et al. | 5,179 名客服 | 平均生產力 +14%; 最低技能者 +34% |
| Noy & Zhang | ~444 名專業寫作者 | AI 寫作縮小品質離散度 (差的被拉上來, 好的沒明顯拉升) |
| GitHub Copilot | 開發者實測 | 完成快 55.8%; 經驗較少者受益更多 |
機制: LLM 擅長把「過去要靠師徒口傳的隱性知識」語言化、規模化供應. 結果:
這些原本要「掌握大量既有知識」才做得到的事, 現在只要會問就能做.
把兩件事疊起來:
疊到 DIKW 上, 就看得出誰被夾:
⚠️ 中產護城河乾了: 舊護城河是「我知道得比你多、我做得比你熟」. 現在:
- 知道得少也能問到
- 程序化的熟練 AI 幾秒做完
留下來的價值不在「知道與熟練」, 而在上面一層的「判斷與取捨」 — 但那是頂層專家的地盤. 中間因此被上下擠壓、變薄.
拉平只發生在「定義清楚、好查對」的任務. 到 jagged frontier (鋸齒狀前沿, 白話 = AI 不可靠但看起來很合理的地帶), 結果反過來.
Harvard/BCG 研究 (Dell'Acqua et al., 2023, 758 名顧問): AI 讓資淺顧問的表現被拉齊到接近平均. 但在 AI 出錯的前沿任務:
→ AI 拉平基礎, 卻在前沿放大了判斷力的價值.
新護城河長這樣: 隱性知識 (tacit)、情境判斷、品味、問對問題、當責與信任 — 這些是 "know-why / know-when", 不是 "know-what".
呼應 Day 11 的獨立驗算 (你自己得看得出 AI 錯在哪) 和 Day 13 的破法 (別讓判斷力鏽掉) — 這兩天教的正是頂層的核心能力.
壁壘被打破的代價: 新手拿到產出, 卻跳過了長出判斷力的過程.
⭐ 對知識中產是雙重打擊:
- 現有工作被夾殺
- 通往頂層 (判斷力) 的階梯, 因為 AI 代勞而變得更難爬
要活下來, 得刻意練「AI 做不到的那一層」, 而不是把它也外包出去. Day 13 那五招破法 (ensemble、XAI、pre-commit、純腦子日、對抗性自測) — 都是為了這件事: 主動保住通往頂層的階梯.


 iThome鐵人賽
 看影片追技術