
當 Agent 在每次請求中都需要帶上大量固定的背景資訊時,Prompt Caching 能讓模型服務商重用這段文字的中間運算結果,大幅降低重複輸入的 Token 費用,並縮短首字回應時間。
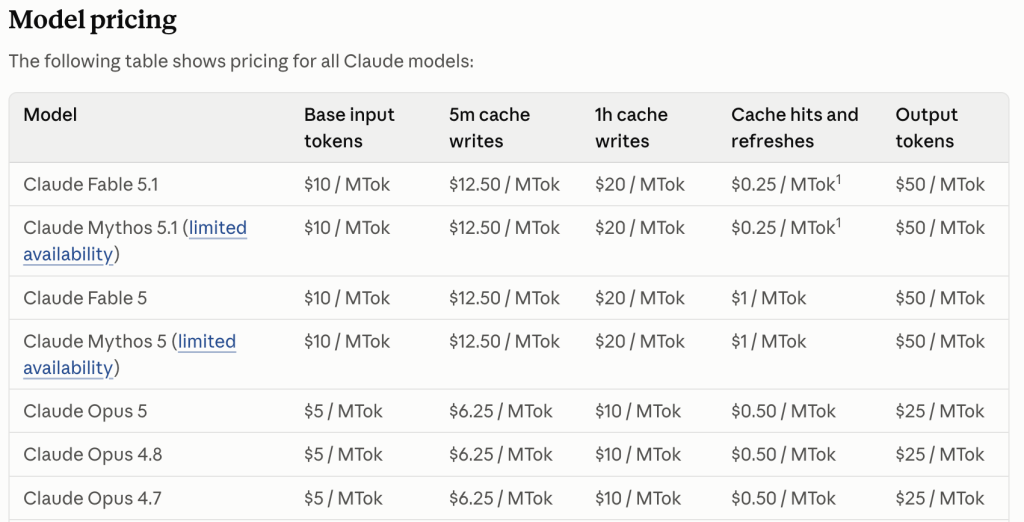
從下方 Claude 模型計價表可以看出快取的成本優勢:命中快取後的讀取價格(Cache hits and refreshes)遠比一般基準輸入(Base input tokens)便宜。以 Claude Opus 系列為例,常規輸入每百萬 Token 需要 $5,但快取命中後的讀取價格僅需 $0.50(相當於原價的一折);雖然初次寫入快取需支付略高的寫入成本(5 分鐘快取寫入為 $6.25),但只要在後續多次請求中命中同一前綴,就能大幅攤平輸入成本。
Prompt Cache 依賴嚴格的前綴匹配(Prefix Matching)。比對是從第 1 個 Token 開始依序向後檢查,只要中間有任何字元、空白、時間戳或訊息順序改變,改變位置之後的所有內容都無法沿用既有快取。
因此,組裝傳給模型的訊息時,應依變動頻率由低到高排列,讓靜態內容盡可能落在前綴:
在編寫 System Prompt 時,最常導致快取失效的原因是在最開頭插入動態值。例如在指令第一行寫入 目前時間:2026-09-01T15:00:00,會使每一次請求從第 1 個 Token 開始就彼此不同。後續即使附帶了數千 Token 的退貨政策與工具規格,也會因為開頭變動而全部無法命中快取。動態資料必須從前綴中抽離,移至快取標記之後。
在實作上,快取標記可以交給系統自動管理,也可以由開發者精確指定。以 Claude API 為例,支援兩種模式:
cache_control。隨著對話輪數增加,系統會自動將快取斷點向後推移,舊的歷史紀錄自動轉為快取讀取,適合內容線性增長的標準對話。cache_control。適合前綴中夾帶時間戳、Request ID 等動態值,必須將靜態規則與動態變數明確隔離的場景。對於常見的多輪對話情境,自動快取(Automatic caching)是最直接的起點。不需要在每輪訊息中手動計算或指定斷點,只要在請求的最頂層帶入 cache_control:
from langchain_anthropic import ChatAnthropic

model = ChatAnthropic(model="claude-3-5-sonnet-20241022")

# 在最頂層傳入 cache_control 啟用自動快取
response = model.invoke(
    messages,
    cache_control={"type": "ephemeral"},
)
若使用 Anthropic 官方 Python SDK,同樣是在 messages.create 的最頂層傳入參數:
import anthropic

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-3-5-sonnet-20241022",
    max_tokens=1024,
    # 頂層參數啟用自動快取,由系統自動推移斷點
    cache_control={"type": "ephemeral"},
    system="你是電商客服助理...",
    messages=messages,
)
在自動快取模式下,模型服務商會自動把快取斷點標記在最後一個符合門檻的可快取區塊。當對話從第 1 輪進行到第 2 輪、第 3 輪時,系統會自動將快取斷點向後推移,舊的對話歷史自動轉為快取讀取(Cache Read),省去每一輪手動標記歷史訊息的負擔。
雖然自動快取能簡化多輪對話的快取管理,但它依賴整個前綴的完全穩定。如果需要在 System Message 中傳入每次變動的動態數值(例如當前時間戳或 Request ID),若直接將動態值拼入字串,會導致前綴開頭每次都不同,自動快取就會全數失效。
這時就必須改用前述的「顯式快取斷點(Explicit cache breakpoints,即自訂快取點)」:由開發者手動在個別 Content Block 上指定 cache_control,精確劃分「要快取的靜態前綴」與「不快取的動態內容」。
在主流模型(如 Anthropic Claude 系列)的 API 規格中,傳入順序通常為 tools → system → messages。Tool 定義出現在 System Prompt 之前,因此當在 System Prompt 上設置快取標記時,被快取的前綴範圍會自然涵蓋工具定義。
在需要於 System Message 提供當前時間或 Request ID 時,最容易犯的錯誤是用字串格式化把時間與固定規則拼成同一段字串:
# 錯誤做法:時間每一秒都在變動,導致整段字串與後續的政策全部無法命中快取
SystemMessage(content=f"目前時間:{now}。\n你是電商客服助理...退貨政策:...")
模型服務商比對前綴時是從第一個字元向後逐字比對。時間放在開頭會直接使整段字串變成全新的前綴,連帶讓後方數千字的固定規則失去快取效益。
正確做法是利用清單將 content 拆分成多個獨立的 Content Block(內容區塊):
"cache_control": {"type": "ephemeral"} 標記快取點。
def build_system_message() -> SystemMessage:
    return SystemMessage(
        content=[
            # 區塊 1:固定不變的內容,末端標記快取點
            {
                "type": "text",
                "text": (
                    "你是電商客服助理。請依退貨政策解答顧客疑問:\n"
                    "1. 一般商品享有 7 天猶豫期,商品須保持全新未拆封。\n"
                    "2. 個人衛生用品與客製化商品除瑕疵外不接受退貨。\n"
                    "3. 申請退貨需具備有效訂單編號,退款於驗收後 3 個工作天撥款。"
                ),
                # 告訴模型快取保存到此為止,前綴包含 Tool Schema 與此段固定規則
                "cache_control": {"type": "ephemeral"},
            },
            # 區塊 2:每次都在變動的內容,排在快取點之後
            {
                "type": "text",
                "text": f"目前 UTC 時間:{datetime.now(UTC).isoformat()}",
            },
        ]
    )
當第一個 Content Block 結尾標記了 cache_control,Provider 就會把此處之前的全部內容(Tool Schemas 與退貨政策)作為穩定前綴快取下來。第二個 Block 雖然每次時間都在變更,但因為排在快取點之後,只會被視為快取後方的增量輸入,完全不影響前方穩定前綴的命中。
傳給模型的 Tool 清單也必須維持固定順序。即使兩次請求提供相同工具,只要清單順序或 Description 中的文字不同,序列化後的前綴就會不一致。
回應時間變快不能作為快取生效的可靠證據,因為延遲會同時受到網路品質、伺服器即時負載以及輸出 Token 長度影響。必須檢查模型回傳的 Token 計量欄位,才能確定快取是否真正命中。
使用 ChatAnthropic 呼叫後,可以從回傳的 usage_metadata 讀取正規化後的欄位:
response = model.invoke(
    [
        build_system_message(),
        *messages,
    ]
)

token_details = response.usage_metadata.get("input_token_details", {})
print(
    {
        "cache_creation": token_details.get("cache_creation", 0),
        "cache_read": token_details.get("cache_read", 0),
        "input_tokens": response.usage_metadata.get("input_tokens", 0),
    }
)
各欄位代表意義如下:
cache_creation:第 1 次請求或快取過期時,被寫入快取的前綴 Token 數。寫入快取的運算成本通常略高於一般輸入(約為 1.25 倍)。cache_read:後續請求成功命中快取的前綴 Token 數。讀取快取的成本通常只有常規輸入的 10%(享有 90% 折扣),且前綴長度越長,節省的 prefill 時間越明顯。input_tokens:本次請求中,位於快取標記之後、未被快取涵蓋的非結構化增量 Token 數。在線上環境中,我們不會仰賴終端機手動印出 usage_metadata。後續在用 Langfuse 建立 Agent 評估流程的這篇中,會進一步介紹如何透過 Langfuse 的 Tracing 自動收集這些欄位,直接在儀表板與 Trace 視圖中持續觀測快取命中量、延遲縮短幅度以及套用折扣後的實際成本。


 iThome鐵人賽
 看影片追技術