
上一篇把退貨政策包裝成 @tool,建立了標準 RAG 的固定管線:問題轉成 embedding、執行向量搜尋、取回 top-k 片段放進 context,再由模型生成回答。不管問題是否需要外部知識,也不管取回的文件能否支持答案,流程都只按相同順序執行一次。這種固定管線在面對真實客服情境時會遇到瓶頸。例如顧客提出包含多項需求的問題:
客製化保溫杯刻錯名字,可以換貨嗎?運費誰出?多久能收到新品?
這句話需要三種政策事實:客製化商品發生製作錯誤時能否換貨、瑕疵換貨的運費負擔,以及換貨後的配送時程。如果直接走標準 RAG:
Agentic RAG 的核心,就是在固定管線中加入由模型判斷的決策點:
這篇我們將沿用退換貨政策與 Chroma 索引,實作包含 Router、Decomposer、Grader 與 Synthesizer 的 Agentic RAG 工作流,解決上述複合客服提問。這四個節點的位置與檢索迴圈如下: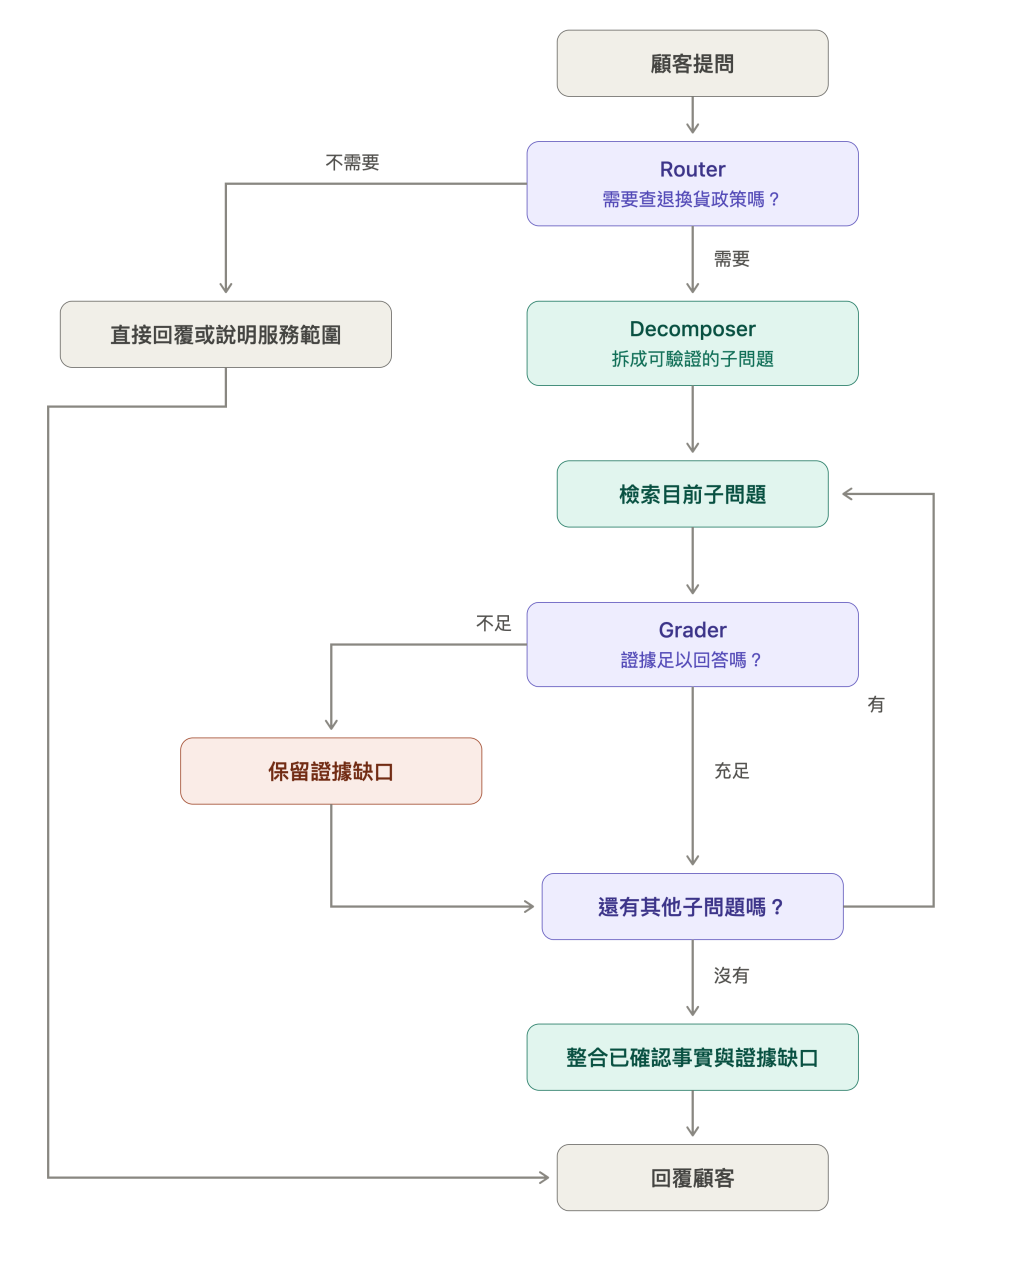
Router 是整條流程的第一個決策點。它把輸入分成兩條路徑:
retrieve,啟動 RAG。direct,不呼叫向量資料庫。class RouteResult(BaseModel):
route: Literal["direct", "retrieve"]
def route(self, question: str) -> Literal["direct", "retrieve"]:
prompt = """判斷顧客問題是否需要查詢商城退換貨政策。
打招呼、道謝或不屬於退換貨政策的問題輸出 direct;商品能否退換、瑕疵、
運費、申請方式或處理時程輸出 retrieve。"""
result = self.router.invoke(
[SystemMessage(content=prompt), HumanMessage(content=question)]
)
return cast(RouteResult, result).route
Router 控制的是要不要付出檢索成本。走 direct 時流程直接結束;只有 retrieve 才會進入問題拆解與證據搜尋。
向量檢索一次接收一個查詢字串。若直接搜尋完整原句,相似度最高的片段可能只涵蓋「客製化商品」或「瑕疵換貨」,無法保證運費與配送時程也會出現在前幾名。
Decomposer 先把問題拆成各自能由政策條款驗證的子問題:
q1:客製化商品發生製作錯誤時是否可以換貨?
q2:瑕疵商品換貨的來回運費由誰負擔?
q3:瑕疵商品申請換貨後需要幾個工作天收到新品?
拆解結果使用 Pydantic 限制為一至五題。
class DecompositionResult(BaseModel):
    questions: list[str] = Field(
        min_length=1,
        max_length=5,
        description="完整涵蓋原問題所需的獨立政策子問題",
    )


def decompose(self, question: str) -> list[str]:
    prompt = """把顧客問題拆成查政策時可以獨立驗證的子問題。
每個子問題只詢問一項政策事實,但要保留原問題中的商品條件與例外情形。
簡單問題只回傳一題;最多五題。不得新增顧客沒有詢問的需求。"""
    result = self.decomposer.invoke(
        [SystemMessage(content=prompt), HumanMessage(content=question)]
    )
    return cast(DecompositionResult, result).questions
這邊要記得在拆題時把原句的限定條件帶進子問題。第一題若只寫成「可以換貨嗎」,就少了「客製化」與「製作錯誤」,檢索會取回尺寸不合、個人喜好這類一般換貨規定,而不是客製化商品的例外條款。
三題會各自檢索一次,取回三組政策片段。如果把它們全放進同一個清單,Grader 評估第一題時就會看到第二題取回的運費規定,容易把它當成換貨資格的證據;評估結果也只會有一份,最後說不出是哪一題缺了證據。
SubQuestionState 讓每一題保存自己的證據與評估結果:
class SubQuestionState(TypedDict):
    id: str
    question: str
    documents: list[PolicyChunk]
    is_sufficient: bool | None
    missing_aspect: str | None


class AgenticRAGState(TypedDict):
    question: str
    route: Literal["direct", "retrieve"] | None
    sub_questions: list[SubQuestionState]
    current_index: int
    answer: str | None
    trace: list[str]
外層的 AgenticRAGState 記錄原始問題、Router 結果與目前處理到哪一題;內層的 SubQuestionState 記錄該題取回的政策片段及證據是否充足。
retrieve_current 只處理 current_index 指向的子問題,並把檢索結果寫回該題:
def retrieve_current(state: AgenticRAGState) -> StateUpdate:
    task = state["sub_questions"][state["current_index"]].copy()
    documents = services.retrieve(task["question"], top_k=4)
    task["documents"] = documents
    return {
        "sub_questions": _replace_current(state, task),
        "trace": [
            *state["trace"],
            f"retrieve:{task['id']}:{len(documents)}",
        ],
    }
第一題檢索並評估完後,advance 把 current_index 加一,流程回到 retrieve_current 處理第二題;三個子問題就跑三輪,全部處理完才進入 Synthesizer。一次只處理一題,軌跡就按題號依序展開,哪一題檢索不到或評估不過一眼就看得出來。
Grader 每次只評估一個子問題及其取回的證據:
class GradeResult(BaseModel):
    is_sufficient: bool = Field(description="現有證據是否足以回答這個子問題")
    missing_aspect: str | None = Field(
        default=None,
        description="證據不足時仍缺少的具體事實",
    )
提示詞禁止模型使用內部知識補足文件沒有提供的內容:
prompt = """判斷參考條款是否足以回答子問題。
只能使用參考條款,不能以模型原有知識補足。完整回答所需的每項事實都有條款
支持時,is_sufficient 才能是 true;否則寫出仍缺少的具體事實。"""
評估結果會產生兩種行為:
is_sufficient=True:完成目前子問題,前往下一題。is_sufficient=False:把該題標記為證據不足,繼續處理其他子問題。證據不足不會丟掉已完成的題目。假設政策能回答換貨資格與運費,卻沒有承諾新品送達天數,最後仍可回答前兩項,並清楚說明配送時程需要人工確認。
Synthesizer 收到的不是一包混在一起的文件,而是每個子問題、評估結果與對應政策片段:
q1:客製化商品發生製作錯誤時是否可以換貨?
├─ 評估:證據充足
└─ 證據:客製化商品規定、瑕疵品判定標準

q2:瑕疵商品換貨的來回運費由誰負擔?
├─ 評估:證據充足
└─ 證據:換貨規則與費用負擔

q3:換貨後需要幾個工作天收到新品?
├─ 評估:證據不足
└─ 缺少:換貨完成與新品配送時程
生成提示詞要求證據充足的項目引用政策片段 ID;證據不足的項目則說明缺少什麼,不能把退款時程或退貨取件時間誤當成新品配送時程:
prompt = """根據各子問題的評估與參考條款回答原始問題。
先給結論,再依顧客詢問的項目逐項回答。證據充足的項目要引用政策片段 ID;
證據不足的項目要明確說明目前無法確認及缺少的事實,並建議轉人工確認。
只回答原始問題詢問的項目,不主動補充其他條款;不得加入條款未提供的申請方式、
費用或日期。"""
標準 RAG 與 Agentic RAG 共用同一份退換貨政策及 Chroma 索引。先建立索引:
uv run rag-ingest
再執行 Agentic RAG:
uv sync
export ANTHROPIC_API_KEY="your-api-key"
uv run agentic-rag --show-trace \
  "客製化保溫杯刻錯名字,可以換貨嗎?運費誰出?多久能收到新品?"
這份政策可以確認刻字錯誤的換貨資格與運費,卻沒有承諾新品送達時間。實際執行會走出下面的軌跡:
router:retrieve
decompose:3
retrieve:q1:4
grade:q1:sufficient
advance:q2
retrieve:q2:4
grade:q2:sufficient
advance:q3
retrieve:q3:4
grade:q3:insufficient
unresolved:q3
synthesize
q1 與 q2 的證據充足,q3 則因為找不到新品配送時程而標記為 unresolved。最終回答會確認可以換貨、來回運費由商城負擔,並說明新品送達時間需要人工確認。
拆成三個子問題後,至少會增加三次檢索與三次 Grader 呼叫。它適合複合條件、例外條款多,而且漏答代價高的問題。
Decomposer 也可能拆出重複問題,或把原本相依的條件錯誤分開。實作時要限制子問題數量、保留原始條件,並在測試資料中加入單一問題、複合問題、重複子問題與無法回答的子問題。若要改成平行檢索,還要確保每個 worker 寫入不同的子問題狀態,再由彙整節點合併結果。
什麼時候不該用
Agentic RAG 會增加延遲與呼叫成本。Router、Decomposer 與 Grader 等決策點都可能多呼叫一次 LLM;子問題越多,檢索與評估次數也會跟著增加。如果大部分問題只是簡單的事實查詢,單次 retrieve-then-generate 就足以回答;讓每個請求都進入完整的 Agentic 迴圈,只會增加延遲,卻沒有帶來相應的答案品質。
實務上可以簡單問題走單次檢索與生成,只有需要整合多份證據的多跳問題,才進入包含拆解、檢索與驗證的完整 Agentic 迴圈。


 iThome鐵人賽
 看影片追技術