
當顧客詢問「已拆封的藍牙耳機可以退貨嗎?」時,最直覺的處理方式不是讓語言模型憑著記憶直接作答,而是讓系統在回答前先去「查詢」商城的退換貨規章。
這類退換貨政策屬於企業內部資料,隨時可能修訂,不同商品類別也有各自的限制。若直接讓模型自由回答,模型只能依賴訓練時讀過的公開資料憑空猜測,容易給出錯誤承諾;若每次發問都把整份數萬字的規章手冊直接塞進 Prompt,每一輪對話都會產生高昂的 Token 費用與延遲,且過多無關條款容易稀釋模型的注意力。
更有效的做法是在生成答案前,先由檢索流程從外部知識庫翻出與提問最相關的兩至三條具體條文,再交由模型組織出客服回覆。這就是 RAG(Retrieval-Augmented Generation,檢索增強生成) 架構。
整個處理架構如下圖所示: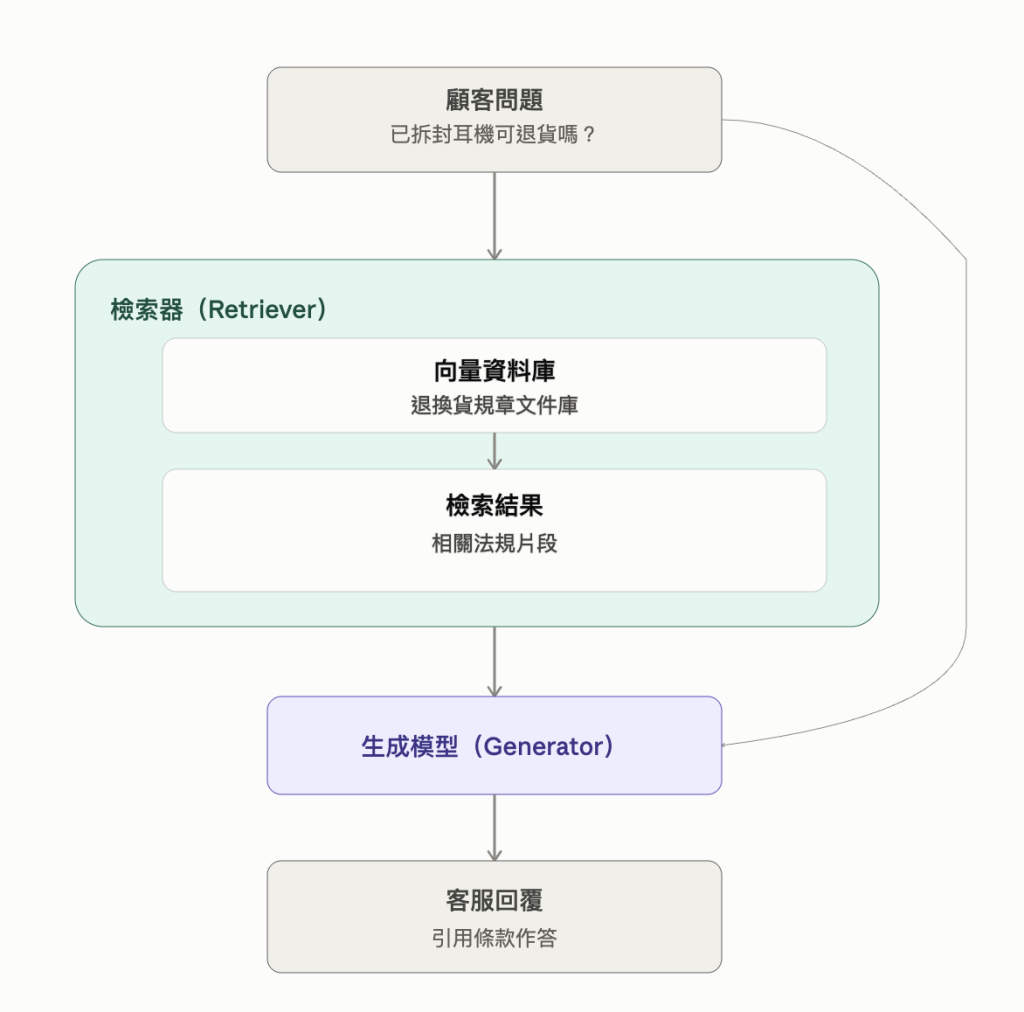
系統收到提問後,先由檢索器(Retriever)查詢相關條款片段,再連同原始問題一起交給生成模型組織回覆。
檢索器裡查詢的,是預先儲存在向量資料庫(Vector Database)中的外部知識。如果檢索只依賴傳統資料庫的關鍵字比對(如 SQL LIKE 或全文檢索),容易因為用詞差異而漏搜。例如顧客問的是「已拆封的藍牙耳機可以退貨嗎?」,但規章標題與內文寫的是「入耳式耳機、耳塞式耳機屬於個人衛生用品,經拆封恕不接受退換貨」。兩者沒有完全相同的關鍵字,但在語意上高度相關。
向量資料庫解決了這個限制。它不依賴完全相同的字詞,而是將文字轉換為代表語意的數值向量,藉由計算向量之間的距離找出意思最相近的條款。單篇規章、客服 FAQ 或產品手冊都適合這種方式。依部署環境不同,常見選擇包括:
這個範例使用 Chroma,讓讀者能直接在本機驗證完整資料流。接著,系統將運作流程拆成「事前建立索引」與「即時檢索與生成」兩個階段:
確定了儲存架構與運作時序後,首先理解系統如何將原始文件轉換為向量索引。
若要讓檢索器能精準找到答案,首先必須為企業規章建立向量索引。本文以一份電商的《商城退貨與售後服務政策》為例,完整條款收錄在範例程式 ai-agent-sample/rag-chroma-return-policy 的 data/商城退貨與售後服務政策.md。文件包含鑑賞期原則、特殊商品例外、瑕疵換貨、物流管道與退款時程等五個章節。
我們不能把整份文件直接轉成單一向量,否則耳機拆封、退款時程等具體細節會被稀釋,檢索時也無法精準挑出特定條文。因此在存入向量資料庫前,必須先將文件切成具備獨立主題的文字片段,這在 RAG 實務中稱為 Chunk。
當我們將規章切分為一個個獨立的 Chunk 後,Embedding 模型會將每個片段映射到多維空間中的幾何座標;語意越相近的內容,在空間中的距離越近。以下用二維位置簡化呈現條款在空間中的距離關係:
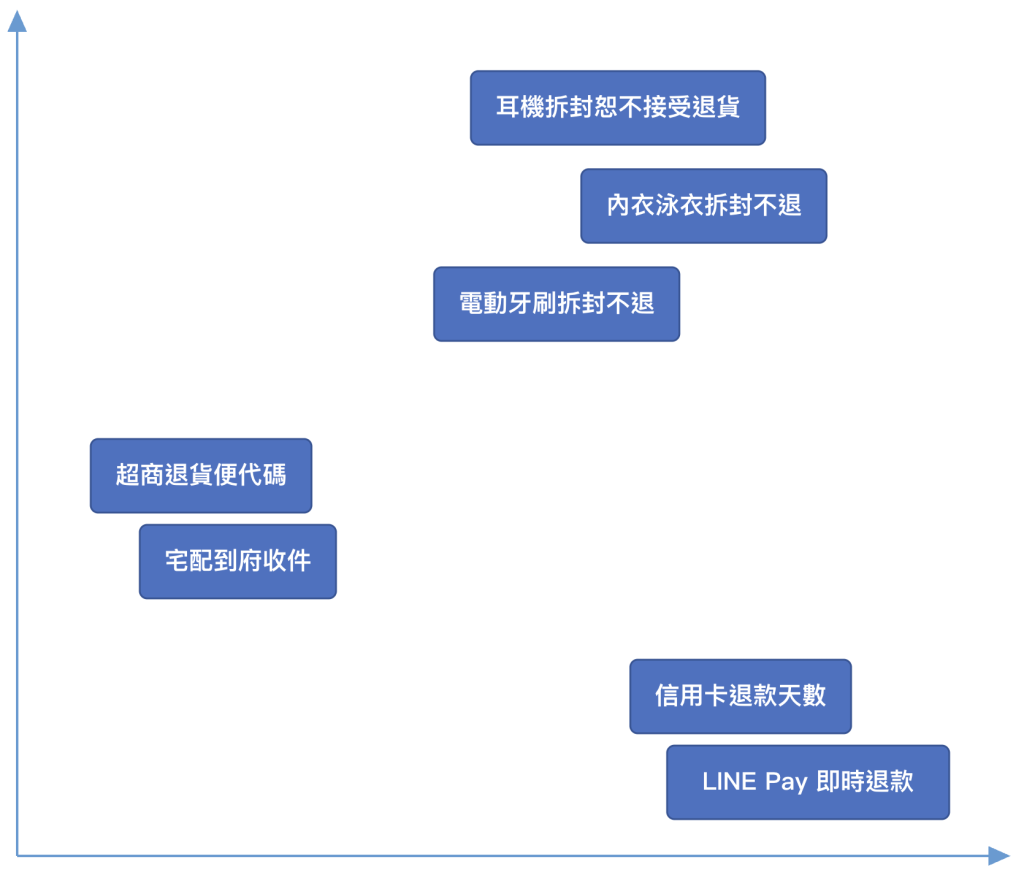
透過這張分佈圖,可以看出向量空間語意聚集的本質:
既然進入向量庫的最小單元是 Chunk,且目標是讓每個條款在向量空間中擁有清晰的語意座標,那麼要如何將整份連續的文件切成片段?在 RAG 實務中,常見的切塊策略分為固定長度切分與結構化切分兩種:
固定長度切分不考慮文件結構,機械式地每固定字數(如 300 或 500 個 Token)切成一塊。由於固定字數切割容易切在句子中間,實務上通常會設定 10% 至 20% 的重疊(Overlap),讓後面的片段能向前重複涵蓋前一個片段結尾的文字,避免語意在交界處硬生生中斷。
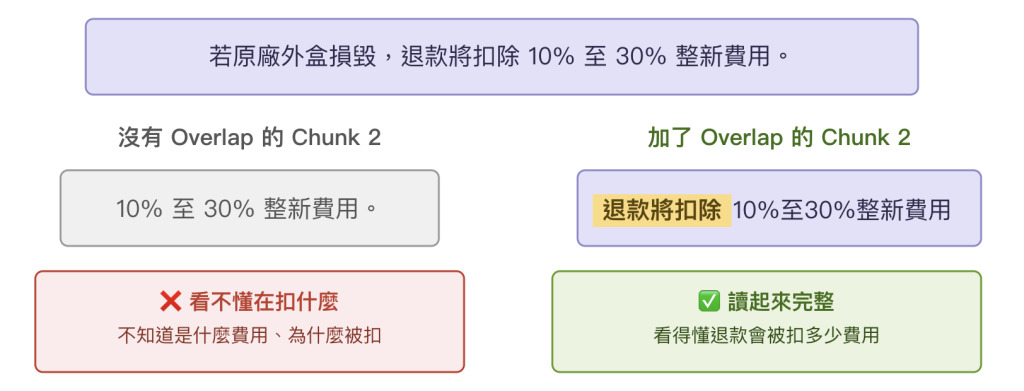
以商城規章第 1.3 節的「若原廠外盒損毀,退款將扣除 10% 至 30% 整新費用。」為例,有無 Overlap 會直接影響片段的可用性:
雖然 Overlap 能改善斷句問題,但固定長度切分本質上依然無法辨識文件結構:它既不知道這段話屬於「第一章 鑑賞期與一般退貨原則 > 1.3 退貨包裝要求」的前提脈絡,也容易將無關的條款硬塞在同一個片段中。對於規章、法規與說明手冊等結構嚴謹的文件,更合適的做法是採用結構化切分。
與其盲目算字數,更直覺的做法是依文件天然的格式標記(如 Markdown 的 ## 章節與 ### 條款)切分,讓每一條規定獨立成為一個 Chunk。
但直接按標題切分時,容易遇到一個問題:小節會遺失上層章節的前提條件。
例如「2.1 個人衛生與貼身用品」小節只列出耳機、內衣拆封不退,卻沒有包含父章節「第二章 不適用七日鑑賞期之特殊商品類別」的大標題。單獨把小節切出來時,文字裡甚至沒有出現「鑑賞期」這三個字。
因此切塊時,必須將章節路徑(Breadcrumbs)直接加在內文前面,組成完整的條款片段:
商城退貨與售後服務政策 > 第二章 不適用七日鑑賞期之特殊商品類別 > 2.1 個人衛生與貼身用品
基於衛生安全考量,以下商品經拆封後恕不接受退貨:
- 內衣褲、泳衣、襪子。
- 入耳式耳機、耳塞式耳機、耳罩式耳機。
把標題路徑與條款內文合在一起送去計算向量,Embedding 模型就能同時掌握「這是哪份政策」、「屬於什麼大類」與「具體有哪些商品」,大幅提升檢索的精準度。
理解了切塊策略與向量空間的映射原理後,接下來動手實作切塊並寫入 Chroma。
範例專案 ai-agent-sample/rag-chroma-return-policy 的資料夾結構如下:
rag-chroma-return-policy/
├── data/
│   └── 商城退貨與售後服務政策.md
├── src/
│   └── rag_chroma_return_policy/
│       ├── ingest.py    # 讀取 Markdown、切塊並建立 Chroma 向量庫
│       ├── tool.py      # 封裝 Chroma 查詢為客服檢索 Tool
│       └── demo.py      # 整合 Prompt 與模型生成附引用的回答
└── pyproject.toml
data/商城退貨與售後服務政策.md 是尚未切分與向量化的原始政策語料,共有五大章節與十五個具體條款:
在 src/rag_chroma_return_policy/ingest.py 中,切塊函式實作了層級走訪與標題繼承邏輯:
from pathlib import Path

def chunk_policy_markdown(file_path: Path) -> list[dict]:
    content = file_path.read_text(encoding="utf-8")
    lines = content.splitlines()

    chunks = []
    chapter = "一般條款"
    section = ""
    buffer: list[str] = []

    def flush(fallback: str) -> None:
        nonlocal buffer
        body = "\n".join(buffer).strip()
        if body:
            if section:
                title = f"{chapter} > {section}"
            elif fallback:
                title = f"{chapter} > {fallback}"
            else:
                title = chapter
            chunks.append({
                "chapter": chapter,
                "section": section or fallback,
                "title": title,
                "text": body,
            })
        buffer = []

    for line in lines:
        if line.startswith("## "):
            flush("概述")
            chapter = line.removeprefix("## ").strip()
            section = ""
            continue
        if line.startswith("### "):
            flush("")
            section = line.removeprefix("### ").strip()
            continue
        buffer.append(line)

    flush("")
    return chunks
chunk_policy_markdown 循序走訪行內容:遇到 ## 時更新當前章節名稱並將章節引言切成概述;遇到 ### 時則更新小節名稱並切出條款片段。每個片段的 title 會自動組合「章節 > 小節」的路徑。整份文件共切出 15 個片段。
切出 Chunk 後,接著在同一個檔案中建立 Chroma collection,並指定 paraphrase-multilingual-MiniLM-L12-v2 作為 Embedding 模型。這個模型支援中文查詢與中文條款之間的語意比對:
# 將向量資料持久化儲存在 data/chroma
client = chromadb.PersistentClient(path="data/chroma")

# 指定負責把中文問題與條款轉成向量的 Embedding 模型
emb_fn = embedding_functions.SentenceTransformerEmbeddingFunction(
    model_name="paraphrase-multilingual-MiniLM-L12-v2"
)

# collection 會使用同一個模型處理寫入資料與後續查詢
collection = client.create_collection(
    name="return_policy",
    embedding_function=emb_fn,
)
寫入 collection 的每個 Chunk 包含三組資料:documents 是計算向量的文字,metadatas 是引用來源,ids 則是 Chroma 用來識別資料的唯一值:
# 在條款內文前加上文件名稱與標題,一起送去計算向量
documents = [
    f"商城退貨與售後服務政策 > {c['title']}\n{c['text']}"
    for c in chunks
]

# 保留引用來源;metadata 不會送進 Embedding 模型
metadatas = [
    {
        "doc_title": "商城退貨與售後服務政策",
        "title": c["title"],
        "version": "2026-03-01",
    }
    for c in chunks
]

# 為每個 Chunk 產生 Chroma collection 內的唯一 ID
ids = [f"pol-{i+1:02d}" for i in range(len(chunks))]

# Chroma 計算 documents 的向量,再連同原文與 metadata 一起寫入
collection.add(ids=ids, documents=documents, metadatas=metadatas)
collection.add() 會把 documents 交給指定的 Embedding 模型計算向量,再將向量、原文、metadata 與 ID 一起寫入 Chroma。
到這裡,src/rag_chroma_return_policy/ingest.py 的程式碼就已全部完成。這是一個獨立執行的離線前置腳本,目的不是回答顧客問題,而是先把規章切塊並將向量持久化寫入磁碟。
先在終端機執行這個腳本,建立本機的 Chroma 向量庫:
$ uv run python -m rag_chroma_return_policy.ingest
成功寫入 15 筆政策條款至向量庫:data/chroma
執行完成後,磁碟目錄 data/chroma/ 中就有了現成的向量資料。以第 2.1 節為例,這個 Chunk 寫入 Chroma 後包含以下資料:
ID
pol-04

document(送進 Embedding 模型計算向量)
商城退貨與售後服務政策 > 第二章 不適用七日鑑賞期:個人衛生與貼身用品(2.1)
依據《通訊交易解除權合理例外情事適用準則》,基於衛生安全考量……

metadata(檢索時隨原文一起取回)
doc_title: 商城退貨與售後服務政策
title: 第二章 不適用七日鑑賞期:個人衛生與貼身用品(2.1)
version: 2026-03-01
向量搜尋使用 document 判斷這個 Chunk 是否與顧客問題相關。找到這個 Chunk 後,程式再使用 metadata 顯示文件名稱、條款名稱與版本,讓模型能在回答中標示引用來源。ID 只用來識別 Chroma 中的這筆資料。
建立好離線向量庫後,接下來進入即時服務階段,撰寫查詢這個向量庫的客服 Tool。
收到顧客提問時,系統呼叫 Chroma 的 collection.query() 進行向量搜尋。檢索時,顧客查詢的問題必須先經由與建立索引時相同的 Embedding 模型轉換為向量,投射到同一個語意空間中,藉由幾何距離比對出與問題最靠近的條款:
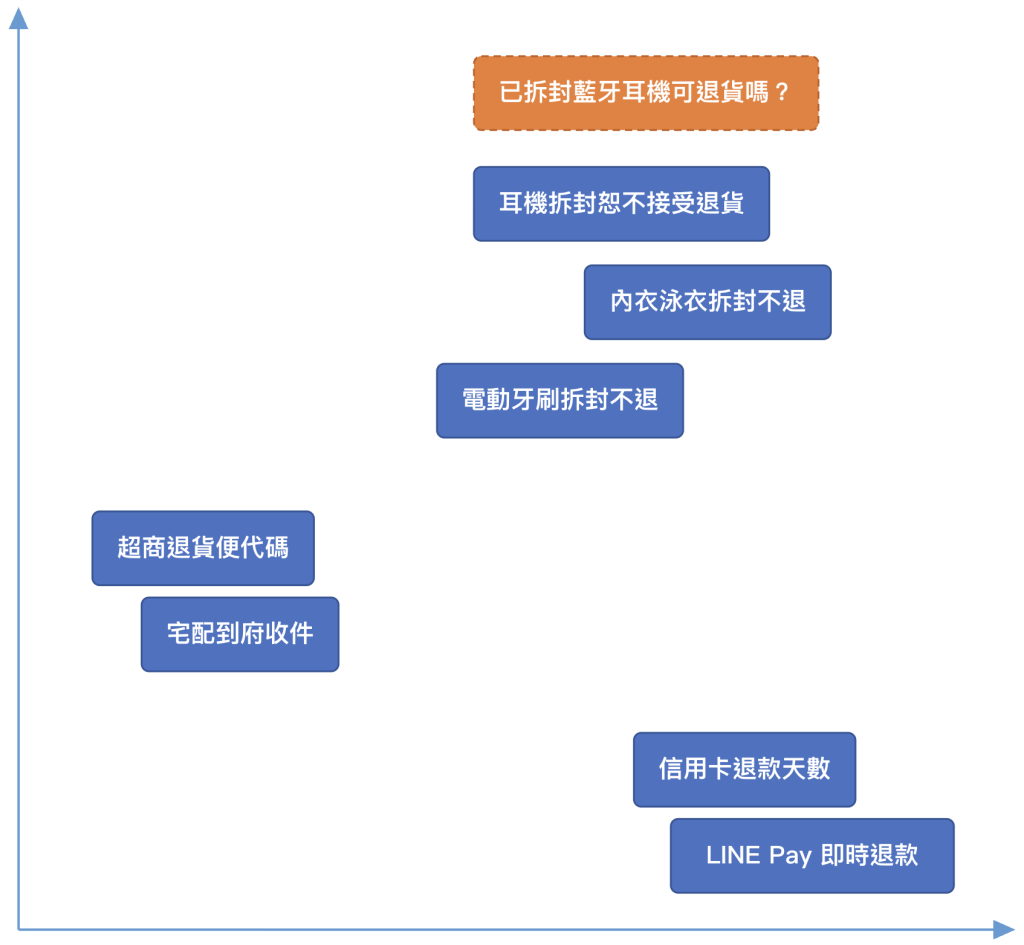
如上圖所示,向量檢索比對的過程如下:
top_k 排序時被自然排除在外。在 src/rag_chroma_return_policy/tool.py 中,載入建立索引時寫入的 return_policy collection,並指定相同的 Embedding 模型:
from pathlib import Path
import chromadb
from chromadb.utils import embedding_functions
from langchain_core.tools import tool

# 指向 ingest.py 建立的持久化向量庫
CHROMA_DIR = Path("data/chroma")

def get_collection() -> chromadb.Collection:
    # 開啟磁碟上既有的 Chroma 資料
    client = chromadb.PersistentClient(path=str(CHROMA_DIR))

    # 查詢時沿用建立索引時使用的 Embedding 模型
    emb_fn = embedding_functions.SentenceTransformerEmbeddingFunction(
        model_name="paraphrase-multilingual-MiniLM-L12-v2"
    )

    # 載入已寫入 15 個政策 Chunk 的 collection
    return client.get_collection(name="return_policy", embedding_function=emb_fn)
取得 collection 後,query_return_policy() 將顧客問題交給 Chroma。Chroma 先計算問題向量,再取回距離最近的 top_k 個 Chunk。函式最後把每個 Chunk 的來源資訊與內文組成可交給語言模型閱讀的文字:
# 將函式註冊成可供 Agent 呼叫的 Tool
@tool
def query_return_policy(question: str, top_k: int = 2) -> str:
    """查詢電商商城的退換貨政策、鑑賞期例外規則、瑕疵換貨與退款時程。"""
    collection = get_collection()

    # 取回語意最接近問題的 top_k 筆原文與來源資訊
    results = collection.query(
        query_texts=[question],
        n_results=top_k,
        include=["documents", "metadatas"],
    )

    # collection 沒有任何可用資料時,不交給模型自行猜測
    if not results["documents"] or not results["documents"][0]:
        return "查無相關政策規章。"

    # Chroma 支援批次查詢;這裡只有一個問題,因此取索引 0
    docs = results["documents"][0]
    metas = results["metadatas"][0]

    # 將每筆條款整理成帶有引用編號、文件名稱與版本的文字
    formatted_chunks = []
    for i in range(len(docs)):
        meta = metas[i]
        doc_text = docs[i]
        item = f"[{i+1}] 《{meta['doc_title']}》{meta['title']}(版本:{meta['version']})\n{doc_text}"
        formatted_chunks.append(item)

    # 用空白行隔開不同 Chunk,避免條款內容混在一起
    return "\n\n".join(formatted_chunks)
測試單獨執行檢索:
$ uv run python -m rag_chroma_return_policy.demo "已拆封的藍牙耳機可以退貨嗎?" --retrieval-only
顧客提問:已拆封的藍牙耳機可以退貨嗎?

【檢索到的條款片段】:
[1] 《商城退貨與售後服務政策》第一章 鑑賞期與一般退貨原則 > 1.3 退貨包裝要求(版本:2026-03-01)
商城退貨與售後服務政策 > 第一章 鑑賞期與一般退貨原則 > 1.3 退貨包裝要求
退貨時請以原寄送紙箱包裝完整。若原紙箱已遺失,請使用其他完整紙箱包裝,切勿直接在商品原廠外盒上黏貼宅配單、膠帶或書寫文字。若原廠外盒損毀或商品有使用痕跡,本商城將依損壞程度自退款中扣除 10% 至 30% 之整新整修費用。

[2] 《商城退貨與售後服務政策》第二章 不適用七日鑑賞期之特殊商品類別 > 2.1 個人衛生與貼身用品(版本:2026-03-01)
商城退貨與售後服務政策 > 第二章 不適用七日鑑賞期之特殊商品類別 > 2.1 個人衛生與貼身用品
基於衛生安全考量,以下商品經拆封(包含封口貼紙撕毀、封膜破壞)後恕不接受退貨:
- 內衣褲、泳衣、襪子、塑身衣。
- 入耳式耳機、耳塞式耳機、耳罩式耳機。
- 電動牙刷、刮鬍刀、美容儀、體脂計。
- 寢具(床包、枕套、被套)、毛巾、浴巾。
從執行結果可以看到,真正包含解答的「2.1 個人衛生與貼身用品」排在第二名 [2],第一名 [1] 則是同樣包含「退貨」與「原廠外盒損毀」詞彙的「1.3 退貨包裝要求」。
向量檢索只比對主題語意距離,無法判斷哪一段條款才具備解答的充分條件。因此實務上必須設定 top_k > 1(此處取 2 筆)取回候選條款,再交由後續的語言模型篩選依據;若設定 top_k=1,系統就會因為遺漏關鍵條款而答錯。
這也是提供 --retrieval-only 的原因:排查 RAG 錯誤時,先確認正確條款是否落在 top_k 候選集內;若檢索階段未命中,調整後續 Prompt 或模型也無法解決問題。
顧客送出問題後,Chroma 先取回相關條款,再由語言模型根據問題與條款生成客服回覆:
在 src/rag_chroma_return_policy/demo.py 中,將檢索到的條款與顧客問題組裝進 Prompt,並設定嚴格的依據生成規則:
from langchain_anthropic import ChatAnthropic
from langchain_core.messages import HumanMessage, SystemMessage
from rag_chroma_return_policy.tool import query_return_policy

SYSTEM_PROMPT = """你是一名專業的電商客服助理。請嚴格根據提供的【參考條款】回答顧客的退換貨問題。

規則:
1. 僅能根據提供的參考條款事實回答,不得捏造或使用條款以外的常識補充。
2. 回答時必須明確引用依據條款編號,例如 [1]、[2]。
3. 若參考條款中未包含回答問題所需的資訊,請明確說明「目前規章未包含相關資訊,請聯繫人工客服」,不可自行推測。
4. 態度親切客氣,先給出明確結論(可退/不可退/退貨步驟),再列出詳細說明與條件。"""

def ask_agent(question: str, top_k: int = 2) -> None:
    # 1. 檢索相關條款
    context_text = query_return_policy.invoke({"question": question, "top_k": top_k})

    # 2. 交由模型生成回答
    model = ChatAnthropic(model="claude-3-5-haiku-latest")
    response = model.invoke([
        SystemMessage(content=SYSTEM_PROMPT),
        HumanMessage(
            content=f"【參考條款】:\n{context_text}\n\n【顧客問題】:{question}"
        ),
    ])

    print(f"顧客提問:{question}\n")
    print("客服回覆:")
    print(response.content)
到這裡,系統完成了標準 RAG 的核心管線:預先將政策語料切為帶階層標題的 Chunk 存入向量庫,在每次提問時依語意距離取回候選片段,再由語言模型依據檢索內容組織出附帶條款引用的客服回覆。
這套固定管線能解決資料即時性與模型憑空猜測的問題,但在實際客服場景中仍有三項明顯限制:
為了解決固定管線的限制,下一步是在流程中加入決策能力——由模型作為 Agent 自行判斷何時檢索、將複合問題拆解為多個獨立查詢,並在生成前驗證取回的證據是否充分


 iThome鐵人賽
 看影片追技術