
向量 RAG 依賴問題與文字片段之間的語意相似度。當推導答案需要跨越多份文件,且中繼段落與問題用詞沒有交集時,向量檢索往往會遺漏關鍵事實,導致模型無法得出結論。
例如在電商商城客服中,顧客詢問:
「音波極淨電動牙刷-Pro8 拆封後可以退貨嗎?」
答案需要拼起兩個事實:「這款牙刷屬於衛生用品」與「衛生用品拆封不能退」。但這兩個事實分別記錄在不同文件、用詞完全不重疊的兩個 Chunk 裡:
範例使用三份 Markdown 文件,完整程式放在 graphrag-return-policy
data/docs/
├── 01-商城退貨與售後服務政策.md
├── 02-商品規格與品類目錄.md
└── 03-一般退貨常見問題.md
先用一般的向量 RAG 檢索這三份文件:
$ uv run gr-baseline "音波極淨電動牙刷-Pro8 拆封後可以退貨嗎?"
檢索結果(top_k=2):
  [1] 距離 0.281 | 01-商城退貨政策 § 2.1 個人衛生與貼身用品 (✅ 找到 Chunk B)
  [2] 距離 0.435 | 01-商城退貨政策 § 1.1 七日鑑賞期規範   (❌ 無關的一般條款)
  (⚠️ Chunk A 商品規格目錄相似度過低,完全沒被撈到!)
問題和 Chunk B 用詞高度重疊,相似度自然高;Chunk A 記錄的是硬體規格,與問題中的「退貨」沒有用詞交集,因相似度過低而被過濾掉。
最後送進模型的只有 Chunk B。模型知道「衛生用品不能退」,但手上完全沒有「這款牙刷到底算不算衛生用品」的事實依據,只能含糊回答或憑空猜測。
這反映了向量檢索的局限:它只能拿使用者的問題,個別比對單一片段的文字相似度。但真實問題往往需要串接多個事實——先從「商品」對應到「品類」,再從「品類」對應到「規定」。只要中間銜接的事實(Chunk A:牙刷屬於個人衛生用品)沒有包含問題裡的關鍵字(退貨、拆封),向量檢索就會漏掉它,導致推導過程缺少關鍵的中繼證據。
核心想法:把「商品種類」這種原本只是商品身上一個屬性欄位的東西,升格成一個獨立節點,讓不同來源的文件可以透過同一個節點接軌。
如果品類只是商品 JSON 裡的一個字串屬性:
{ "商品名稱": "音波極淨電動牙刷-Pro8", "所屬品類": "個人衛生與貼身用品" }
那「商品」和「退貨政策」在圖上依然是兩座孤島,什麼演算法都跨不過去。所以改成:
個人衛生與貼身用品(獨立於商品之外的實體)(音波極淨電動牙刷-Pro8) ──[BELONGS_TO_CATEGORY]──▶ (個人衛生與貼身用品)
這樣一來,未來不管加幾款商品(牙刷、刮鬍刀、貼身衣物),都只要新增一條指向這個節點的 BELONGS_TO_CATEGORY 關係,就能透過它連到退貨政策。
圖資料庫無法直接解析長篇自然語言文章。要建立圖譜,必須先讓模型將每篇 Markdown 文章拆解為結構化的「實體(節點)」與「關係(連線)」。
為了避免模型自行發明隨意名稱(例如把分類關係寫成 IS_A 或 KIND_OF),程式在 schema.py 中預先規範允許的實體與關係型別:
Product(商品)、Category(品類)、Policy(退換貨規定)。BELONGS_TO_CATEGORY(商品屬於品類)、SUBJECT_TO_POLICY(品類適用規定)。執行抽取指令:
$ uv run gr-extract
01-商城退貨與售後服務政策:實體 2 個、關係 1 條
    個人衛生與貼身用品 -[SUBJECT_TO_POLICY]-> 排除七日鑑賞期
02-商品規格與品類目錄:實體 3 個、關係 2 條
    音波極淨電動牙刷-Pro8 -[BELONGS_TO_CATEGORY]-> 個人衛生與貼身用品
    雙刀頭水洗刮鬍刀-S3 -[BELONGS_TO_CATEGORY]-> 個人衛生與貼身用品
...
合計:實體 5 個、關係 3 條 → data/extracted.json
抽取程式(extract.py)會逐一讀取各篇文件,每次獨立呼叫模型抽取該篇的事實,並將所有抽取結果儲存為中繼檔 data/extracted.json。
將抽取結果存為檔案有兩個目的:
evidence)是否完全忠於原文。產出的 data/extracted.json 包含圖譜的兩大核心要素:節點清單(entities) 與 連線清單(relations):
entities(點):列出這張圖上有哪些名詞節點及其型別(商品 Product、品類 Category、規定 Policy)。relations(線):描述節點之間的箭頭。每條關係的 subject(起點)與 object(終點),就是直接對應到 entities 裡的實體 name。{
"entities": [
// 來自【01-商城退貨與售後服務政策.md】
{ "name": "個人衛生與貼身用品", "type": "Category", "doc_id": "01" },
{ "name": "排除七日鑑賞期", "type": "Policy", "doc_id": "01" },
// 來自【02-商品規格與品類目錄.md】
{ "name": "音波極淨電動牙刷-Pro8", "type": "Product", "doc_id": "02" },
{ "name": "個人衛生與貼身用品", "type": "Category", "doc_id": "02" }
],
"relations": [
// 來自【01-商城退貨與售後服務政策.md】
{
"subject": "個人衛生與貼身用品",
"predicate": "SUBJECT_TO_POLICY",
"object": "排除七日鑑賞期",
"evidence": "個人衛生與貼身用品一旦售出並拆封...排除七日鑑賞期",
"doc_id": "01"
},
// 來自【02-商品規格與品類目錄.md】
{
"subject": "音波極淨電動牙刷-Pro8",
"predicate": "BELONGS_TO_CATEGORY",
"object": "個人衛生與貼身用品",
"evidence": "所屬品類:個人衛生與貼身用品",
"doc_id": "02"
}
]
}
這兩組清單的對應關係如下:
relations 裡的第二條紀錄,以 音波極淨電動牙刷-Pro8 為起點(subject)、個人衛生與貼身用品 為終點(object),在兩顆節點之間拉出 BELONGS_TO_CATEGORY 箭頭。個人衛生與貼身用品 為起點、排除七日鑑賞期 為終點,拉出 SUBJECT_TO_POLICY 箭頭,並將來源條文存為 evidence。注意此時的資料狀態:每份文件是各自獨立抽取的。在 data/extracted.json 裡,個人衛生與貼身用品 分別出現在兩份文件的抽取清單中,兩條關係也只是文字檔裡的兩筆記錄,彼此還沒有接軌,也還不是連通的圖。
在上一步,我們已經把各篇文件中的實體與關係抽取出來,存成中繼檔 data/extracted.json。接下來要將這些零散的事實匯入圖資料庫,讓不同文件透過相同的節點接成一張連通的圖。
Neo4j 是目前最主流的圖資料庫(Graph Database) 之一。與傳統關聯式資料庫(以資料表、欄位與列儲存)不同,Neo4j 是直接以「節點(Node)」與「關係(Relationship)」來儲存與索引資料。
之所以需要圖資料庫,而不是直接在 JSON 檔裡搜尋或用傳統 SQL,主要有兩個原因:
JOIN,而且難以處理不固定長度的路徑;Neo4j 在內部直接以指標儲存實體間的關係,系統可以毫秒級地順著箭頭一路走訪兩段、三段甚至更長的路徑。專案根目錄已加上 docker-compose.yml,使用 Docker 啟動本機的 Neo4j 容器:
docker compose up -d
容器啟動後,Neo4j 提供了內建的 Web 視覺化管理介面(Neo4j Browser):
http://localhost:7474
neo4j
graphrag-demo
在瀏覽器打開這個 URL 並登入後,就能看見 Neo4j Browser。後續寫入資料後,可以在這個介面中輸入查詢語法,直接檢視圖譜上的圓圈節點與連線箭頭。
圖資料庫使用的操作語言稱為 Cypher(相當於圖資料庫的 SQL)。在 Cypher 中:
CREATE 代表「強制新建」:如果已經有同名節點,會重複建出兩顆獨立的節點。MERGE 則代表**「存在就沿用,不存在才新建」**(類似關聯式資料庫的 UPSERT 去重寫入)。這正是跨文件資料能夠自動接軌的核心機制。執行寫入指令:
uv run gr-load
終端機輸出:
$ uv run gr-load
抽取結果:實體 5 個、關係 3 條
寫入 Neo4j:4 個節點、3 條關係
再回到neo4j,可以看到這樣的結果。
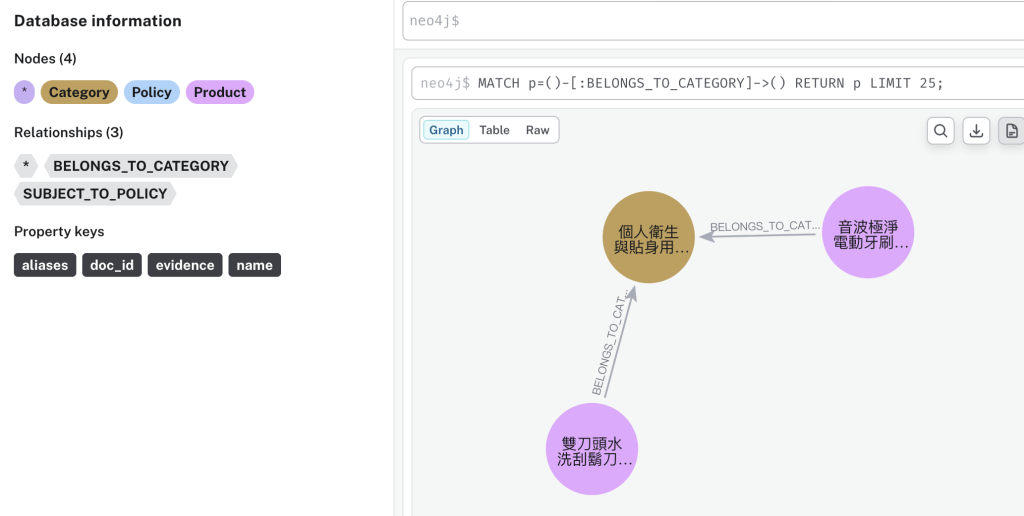
注意數字的變化:原本從兩份文件總共抽出了 5 個實體物件,但寫入 Neo4j 後只有 4 個節點。這是因為寫入程式(graph.py)分成了兩步執行:
1. 先寫入節點(Node MERGE)
程式逐一走訪 entities 清單,用 MERGE 寫入節點:
session.run(
    f"MERGE (n:{label} {{name: $name}}) SET n.aliases = $aliases",
    name=entity.name,
    aliases=entity.aliases,
)
當程式處理到兩份文件的節點時:
個人衛生與貼身用品 ➔ 資料庫裡尚未存在,建立新節點。個人衛生與貼身用品 ➔ 資料庫裡已經有了同名節點,直接沿用既有節點,不重複建立。兩份文件獨立抽出的同名實體,在資料庫中自動合而為一。
2. 再寫入連線(Edge MERGE)
節點建立完成後,程式走訪 relations 清單,找到兩端的節點拉出關係箭頭:
session.run(
    f"MATCH (s {{name: $subject}}), (o {{name: $object}}) "
    f"MERGE (s)-[r:{predicate} {{doc_id: $doc_id}}]->(o) "
    f"SET r.evidence = $evidence",
    subject=relation.subject,
    object=relation.object,
    doc_id=relation.doc_id,
    evidence=relation.evidence,
)
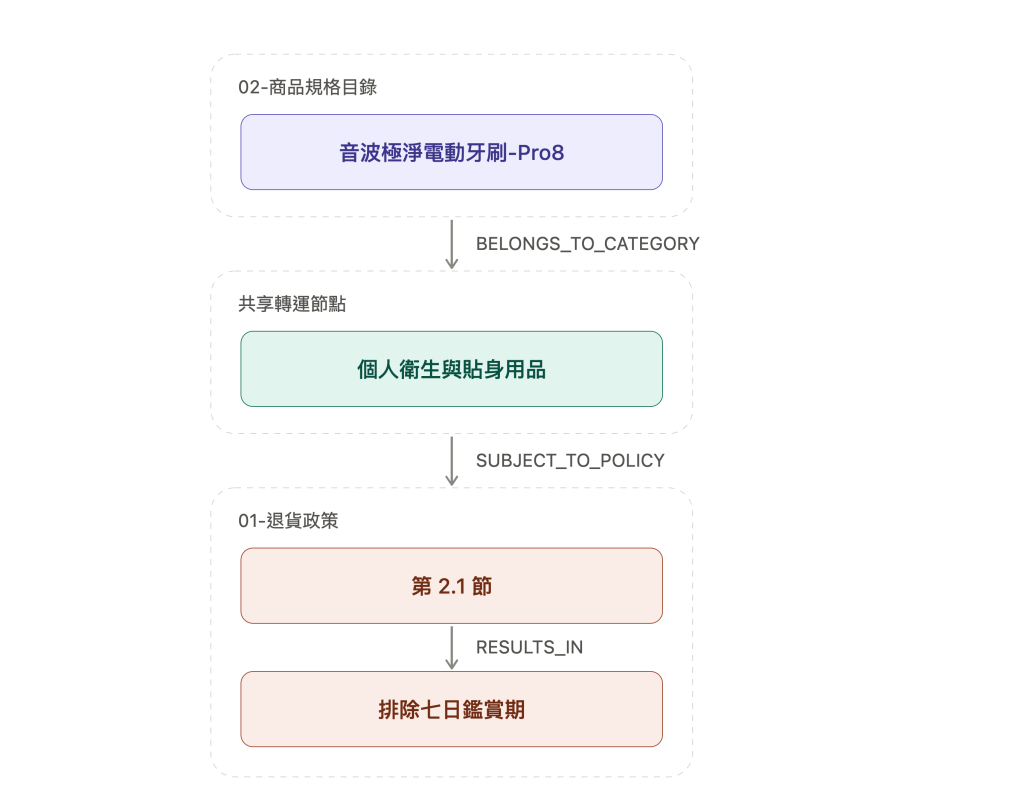
(音波極淨電動牙刷-Pro8) ──[BELONGS_TO_CATEGORY]──▶ (個人衛生與貼身用品)
(個人衛生與貼身用品) ──[SUBJECT_TO_POLICY]──▶ (排除七日鑑賞期)
3. 跨文件接軌完成
兩份原本毫無關聯的文件,在圖資料庫裡因為指到了同一顆共享節點(個人衛生與貼身用品),自動接通成一條跨文件的完整因果鏈:
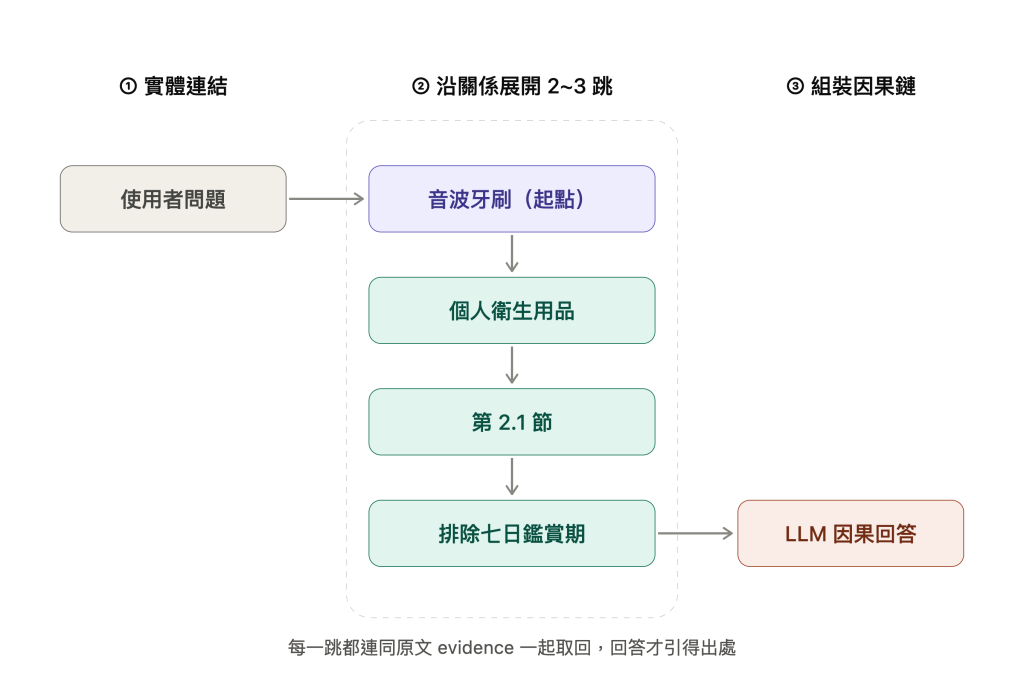
有了圖,查詢時系統要做兩件事:先找起點,再沿線走。
要把「音波極淨電動牙刷-Pro8」對應到圖裡的同名節點,直覺的做法是把圖上所有節點名稱都抓到 Python 裡,逐一檢查有沒有整段或拆字後的片段出現在問題裡。這個做法在商品只有幾筆的示範資料裡看不出問題,但節點一多就會卡:Product、Category、Policy 各查一次資料庫、把該類型底下所有節點名稱整批搬回來,再用迴圈對問題文字逐一比對——資料庫查詢次數跟節點類型數成正比,比對次數則跟節點總數成正比,節點上萬筆時,每問一次都要重新掃過所有名稱。
改成交給 Neo4j 的全文索引(Full-text Index)處理。在 graph.py 的 reset() 裡,對 Product、Category、Policy 三種節點的 name 建一個全文索引,並指定 cjk analyzer:
labels = "|".join(ENTITY_TYPES)
session.run(
    f"CREATE FULLTEXT INDEX {FULLTEXT_INDEX_NAME} IF NOT EXISTS "
    f"FOR (n:{labels}) ON EACH [n.name] "
    "OPTIONS { indexConfig: { `fulltext.analyzer`: 'cjk' } }"
)
cjk analyzer 建索引時,會把每個中文名稱拆成重疊的兩字詞元(bigram),例如「音波極淨電動牙刷」會拆成「音波」「波極」「極淨」「淨電」……每個詞元都指向這個節點。查詢時只要問題裡出現任兩個連續字命中其中一個詞元,索引就能直接定位到節點,不必逐一比對每個節點的完整名稱:
def search_entities(driver: Driver, text: str, *, limit: int = 5) -> list[tuple[str, str]]:
    with driver.session() as session:
        records = session.run(
            f"CALL db.index.fulltext.queryNodes('{FULLTEXT_INDEX_NAME}', $text) "
            "YIELD node, score "
            "RETURN node.name AS name, labels(node)[0] AS label, score "
            "ORDER BY score DESC LIMIT $limit",
            text=_escape_lucene(text),
            limit=limit,
        ).data()
    return [(record["name"], record["label"]) for record in records]
answer.py 的 find_start_entities 改成呼叫這個查詢,取回的候選裡優先挑 Product 型別,並濾掉被其他候選整段包住的較短名稱:
def find_start_entities(driver: Driver, question: str, *, limit: int = 5) -> list[str]:
    hits = graph.search_entities(driver, question, limit=limit)
    priority_hits = [name for name, label in hits if label == "Product"]
    names = priority_hits or [name for name, _label in hits]
    names.sort(key=len, reverse=True)
    return [
        name
        for name in names
        if not any(other != name and name in other for other in names)
    ]
從起點 音波極淨電動牙刷-Pro8 出發,先沿 BELONGS_TO_CATEGORY 走到 個人衛生與貼身用品,再沿 SUBJECT_TO_POLICY 走到 排除七日鑑賞期——這道問題的答案要靠這兩條關係接起來才完整。如果查詢只抓起點的直接鄰居,會停在 個人衛生與貼身用品 就停下來,抓不到最後的 排除七日鑑賞期;所以查詢要沿關係箭頭連續往外走兩段,才能把兩份文件裡的事實串在一起。
在 graph.py 中,使用 Cypher 查詢從起點實體往外展開,最多經過兩段關係:
TRAVERSE_QUERY = """
MATCH path = (start:Entity {name: $start_name})-[*1..2]-(connected)
UNWIND relationships(path) AS r
WITH DISTINCT r
RETURN startNode(r).name AS source, type(r) AS rel_type,
       r.description AS description, endNode(r).name AS target,
       r.evidence AS evidence, r.doc_id AS doc_id
"""
執行多跳檢索問答:
uv run gr-ask "音波極淨電動牙刷-Pro8 拆封後可以退貨嗎?"
終端機輸出:
$ uv run gr-ask "音波極淨電動牙刷-Pro8 拆封後可以退貨嗎?"
起點實體:音波極淨電動牙刷-Pro8
取回關聯路徑:2 條
[1] 音波極淨電動牙刷-Pro8 -[BELONGS_TO_CATEGORY]-> 個人衛生與貼身用品
[2] 個人衛生與貼身用品 -[SUBJECT_TO_POLICY]-> 排除七日鑑賞期

客服回覆:
依據商品規格,「音波極淨電動牙刷-Pro8」屬於「個人衛生與貼身用品」[1]。
根據退貨政策第 2.1 節,個人衛生與貼身用品一旦拆封,除原廠瑕疵外,
依法排除七日鑑賞期,恕無法受理退貨[2]。
系統把展開得到的關係鏈連同原文證據組進 Prompt,模型拿到的不再是零散關鍵字,而是一條結構完整的跨文件因果鏈。
在前面的範例中,GraphRAG 成功補齊了跨文件的因果關係,解決了向量檢索遺漏中繼資訊的問題。但這並不代表所有查詢都該送進圖資料庫。
建立與維護圖譜需要抽取實體、維護結構約束,每次多跳走訪也有額外的延遲與查詢成本。如果問題本身很單純,或者需要精確的數值計算,硬走 GraphRAG 反而浪費資源。
因此在實際的 Agent 架構中,通常會由 Router 依據問題性質進行分流:
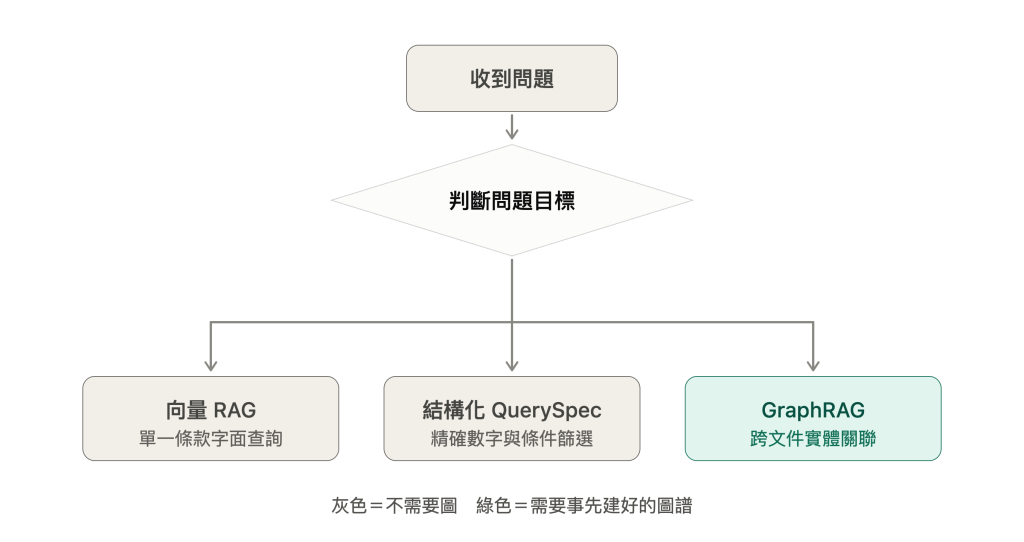
分流時的核心原則是:用成本最低、且能精確命中事實的機制解決問題。常見的三種情境如下:


 iThome鐵人賽
 看影片追技術