
RDS(Relational Database Service)是受管的關聯式資料庫服務,底層還是 MySQL、PostgreSQL、MariaDB、Oracle、SQL Server 或 AWS 自家的 Aurora。差別在管理方式:如果自己在 EC2 上裝一顆資料庫,會有作業系統的 SSH,要自己升版本、裝套件、擴充硬碟;RDS 把這些操作都收走,交給 AWS 處理。
只有一台 RDS instance 在跑,會有兩個常見的風險:
RDS 用兩個功能分別解決這兩個風險,名字很像,解決的卻是不同問題:Multi-AZ 解決「機器掛了怎麼辦」,Read Replica 解決「查詢量太大怎麼辦」。搞混這兩個是排障題和設計題的常見雷區。
Multi-AZ 部署會在另一個 AZ 準備一份 standby,資料庫每次寫入都同步複寫到 standby——primary 要等 standby 也寫好才回應「寫入成功」,所以兩邊資料隨時一致。平常這個 standby 不能拿來讀取,它唯一的工作就是等 primary 掛掉的那一刻。
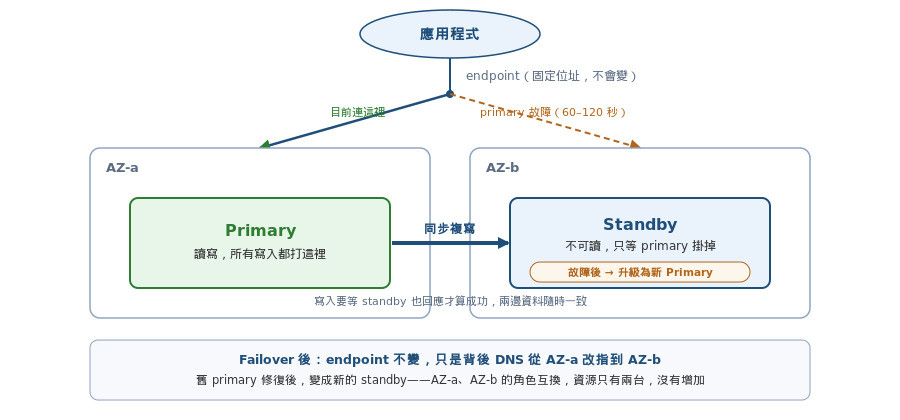
Primary 故障時,RDS 會自動把同一個連線位址(endpoint)背後的 DNS 紀錄切到 standby 上,應用程式不用改連線字串,整個過程通常在 60~120 秒內完成——這段時間寫入會失敗,應用程式要有重試機制。會觸發 failover 的不只是機器壞掉:AZ 整個出問題、primary 的 EBS 故障、你手動改 instance class 或做需要重開的維護,RDS 都會先切到 standby 再處理,把停機時間壓到最短。
這就是 Multi-AZ 存在的唯一目的:高可用,不是拿來分攤流量的。開 Multi-AZ 費用大約是單一 instance 的兩倍(兩台機器在跑),換的是那 60 秒內自動復原、以及維護時幾乎不停機。
Read Replica 是另一份可以讀取的資料庫複本,透過非同步複寫從來源資料庫同步資料——primary 寫完就先回應成功,之後才把變更送給 Replica。正因為是非同步,Replica 的資料可能比 primary 晚個幾秒才更新,這個差距叫 replica lag。
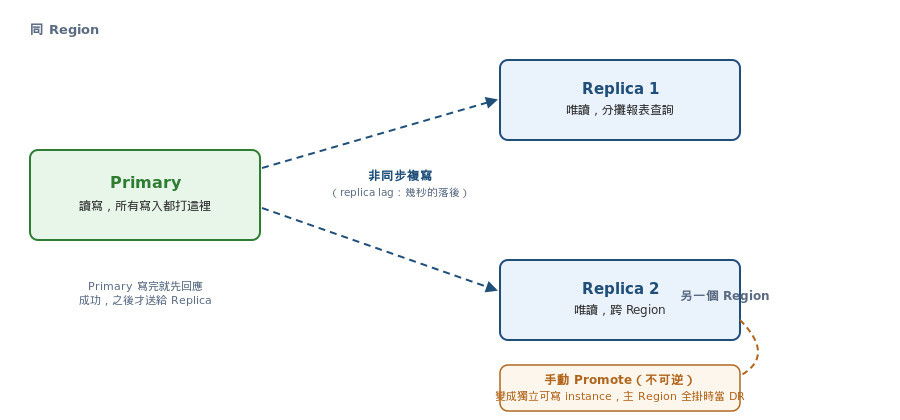
Read Replica 的用途是分攤讀取流量:把報表查詢、商品列表這類讀多寫少的操作導去 Replica,primary 就能專心處理寫入。每個 Replica 有自己的 endpoint,應用程式要自己決定哪些查詢連哪一個。一個來源最多可以開 15 個 Replica,其中最多 5 個可以在別的 Region。
Replica 預設唯讀,寫入操作打到它會被拒絕;要讓它變成可寫的獨立資料庫,得執行 promote,把它整個提升成 standalone instance,這是不可逆的操作,不是切換設定就好。Promote 是手動的、不會自動發生,所以 Read Replica 不是高可用機制——但它可以當災難備援的最後手段:跨 Region 的 Replica 在主 Region 全掛時 promote 起來,就是一個能寫的資料庫。
Replica 自己也可以開 Multi-AZ,讓「分攤讀取的那份」也有備援;反過來,Multi-AZ 的 standby 永遠不能拿來當 Replica 讀。
| Multi-AZ | Read Replica | |
|---|---|---|
| 複寫方式 | 同步 | 非同步 |
| Standby/Replica 可讀嗎 | 不可以 | 可以 |
| 目的 | 高可用、容錯 | 分攤讀取流量 |
| 故障時 | 自動 failover(約 60~120 秒) | 不會自動 failover,要手動 promote |
| 能跨 Region 嗎 | 不行,限同 Region 內的 AZ | 可以 |
RDS 核心細節
| 主題 | 說明 |
|---|---|
| 「受管」具體幫你做了什麼 | AWS 做:作業系統與引擎 patch、自動備份還原、硬體故障換機器、Multi-AZ 的同步與 failover、監控指標送 CloudWatch。你自己決定:引擎版本(MySQL 8、PostgreSQL 16……)、instance class(跟 EC2 一樣的 db.m5.large 這種規格)、儲存類型與大小、要不要開 Multi-AZ/Read Replica、放在哪個 VPC/subnet/Security Group(Day 5、6 的東西) |
| 自動備份 vs 手動 snapshot | 自動備份每天做一次+持續存交易 log,保留 1~35 天,能還原到保留期內的任何一秒(PITR);手動 snapshot 一直留到自己刪,只能還原到拍的那一刻。兩種還原都是建新 instance,不是塞回原本那台。有 Multi-AZ 時備份在 standby 上做,不影響 primary |
| Replica 的隱藏前提 | 來源 instance 的自動備份必須是開的(保留天數大於 0),不然建不出 Read Replica |
| Multi-AZ DB cluster | 比傳統 Multi-AZ 新的部署選項,standby 有兩個,而且可以讀取,複寫是半同步,failover 時間通常在 35 秒內,比傳統 Multi-AZ 的 60~120 秒快 |
| 維護視窗 | RDS 每週有一個你指定的時段做 patch,需要重開的 patch 會在這個時段做;有 Multi-AZ 就先 patch standby、切換、再 patch 另一邊,幾乎不停機 |
| 加密 | 建 instance 時決定要不要用 KMS 加密,建好之後不能直接打開——要加密就得拍 snapshot、複製時加密、再從加密的 snapshot 還原成新 instance |
Aurora 專屬機制(AWS 自家引擎,跟上面的 RDS 標準行為不完全一樣)
| 主題 | 說明 |
|---|---|
| 儲存與高可用的底子 | Aurora 把運算和儲存拆開:儲存層本來就自動跨 3 個 AZ 存 6 份,不用另外設定 Multi-AZ 就有高可用的底子 |
| Read Replica 的差異 | 跟 primary 共用同一份儲存,所以最多可以開到 15 個、複寫延遲通常在個位數毫秒,而且 Replica 可以被設定成自動 failover 目標(這點跟 RDS 的 Replica 不同) |
| 兩個 endpoint | Writer endpoint 永遠指向目前的 primary,Reader endpoint 會自動在所有 Replica 之間輪流分配連線——應用程式只要記這兩個位址,不用自己管 Replica 有幾個、哪個活著 |
| Global Database | 給跨 Region 災難復原用,次要 Region 的 cluster 走儲存層複寫、延遲通常在 1 秒內,故障時官方管理的 failover 可以在 1 分鐘內把次要 Region 提升為主要 |
| Serverless | 不用選 instance class,運算容量依負載自動伸縮、沒流量時可以縮到很小,適合流量忽高忽低或開發測試環境 |
連線管理
| 主題 | 說明 |
|---|---|
| RDS Proxy | 管理資料庫連線池,減少大量連線(例如幾百個 Lambda 同時連)對資料庫本身的負擔;failover 時也能幫應用程式撐住連線、縮短感受到的中斷時間。本身不提供讀寫分離 |
某醫療預約平台正在規劃一套新的 RDS for PostgreSQL 資料庫。需求有兩項:AZ 故障時要自動切換,而且寫入中斷時間必須控制在 60 秒以內;白天有大量唯讀查詢(例如查看可預約時段),需要從寫入端分流出去。公司不打算改用其他資料庫服務,希望以最符合成本效益(MOST cost-effective)的方式同時滿足這兩項需求。
哪一個部署方式最符合需求?
某線上券商的 RDS for MySQL 部署在 ap-northeast-1,已啟用 Multi-AZ。為了因應整個 Region 失效的情境,公司要求在 ap-southeast-1 建立災難復原:資料遺失不能超過數秒(RPO),災難發生後 30 分鐘內要有可寫入的資料庫(RTO)。公司不能把資料庫遷移到其他服務,並希望日常維運工作越少越好(LEAST operational overhead)。
解決方案架構師應該建議哪一個做法?
某公司的訂單 API 由 API Gateway 觸發 AWS Lambda,Lambda 直接連線到 RDS for MySQL(Multi-AZ)。促銷期間 Lambda 的同時執行數上千,資料庫頻繁出現
Too many connections錯誤;另外每次發生 Multi-AZ failover,API 都有好幾分鐘持續回報連線錯誤。公司希望以維運負擔最低、且不修改應用程式邏輯的方式同時改善這兩個問題。
解決方案架構師應該怎麼做?
max_connections 上限某公司三年前建立的 RDS for PostgreSQL(Multi-AZ)沒有啟用儲存加密。新的法遵要求所有正式環境的資料庫都必須以客戶管理的 KMS key 加密。資料庫約 200 GB,公司已排定週六凌晨 4 小時的停機維護時段,希望以維運負擔最低(LEAST operational overhead)的方式完成。
解決方案架構師應該怎麼做?
某公司的 RDS for MySQL(Multi-AZ,另有 1 個 Read Replica 供報表使用)已啟用自動備份、保留 7 天,每天 02:00 另外拍一次手動 snapshot。今天 14:32 一位工程師誤執行了
DROP TABLE orders,14:40 才被發現。應用程式部署在數十台伺服器上,資料庫連線位址寫在各團隊的設定檔裡。公司要求把資料救回到誤刪前一刻,並在不修改這些連線設定的前提下盡快恢復服務。
哪兩項步驟的組合最符合需求?(選擇兩項)
Multi-AZ DB cluster 有一個 writer 和兩個 standby,兩個 standby 都可以讀,唯讀查詢連 reader endpoint 就會分散到這兩台;failover 通常在 35 秒內完成,符合「60 秒以內」。三台 instance 同時負責高可用和讀取分流,不用另外付 Read Replica 的錢。
A 能分流讀取,但 Multi-AZ DB instance 的 failover 通常要 60~120 秒,不符合時間要求;而且總共要跑四台(primary、standby、兩個 Replica),成本比 B 高。C 的 promote 是把 Replica 提升成一個新的獨立資料庫,endpoint 會變;而且 Replica 是非同步複寫,可能掉資料,自己寫 Lambda 也不算自動 failover。D 是這篇最常見的誤解:Multi-AZ DB instance 的 standby 不能讀,沒有可以連的 endpoint。
cross-Region Read Replica 平常持續非同步複寫,延遲通常是秒級,符合「數秒」的 RPO;災難時 promote 只要幾分鐘,符合 30 分鐘的 RTO。平時只需要維護這一個 Replica,沒有其他日常操作。
A 是最有誘惑力的干擾項:cross-Region 自動備份複寫是真實功能,但交易日誌大約每 5 分鐘才複製一次,RPO 是以分鐘計,不是數秒;而且還原要從頭建立 instance,時間跟資料量成正比。B 的 RPO 最長可達一小時,完全不符合。C 的 Aurora Global Database 符合 RPO 和 RTO,但要把資料庫遷移到 Aurora,違反「不能遷移到其他服務」。
RDS Proxy 維護一個連線池,上千個 Lambda 共用少量的資料庫連線,Too many connections 就消失了。failover 時由 proxy 接住應用程式的連線,並直接追蹤新的 primary,不受 DNS 快取影響,應用程式感受到的中斷時間會明顯縮短。應用程式只要改連線位址這個設定,不用改邏輯。
B 能撐多一點連線,但 Lambda 的併發量可以一直往上加,而且對 failover 完全沒有幫助。C 是誤解:Read Replica 是唯讀的,訂單 API 的寫入打到 Replica 會直接失敗。D 能削峰,但 API 原本是同步回應結果,改成佇列等於要重新設計應用程式的回應流程,違反「不修改應用程式邏輯」;而且也沒有處理 failover 的問題。
RDS 只能在建立時決定要不要加密。標準做法是先拍 snapshot,複製時開啟加密並指定客戶管理的 KMS key,再從加密的 snapshot 還原出新的 instance。整個流程只用 RDS 內建的操作,在排定的停機時段內執行即可,維運負擔最低。
A 是誤解:既有的 DB instance 沒有「修改後原地加密」這個選項。B 也是誤解:RDS 不允許從未加密的 instance 建立加密的 Read Replica,來源和 Replica 的加密狀態必須一致。D 技術上可行,停機時間也最短,但要另外建立 DMS 的複寫 instance、設定任務、監控同步並驗證資料;既然已經有 4 小時的停機時段,這些工作都是多出來的維運負擔。
自動備份加上持續保存的交易日誌,可以把資料庫還原到保留期內的任何一秒,所以能回到 14:31,也就是誤刪前一刻。但 point-in-time restore 一定是建立一個新的 instance,而 RDS 的 endpoint 是由 DB identifier 組成的:先把原 instance 改名(它的 endpoint 會跟著變),再把新 instance 改成原本的 identifier,新 instance 就會使用原本的 endpoint 名稱,數十台伺服器的設定都不用動。還原時也可以直接指定 Multi-AZ,維持原本的高可用設定。兩步合起來才完整。
B 是誤解:Read Replica 會複寫所有變更,DROP TABLE 也會跟著複寫過去,Replica 上的表一樣不見了。C 能救回資料,但只能回到 02:00,之後 12 個多小時的交易都要靠日誌手動補,資料遺失和工作量都遠大於 point-in-time restore。D 能讓服務恢復,但要改數十台伺服器上各團隊的設定,違反「不修改這些連線設定」,而且改的台數越多,恢復得越慢。


 iThome鐵人賽
 看影片追技術