
DynamoDB 是 AWS 的全受管 NoSQL 資料庫。跟上一篇的 RDS 並排看,差別最清楚:
| RDS(關聯式) | DynamoDB(NoSQL) | |
|---|---|---|
| 資料長相 | 固定 schema,每一列欄位都一樣 | key-value/文件型,除了主鍵,欄位自由 |
| 名詞 | 表格/列/欄 | table/item/attribute |
| 跨表查詢 | 用 JOIN 兜資料 | 幾乎不支援 JOIN |
| 擴展 | 換更大的 instance、加 Read Replica | 容量自動擴展,任何規模都維持個位數毫秒延遲 |
設計順序是反過來的: RDS 先設計表格關聯,查詢時再 JOIN;DynamoDB 先列出應用程式所有的查詢情境,再決定 partition key 和 sort key——key 選錯了,後面很難用索引補救。這篇往下的熱分區、Query 和 Scan、兩種索引、容量單位,都是這句話的後果。
同一張 table 裡的 item 不用長得一樣,一筆訂單有 5 個 attribute、另一筆有 4 個,完全可以:
Table: Orders
{ "userId": "u-1001", "orderTime": "2026-09-18T10:22:00", "total": 1280, "status": "PAID",  "coupon": "AUG20" }
{ "userId": "u-1001", "orderTime": "2026-09-19T08:05:00", "total": 340,  "status": "SHIPPED" }
{ "userId": "u-2042", "orderTime": "2026-09-19T09:41:00", "total": 99,   "status": "PAID",  "gift": true }
   └── partition key ──┘└──── sort key ────────┘
唯一一定要有的是主鍵:這張表選 userId 當 partition key、orderTime 當 sort key。單一 item 上限 400KB。
每張表都要有 partition key(分區鍵)。DynamoDB 用它的值做雜湊,決定 item 存在哪個實體分區——自動、看不到,但決定了效能。
設計目標只有一個:讓請求平均分散到各分區。 請求集中在同一個 key 值,單一分區會被打滿而節流(throttle),整張表容量再寬裕也沒用——這叫熱分區(hot partition)。
壞的 partition key:orderDate(值只有「今天」「昨天」……)
  2026-09-18  ████████████████████████  ← 尖峰時所有寫入全擠在這一個分區 → throttle
  2026-09-17  ██
  2026-09-16  █

好的 partition key:userId(值有幾十萬種,天然分散)
  u-1001  ███      u-2042  ██      u-3310  ███      u-4177  ██   ……
判斷一個欄位適不適合當 partition key,看兩件事:
還可以加一個 sort key(排序鍵),兩者合稱複合主鍵:同一個 partition key 下可以放多個 item,依 sort key 排序。Orders 表的 userId + orderTime 就是這樣,同一個使用者的訂單排在一起、照時間排好。
Partition key 設計好壞,直接反映在讀資料的方式上:
| Query | Scan | |
|---|---|---|
| 怎麼找 | 給 partition key(可以再加 sort key 的條件),直接跳到那個分區拿 | 從頭到尾讀整張表,一筆一筆比對 |
| 讀多少資料 | 只讀符合的那些 item | 整張表全部讀一遍 |
| 消耗的容量 | 只算讀到的 | 整張表的大小,就算最後只留下 3 筆 |
| 例子 | 「u-1001 在 9 月的訂單」 | 「所有 status = PAID 的訂單」(沒有以 status 為 key 的索引時) |
between、begins_with)Scan + filter「status = PAID」
讀取 10,000 筆 ████████████████████ ← 容量照這個算
回傳 3 筆 █
只能靠 Scan 的查詢,通常代表 key 設計漏了這個情境——補救方法就是下一段的索引。
Partition key 只能拿來查「等於某個值」,如果應用程式常常要用別的欄位查資料,就得靠次要索引:
| Local Secondary Index(LSI) | Global Secondary Index(GSI) | |
|---|---|---|
| Partition key | 跟原表一樣 | 可以換成別的欄位 |
| 建立時機 | 只能在建表當下一起定義,事後不能加 | 隨時可以新增或刪除 |
| 容量 | 跟原表共用 | 自己獨立的容量設定 |
| 讀取一致性 | 可以選強一致性 | 只能最終一致性 |
| 單一 partition key 值的索引項目上限 | 10 GB | 沒有限制 |
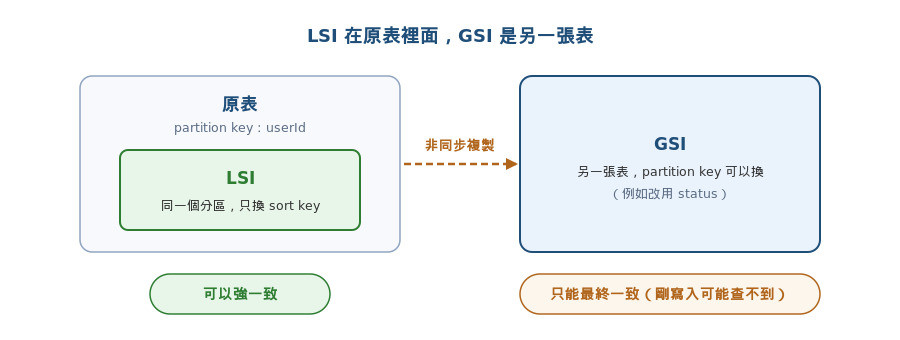
套回 Orders 表:想依訂單狀態查,就開 GSI(status + orderTime)。但 status 只有幾種值,GSI 本身會變熱分區,常見解法是改用 status#2026-09 這種組合 key 把值打散。
DynamoDB 的效能和費用都用兩個單位算:
| 單位 | 一個單位等於 | 換算 |
|---|---|---|
| RCU(read capacity unit) | 每秒 1 次強一致性讀取,item 最大 4 KB | 最終一致性讀取只算一半:1 RCU = 每秒 2 次;item 超過 4 KB 就按 4 KB 一份往上算 |
| WCU(write capacity unit) | 每秒 1 次寫入,item 最大 1 KB | item 3 KB 的一次寫入 = 3 WCU |
例:每秒讀 100 次 2 KB 的 item,強一致性要 100 RCU,最終一致性只要 50 RCU。
兩者差在哪(跟 Day 12 的 replica lag 類似):每筆資料在底層存三份,寫入時兩份確認就回成功。
寫入 total = 500
  副本 A  500 ✔ ┐
  副本 B  500 ✔ ┘ 兩份確認 → 回「寫入成功」
  副本 C  300     ← 還在追,通常 1 秒內追上

最終一致性讀取:可能剛好讀到 C → 拿到舊的 300    0.5 RCU
強一致性讀取:  保證拿到最新的 500               1 RCU
容量怎麼買,有兩種模式:
| Provisioned | On-Demand | |
|---|---|---|
| 怎麼設 | 自己填每秒要多少 RCU/WCU,可以加 Auto Scaling 讓它在上下限之間自動調 | 什麼都不填,用多少算多少 |
| 超過會怎樣 | 超過設定值就 throttle(有一點 burst 額度緩衝) | 自動撐住,幾乎不會 throttle |
| 單價 | 便宜,適合流量穩定、可預測 | 每次請求的單價比較高,適合流量忽高忽低、難預測、或剛上線不知道量 |
兩種模式可以互換,但兩個方向的限制不一樣:
實務上常見的節奏:
新服務上線,不知道量                    跑一陣子,流量形狀穩定了
   On-Demand  ──────────────────────▶  Provisioned + Auto Scaling
   (不用猜容量,單價高)                 (照觀察到的流量設上下限,省錢)
| 功能 | 一句話 |
|---|---|
| DAX | 記憶體快取,讀取從毫秒降到微秒;只快取最終一致性讀取,寫入直接穿透 |
| DynamoDB Streams | 記錄新增/修改/刪除事件(保留 24 小時),常用來觸發 Lambda |
| Global Tables | 多個 Region 各一份可讀寫的 replica,雙向同步 |
| TTL | item 到期自動刪除、不耗 WCU,但不是一到期馬上刪 |
| 備份 | on-demand 備份,或開 PITR 還原到 35 天內任一秒 |
| 概念 | 說明 |
|---|---|
| DynamoDB | 全受管 NoSQL,table/item/attribute,先想查詢方式再設計 key,幾乎不支援 JOIN |
| Partition key | 決定資料落在哪個分區,要挑值多又分散的欄位,設計不好會造成熱分區被節流 |
| Sort key | 跟 partition key 組成複合主鍵,適合一對多的資料形狀 |
| Query vs Scan | Query 靠 key 直接找、只算讀到的;Scan 整張表讀一遍、過濾不省錢 |
| LSI | 只能建表當下定義,共用容量,可選強一致性 |
| GSI | 隨時可加,獨立容量,只有最終一致性 |
| RCU/WCU | 讀 4 KB、寫 1 KB 各算一個單位;最終一致性讀取只算一半 |
| On-Demand vs Provisioned | 前者免設定、單價高,流量難預測時用;後者自己設容量、便宜,流量穩定時用 |
| DAX/Global Tables | 分別解決「重複讀取太熱」和「多 Region 都要能寫」兩個不同問題 |
回到開頭那句:所有東西都從 key 的選擇長出來。熱分區是 key 選得太集中,Scan 是 key 沒對齊查詢,GSI 是替另一種查詢再選一組 key。
身份與網路安全、運算與儲存核心到這裡告一段落。下一天進高可用與流量入口:Auto Scaling 搭配 ELB。
某手機遊戲公司用 DynamoDB 記錄玩家在限時活動中送出的每一次得分,表格的 partition key 是
eventId、sort key 是playerId#timestamp,每筆 item 小於 1 KB。每場活動只有一個eventId,活動開始後每秒約 8,000 次寫入全部集中在這個值上;即使把表格的佈建 WCU 調高到 20,000,仍然持續發生節流(throttling)。每筆得分都必須寫入成功,活動結束後才彙總排名。
在不降低寫入吞吐量的前提下,解決方案架構師應該怎麼做?
eventId 加上 0~19 的隨機後綴作為 partition key,彙總時分別 Query 20 個鍵值再合併playerId 為 partition key 的 GSI,讓寫入分散到索引的不同分區上,減輕原表熱分區的寫入壓力某電商的 DynamoDB 表格 Orders 存有 5 億筆訂單,partition key 是
orderId。風控系統會在可疑訂單上多寫一個reviewFlagattribute,這類訂單不到總量的 0.1%。風控人員每隔幾分鐘就要查詢一次「所有待審核的可疑訂單」,目前的做法是 Scan 加上 filter,每次都讀完整張表。公司希望以最符合成本效益(MOST cost-effective)的方式,讓這個查詢維持近乎即時。
解決方案架構師應該怎麼做?
reviewFlag 為 partition key 的 GSI,只有帶這個 attribute 的訂單會進索引,再對它 Querystatus 為 partition key 的 GSI,讓所有訂單都寫進索引,查詢時再用 filter 篩出待審核的可疑訂單reviewFlag 為 sort key 的 LSI,讓同一個 orderId 底下的可疑訂單可以直接用 Query 取得reviewFlag 的訂單,減少對 DynamoDB 表格的讀取某新聞網站的文章存在 DynamoDB,首頁的熱門文章每秒被讀取數萬次。團隊為了降低讀取延遲導入了 DAX,應用程式也已改用 DAX client 連線,但上線後讀取延遲沒有改善,DynamoDB 的 RCU 消耗也幾乎沒變。檢查後發現,應用程式所有的讀取請求都設定了
ConsistentRead=true。文章內容允許有幾秒的更新延遲。
在修改最少的前提下,解決方案架構師應該怎麼做?
ConsistentRead=true,讓 DAX 能直接從快取回應某叫車平台在 us-east-1 與 ap-northeast-1 各部署一套應用程式。兩地的司機與乘客都要在本地 Region 以個位數毫秒的延遲讀寫行程資料;任一 Region 完全失效時,另一個 Region 要能繼續讀寫,資料遺失控制在 1 秒左右。公司希望以維運負擔最低(LEAST operational overhead)的方式設計 DynamoDB。
哪一個方案最符合需求?
某 SaaS 公司的 DynamoDB 表格上線一年,一直使用 On-Demand 模式。CloudWatch 顯示讀寫流量全天都落在可預測的範圍內,白天比夜間高約 50%,預期未來一年也會維持這個模式。表格約 50 GB,每筆資料每天都會被多次讀寫,費用幾乎都來自讀寫請求。財務部門要求降低 DynamoDB 的費用。
哪兩項做法最符合成本效益(MOST cost-effective)?(選擇兩項)
單一 partition key 值的吞吐量受實體分區上限限制,每秒最多約 1,000 WCU,所以表格的總容量再大,eventId 這一個值還是撐不住 8,000 次寫入。加上 0~19 的隨機後綴,就把同一場活動拆成 20 個 partition key 值,每個值每秒只剩約 400 次寫入,能散到不同分區。代價是讀取時要 Query 20 次再合併,但這份資料本來就是活動結束後才彙總,完全可以接受。
A 是誤解:On-Demand 只是不用自己設容量,單一分區的上限一樣存在,熱門的鍵值一樣會被節流。B 也是誤解:DAX 是讀取快取,寫入會直接穿透到 DynamoDB,沒有「先存在記憶體再批次寫回」的緩衝功能。D 解錯了地方:寫入還是要先寫進原表,原表的 eventId 依然是熱鍵,GSI 分散不了原表的寫入壓力。
這是 sparse index 的典型用法:GSI 只會收錄帶有索引 key attribute 的 item,所以以 reviewFlag 當 partition key,索引裡就只有那 0.1% 的可疑訂單,儲存和寫入的成本都很小,Query 也只讀需要的資料。因為可疑訂單寫入的頻率很低,這個 key 雖然只有少數幾種值,也不會形成熱分區。
B 可行,但 5 億筆訂單全部都會寫進索引,索引的儲存和每次寫入的 WCU 都要多付一份,成本遠高於 sparse index。C 有兩個問題:LSI 只能在建表時建立,不能加到既有的表格上;而且 LSI 的 partition key 跟原表一樣是 orderId,只能在單一訂單底下查,查不到「所有可疑訂單」。D 每天才匯出一次,違反「近乎即時」的要求。
DAX 只快取最終一致性讀取;強一致性讀取會直接轉給 DynamoDB,結果也不會存進快取。所以所有請求都帶 ConsistentRead=true 時,DAX 等於只是一個轉送的中繼站,延遲和 RCU 都不會改善。文章允許幾秒的延遲,把讀取改成最終一致性(也就是 DynamoDB 的預設值),DAX 就能直接從快取回應。
A 和 B 都在調整快取本身,但問題是請求根本沒有進快取,加大節點或延長 TTL 都不會有任何效果。C 等於自己再做一層快取,要處理失效和一致性,修改量最大;而且同樣的延遲容忍度,直接改用最終一致性讀取就能讓現有的 DAX 發揮作用。
Global Tables 讓同一張表在多個 Region 各有一份可讀寫的 replica,每個 Region 都在本地讀寫,延遲是個位數毫秒;DynamoDB 會在背景雙向同步,延遲通常在一秒左右。任一 Region 失效時,另一個 Region 的 replica 本來就可以寫,不需要任何切換操作。
A 是用 Streams 加 Lambda 自己做一套 Global Tables:衝突處理、重試、監控都要自己維護,維運負擔最高。C 讓 ap-northeast-1 每次讀寫都要跨半個地球,達不到個位數毫秒;us-east-1 失效時也沒有任何備援。D 的資料遺失最多一小時,而且從備份還原要時間,不符合「繼續讀寫、遺失約 1 秒」。
流量穩定又可預測,就是 Provisioned 模式最省錢的情境:單價比 On-Demand 低很多,再用 auto scaling 跟著日夜的曲線調整,夜間不必為白天的容量付錢。全天都會用到的基線容量,還可以再買 reserved capacity,用一年的承諾換取更低的折扣價。這兩項各自都能省錢,而且可以疊加使用。
A 方向相反:Standard-IA 降低的是儲存費用,讀寫請求的單價反而比較高,對一個費用幾乎都來自讀寫的表格只會更貴。C 是誤解:DAX 只能減少重複的讀取,寫入會直接穿透到 DynamoDB;資料每天被多次改寫,快取命中率也不高,還要多付 DAX 節點的費用。D 雖然也比 On-Demand 便宜,但夜間的容量完全閒置,成本不如 B 加上 auto scaling。


 iThome鐵人賽
 看影片追技術