
深入 Day 12 觀察到的「學生 vs. 職場人士」族群差異,使用SciPy進行雙軌假設檢定——針對連續指標(螢幕時數、睡眠時數、CESI 綜合疲勞指數)執行獨立樣本 $t$ 檢定與 Mann-Whitney U 檢定;針對類別特徵「疲勞風險等級(Digital_Eye_Strain_Risk)」執行卡方獨立性檢定,驗證職場高風險佔比突破三成是否具備統計顯著性。
一、實作前情境:職場人士的高風險比例(31.6% vs. 27.4%)真的顯著嗎?
在 Day 12 的分組探索中,我們發現了幾項引人注目的現象:
然而,如同 Day 16 的分析原則:差4.2個百分點不能單憑肉眼定案。
今天我們將推論統計工具擴充至卡方檢定,一次排查連續與類別兩大維度的族群顯著性。
二、撰寫雙軌統計假設檢定腳本
在 Colab 中新增儲存格,建立連續變數檢定迴圈與卡方列聯表檢驗:
# ==========================================
# Day 17:學生 vs 職場人士之連續與類別統計檢定
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import pandas as pd
import numpy as np
from scipy import stats

# 1. 連續型特徵假設檢定 (Student vs. Professional)
group_stu = df[df['Role'] == 'Student']
group_pro = df[df['Role'] == 'Professional']

cont_targets = ['Daily_Screen_Hours', 'Sleep_Hours', 'CESI_Score']
cont_names = ['每日螢幕時數', '每日睡眠時數', 'CESI綜合指數']

cont_results = []

for col, name in zip(cont_targets, cont_names):
    data_stu = group_stu[col]
    data_pro = group_pro[col]

    # 常態性檢定 (Shapiro-Wilk)
    _, p_norm_stu = stats.shapiro(data_stu)
    _, p_norm_pro = stats.shapiro(data_pro)
    is_normal = (p_norm_stu > 0.05) and (p_norm_pro > 0.05)

    # 變異數同質性檢定 (Levene)
    _, p_levene = stats.levene(data_stu, data_pro)
    equal_var = p_levene > 0.05

    # 獨立樣本 t 檢定
    t_stat, p_ttest = stats.ttest_ind(data_stu, data_pro, equal_var=equal_var)

    # Mann-Whitney U 檢定
    u_stat, p_utest = stats.mannwhitneyu(data_stu, data_pro, alternative='two-sided')

    cont_results.append({
        '指標項目': name,
        '學生(均值)': round(data_stu.mean(), 2),
        '職場人士(均值)': round(data_pro.mean(), 2),
        '差值(Pro-Stu)': round(data_pro.mean() - data_stu.mean(), 2),
        '常態性': '符合' if is_normal else '偏離常態',
        't檢定 p值': round(p_ttest, 4),
        'Mann-Whitney p值': round(p_utest, 4),
        '顯著性(α=0.05)': '顯著差異' if (p_ttest if is_normal else p_utest) < 0.05 else '無顯著差異'
    })

print("=== 1. 連續變數之雙樣本檢定報告 ===")
display(pd.DataFrame(cont_results))

# 2. 類別特徵卡方獨立性檢定 (Role vs. Digital_Eye_Strain_Risk)
contingency_table = pd.crosstab(df['Role'], df['Digital_Eye_Strain_Risk'])
chi2, p_chi2, dof, expected = stats.chi2_contingency(contingency_table)

print("\n=== 2. 疲勞風險分級觀察頻數列聯表 (Observed) ===")
display(contingency_table)

print("\n=== 3. 卡方獨立性檢定結果 ===")
chi2_summary = pd.DataFrame([{
    '卡方統計量 (Chi2)': round(chi2, 4),
    '自由度 (df)': dof,
    'p 值': round(p_chi2, 4),
    '顯著性判定 (α=0.05)': '兩者具有顯著相關' if p_chi2 < 0.05 else '兩者獨立 (無顯著關聯)'
}])
display(chi2_summary)
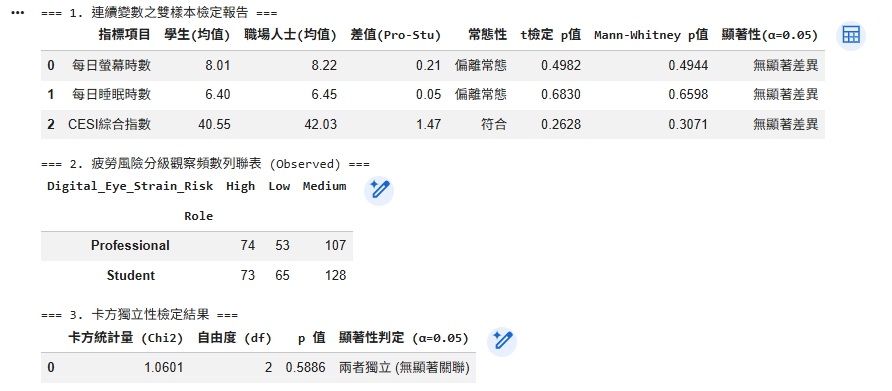
三、圖表解讀與統計檢定結論
本實作整合了雙樣本檢定與卡方獨立性檢定,針對「學生 vs. 職場人士」展開全維度驗證,得出以下客觀結論:
b.每日睡眠時數(Sleep_Hours):
c.CESI 綜合疲勞指數(CESI_Score):
學生平均 40.55 分,職場人士平均 42.03 分(差值 +1.47 分)。
經 Shapiro-Wilk 檢定,綜合指數符合常態分佈。
獨立樣本 t 檢定 p = 0.2628;Mann-Whitney U 檢定 p = 0.3071。
即使融合了暴露比、自覺症狀與急性警訊,兩大族群的綜合用眼疲勞負擔依然無統計顯著差異。
b.卡方檢定統計量:
卡方值 X^2 = 1.0601。
自由度 df=2。
p 值 = 0.5886。
c.統計推論與實質意涵:
檢定結果明確顯示 p = 0.5886 遠大於 0.05,無法拒絕虛無假設,判定「身分角色」與「疲勞風險分級(Digital_Eye_Strain_Risk)」兩者相互獨立!
雖然在 Day 12 的描述統計中,職場人士高風險比例看似比學生高出 4.2%(31.6% vs. 27.4%),但卡方檢定證實該差異在統計上完全不顯著,純屬隨機抽樣過程中的自然波動。


 iThome鐵人賽
 看影片追技術