

主管會派工了,但派工這件事在 n8n 裡至少有三種做法。今天把三種都實作出來,用同一批 30 封信跑過,比正確率、成本和延遲。
先講結論:正確率分不出高下,差距落在雜訊範圍內。真正有差的是成本,以及一個跟數字無關的東西——能不能單獨測試。
它們最大的差別,在於「誰決定派給誰」,以及專員住在哪裡。下圖先看整體。
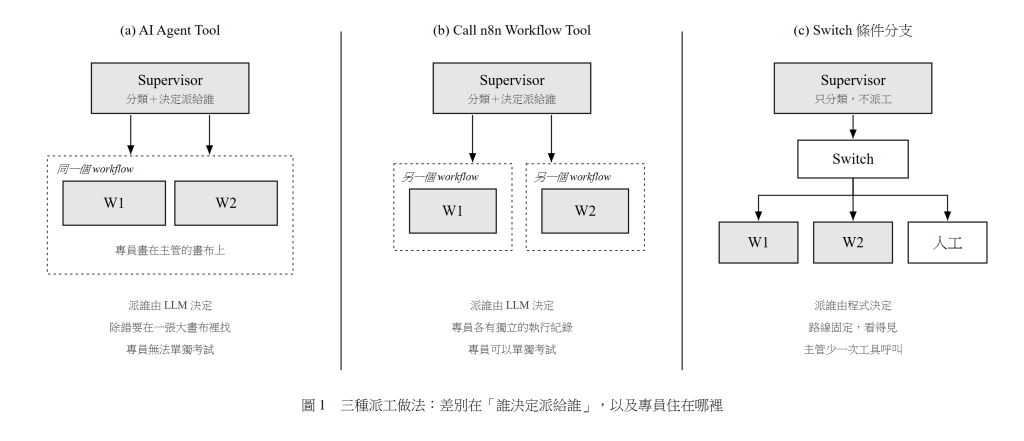
A:AI Agent Tool。 專員就畫在主管的畫布上。n8n 的 agentTool 節點本身是一個完整的 Agent,底下可以再掛自己的模型、Output Parser 和工具。主管把它當成一個工具呼叫,$fromAI 填的是一段文字工單。
B:Call n8n Workflow Tool。 Day 16 用的做法。專員是獨立的 workflow,主管透過工具呼叫它,參數對應 Execute Workflow Trigger 定義的欄位。
C:Switch 條件分支。 主管只做分類,不碰工具。分類結果交給一個 Code 節點算出路線,再用 Switch 分到四條線:查單、查知識、兩個都查、轉人工。專員用 Execute Workflow 節點呼叫,兩位都查的那條線最後用 Merge 合併。
C 的派工規則是這樣寫的,完全不經過模型:
const HUMAN_INTENTS = ['complaint', 'promo_coupon', 'other', 'return_refund'];
const needsHuman = HUMAN_INTENTS.includes(intent) || !!r.needs_human;

const wantsOrder = intent === 'order_status' || intent === 'return_refund' || secondary.includes('order_status');
const wantsKnowledge = intent === 'product_qa' || intent === 'return_refund' || secondary.includes('product_qa');
let route = 'human';
if (!['complaint', 'promo_coupon', 'other'].includes(intent)) {
  route = wantsOrder && wantsKnowledge ? 'both' : wantsOrder ? 'order' : wantsKnowledge ? 'knowledge' : 'human';
}
C 的主管 prompt 也跟著縮短。不用描述工具、不用講派工規則,只剩分類表和輸出格式,從 70 幾行變成 45 行。
A 版內嵌的 faq_search 節點,它的 Embeddings 子節點還掛著 nomic-embed-text,但 Day 17 已經把索引換成 bge-m3 了。
查詢和索引用不同的模型,向量維度不同,查出來的東西毫無意義——而且不會報錯,只會每題都回 not_found。第一次跑出來 A 版的知識類題目全軍覆沒,我才發現。
換 embedding 模型的時候,要記得掃過所有用到它的地方,不只是主要那個 workflow。
跟考卷不一樣,這次評的是端到端的結果:最後那封草稿有沒有該提的資訊、有沒有不該說的話、該轉人工的有沒有轉。判定分四級:
三個版本用同一份主管 prompt 的對應版本、同一個 bge-m3 檢索、同一個 W3。
| A:AI Agent Tool | B:Call n8n Workflow Tool | C:Switch 寫死路由 | |
|---|---|---|---|
| pass | 26/30 | 26/30 | 24/30 |
| partial | 3 | 3 | 5 |
| fail(危險) | 1 | 1 | 1 |
| 意圖分類正確 | 29/30 | 29/30 | 28/30 |
| 派工路線正確 | 87% | 83% | 93% |
| tokens 中位數 | 8290 | 9238 | 5098 |
| 其中主管自己 | 4454 | 5100 | 1247 |
| 30 封總 tokens | 244357 | 280470 | 146437 |
| 延遲 p50 | 6.1 秒 | 7.2 秒 | 5.0 秒 |
| 延遲 p95 | 11.2 秒 | 11.3 秒 | 10.9 秒 |
C 比 A、B 少兩分,但我去看那兩封信,發現問題不在派工。
EV08 是「我的訂單到了嗎?」,客人名下有兩筆訂單。C 的路由正確、W1 也正確回報了兩筆訂單的狀態,八筆事實都在。但 W3 寫草稿時只寫了 A10293,把 A10296 整個漏掉。B 的 W3 兩筆都寫了。
EV13 是一信兩問,C 一樣正確派了兩位專員,facts 裡明明白白有「訂單狀態=備貨中 (packing)」,W3 卻寫成「關於訂單 A10294 的出貨狀態,我這邊幫您確認後回覆」。資料在手上卻說要再確認。
兩封的失分都發生在 W3,而三個版本的 W3 是同一個、temperature 都是 0.4。換句話說,這兩分是寫信那一層的隨機性,跟派工拓樸沒有關係。
30 封信、每個版本只跑一輪,兩分的差距我不敢說是真的差距。要分出高下,得跑多輪或加大樣本,Day 28 用完整的 50 封信再做一次。
表裡 C 的路由正確率最高(93%),但這有點作弊——C 的路由是我寫死的程式,它當然會照我的期望值走。
A 和 B 被扣分的地方,大多是客訴信它們仍然派工去查了訂單資料,而我的期望值寫的是「客訴不派工」。Day 17 已經討論過這件事:我認為派工是對的,真人接手客訴時手上有資料比較好,該改的是我的期望值。
所以這一列要這樣讀:C 的 93% 代表「程式照規則執行」,A、B 的 83 到 87% 裡面有一部分是「模型做了規則以外但合理的事」。兩者不是同一件事。
主管自己那一段的 token,C 只有 A、B 的四分之一左右:1247 對 4454 和 5100。
原因很直接。A、B 的主管要跑 ReAct 迴圈:第一次呼叫決定要不要用工具、用哪個、參數填什麼,工具回來之後再呼叫一次整理結果。每一次呼叫都要重送整份 system prompt,而那份 prompt 為了教它怎麼派工,有 70 幾行。
C 的主管只呼叫一次,prompt 短、沒有工具定義、沒有工具回傳要重送。派工的判斷從「模型推理」變成「程式查表」,而查表是免費的。
整批跑下來,C 的總 token 比 B 少 48%。如果一天處理 500 封信,這個差距很實在。
EV16:「我上週買的手沖壺,物流顯示 9/11 已經送達,但我根本沒有收到!訂單 A10315,這要怎麼處理?」
三個版本都把它分類成 return_refund,而且三個都正確地把 needs_human 標成 true。然後三個都產生了草稿準備寄出去。
問題出在決定要不要轉人工的那個 Switch。我寫的條件是:
['complaint', 'promo_coupon', 'other'].includes($json.intent)
它只看 intent,完全沒看 needs_human。模型判斷對了,流程沒有接住。
這正是 Day 17 那個發現的實際後果——我把「要不要派工查資料」和「要不要由 AI 回信」混在同一條規則裡。模型那邊早就分清楚了,程式這邊沒有。
我把 B 版的條件改成「needs_human 為真,或 intent 屬於那三類」,重跑 30 封。
危險錯誤從 1 變成 0,EV16 確實轉給人了。但 pass 從 26 掉到 24,多出來的四封全是退貨類:客人問已開封能不能退、袋子破了怎麼辦、豆子太苦想退、退貨一個多禮拜錢還沒退。它們現在連草稿都不寫,直接轉人工。
| 原版 | 改用 needs_human 當條件 | |
|---|---|---|
| pass | 26/30 | 24/30 |
| partial | 3 | 6 |
| fail(危險) | 1 | 0 |
這四封的標準答案寫的是 action: reply 加 needs_human: true,意思是「AI 寫草稿,但要人審過才寄」。這也正是 Day 09 定規格時寫的:退貨仍會查資料寫草稿,但一定要人審。
所以兩個版本都不對,因為我的出口只有兩個,而實際需要三個:
| 情況 | 該怎麼走 |
|---|---|
| 客訴、優惠、無法分類 | 連草稿都不寫,直接給人 |
| 退貨、換貨、保固 | 寫草稿,但要人審過才寄 |
| 一般查單、知識問題 | 寫草稿,直接寄 |
一個布林值表達不了三條路。Day 25 做人工審批的時候,會把這裡拆開:Switch 只決定「要不要寫草稿」,草稿要不要人審是另一個欄位,走 Wait 節點那條線。
我先把這個修正留在 B 版,但不把它算進今天的比較,因為另外兩個版本沒有同步改。
三個版本都被扣過同一題的分:客人問「你們有賣濾掛包嗎」,FAQ 沒寫,三個版本的草稿都是「關於是否有販售濾掛咖啡包,我這邊幫您確認後,最晚 24 小時內回覆您」。
完全正確的回答,但評估集的禁止樣式裡有「有販售」,於是被判成「說了不該說的」。A 版只是剛好寫成「關於是否販售濾掛咖啡包」少一個字才逃過。
這是這個系列第六個同一類的評分 bug 了(Day 13 兩個、Day 15 講過四個)。這次我不改標準答案,改評分程式本身:比對禁止內容之前,先把含有「是否」的子句拿掉,因為複述客人的問題不算斷言。
function stripRestatement(text) {
  return String(text ?? "")
    .split(/[。,,!!??\n;;]/)
    .filter((clause) => !clause.includes("是否"))
    .join(",");
}
改在評分器而不是改標準答案,是因為這個毛病會在每一題重複出現。三個版本一起重新評分之後,B 和 C 各多一分,上面的表格是修正後的數字。
正確率分不出來,成本 C 最省,那為什麼我接下來用 B?
因為 A 有一個硬傷:專員畫在主管的畫布上,就沒辦法單獨丟工單進去測。Day 15 那三份考卷在 A 版架構下跑不起來,而考卷是我判斷「改東西到底有沒有變好」的唯一依據。A 版的執行紀錄也是一整包,三個 Agent 的推理混在同一筆 execution 裡,出事時要在一大張畫布上找。
C 的優點很實在,但它的分類要到 Day 20 的接力任務才會遇到真正的考驗——一封信需要先查單、再依查到的結果決定要不要查知識,這種情況寫死的路由表達不出來。而且 C 省下來的 token 主要是主管那一段,等專員數量變多、每位專員的回報變長,這個比例會縮小。
B 的缺點是貴,而且 LLM 決定派給誰,行為不如寫死的穩定。但它的專員是獨立 workflow,可以單獨考試、有獨立的執行紀錄、改一位不影響其他人。這三件事在接下來十幾天會一直用到。
如果是正式上線的系統,我會把兩者混用:分類和路由用 C 的寫法(程式決定,便宜又穩),專員用 B 的形式(獨立 workflow,可測試)。這兩件事本來就不衝突,是我為了做對照才把它們綁在一起比。
三種派工做法跑同一批 30 封信:pass 26、26、24,差距在雜訊範圍內,而且 C 少的兩分追下去是 W3 寫草稿漏資料,跟派工無關。真正有差的是成本,Switch 版把主管的 token 砍到四分之一、總量少 48%。三個版本都答錯的那一封,錯在 Switch 的條件只看 intent 沒看 needs_human;修好之後危險錯誤歸零,但退貨類全部變成不寫草稿——因為出口只有兩個而實際需要三個。
明天把 trace log 做出來。今天這些結論都是我逐題翻 jsonl 翻出來的,那不是長久之計。


 iThome鐵人賽
 看影片追技術