
昨天那些結論,是我把 jsonl 一列一列翻出來的。三十封信、三個版本,我開了三個分頁對照著看,看到眼花。
這種做法在第三週還撐得住,到第四週要跑 50 封信、比較五六個版本時就不行了。今天先把 trace log 做出來,再用它回頭看一件事:這二十天累積下來,派工到底都怎麼失敗的。
我把 Day 16 到 Day 18 跑過的所有結果重新統計,總共 175 個案件,涵蓋 Day 16 的最小派工、Day 17 的兩個 prompt 版本、Day 18 的三種拓樸,以及修正後的版本。
把每個案件的「該派誰」和「實際派了誰」比對,失敗分成四種:
| 失敗型態 | 次數 | 占比 |
|---|---|---|
| 多派(派了不需要的專員) | 21 | 12% |
| 漏派(該派的沒派) | 3 | 1.7% |
| 派錯人(派了錯的,該派的又沒派) | 0 | 0% |
| 重複派(同一位專員被派兩次) | 0 | 0% |
我原本預期的主角是派錯人和重複派工。結果這兩種一次都沒發生。
重複派工沒發生,我猜跟 prompt 裡寫了「同一位專員最多派 2 次,而且第二次必須換不同的參數」有關,不過我沒有做對照實驗,不能確定。派錯人沒發生則比較好解釋:只有兩位專員,而且職責差很遠,一個查訂單、一個查 FAQ,工具描述裡也寫了「不要用在商品知識問題」。兩個選項要選錯,難度比想像中高。
主要的失敗是多派。而多派的 21 次裡,有 11 次發生在客訴、優惠、無法分類這三種「應該轉人工」的信上——Day 17 已經討論過,主管仍然去查了資料,我認為這是對的,該改的是我的期望值。
扣掉那 11 次,真正的誤判只剩 10 次,而且集中在同幾封信。最典型的是這封:
我買的豆子烘焙日期是哪一天啊?另外豆子可以放冷凍嗎?
主管派了查單專員去訂單系統找烘焙日期。但訂單表裡沒有這個欄位,FAQ 裡才有——答案是「烘焙日期印在包裝側面」。它看到「我買的豆子」就往訂單的方向想,沒有想到這題的答案是一句政策說明。
這種錯誤 prompt 很難擋,因為從字面上看,問「我買的東西」去查訂單完全合理。
n8n 本身有執行紀錄,點進去可以看到每個節點的輸入輸出,這在除錯單一案件時很好用。但它回答不了這些問題:
這些都是「跨案件、看趨勢」的問題。執行紀錄是一筆一筆的,要回答趨勢問題得自己把它們倒出來。所以要另外記一份。
一個案件在流程裡會經過幾個階段,每個階段寫一列,整體長下圖這樣。
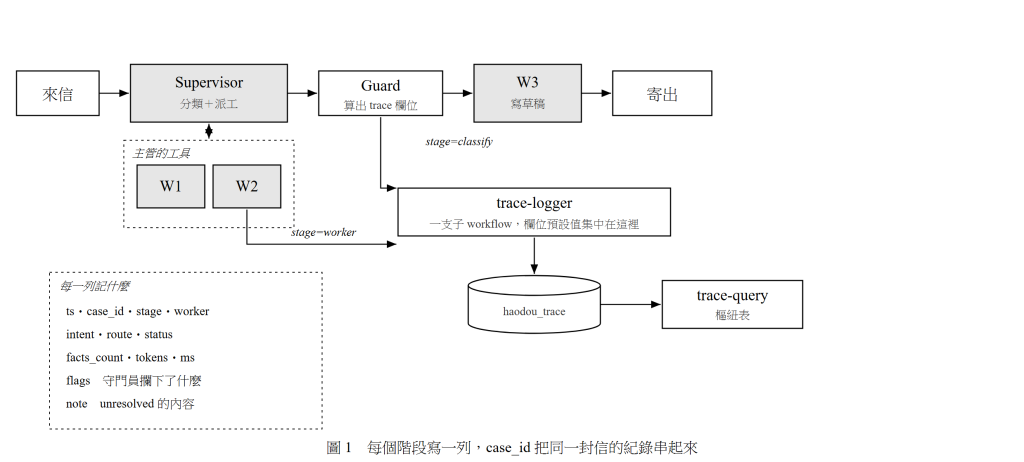
ts           寫入時間
case_id      案件編號,用來把同一封信的紀錄串起來
stage        classify(主管分類完)/ worker(專員回報完)
worker       哪一位專員
intent       分類結果
route        實際派給誰,沒派工就是 none
status       專員回報的 status,或 needs_human / auto
facts_count  這一步拿到幾筆事實
calls        模型呼叫次數
tokens       token 數
ms           耗時
flags        守門員攔下了什麼
note         unresolved 的內容
flags 這欄是整份 trace 最有用的一欄。前面幾天做的那些守門員檢查,結果原本只存在單次執行的輸出裡,看完就沒了。寫進 trace 之後,「主管捏造事實」這件事才從單一案件的觀察變成一個可以統計的數字。
三支 workflow:
lab-trace-table 建表,Data table 節點的 Create 操作,打開 Create If Not Exists,只跑一次。
lab-trace-logger 負責寫一列。入口是 Execute Workflow Trigger,接一個 Code 節點填預設值,再接 Data table 的 Insert。
欄位預設值集中在這支子 workflow,是整個設計裡最重要的決定:
const raw = $input.first().json;
const i = raw.body ?? raw;
const s = (v) => (v === undefined || v === null ? '' : String(v));
const n = (v) => (Number.isFinite(Number(v)) ? Number(v) : 0);

return [{
  json: {
    ts: new Date().toISOString(),
    case_id: s(i.case_id) || 'unknown',
    stage: s(i.stage) || 'unknown',
    worker: s(i.worker),
    intent: s(i.intent),
    route: s(i.route),
    status: s(i.status),
    facts_count: n(i.facts_count),
    calls: n(i.calls),
    tokens: n(i.tokens),
    ms: n(i.ms),
    flags: Array.isArray(i.flags) ? i.flags.join(',') : s(i.flags),
    note: s(i.note).slice(0, 300),
  },
}];
如果每個要寫 log 的地方都各自設定欄位,遲早會有人漏填,而漏填的那一欄會是空的,不會報錯。集中在一處,少填的欄位至少會有預設值。
lab-trace-query 把紀錄撈出來做樞紐。Data table 的 Get Rows 打開 Return All,後面接一個 Code 節點算出幾張表:依意圖分、依路線分、專員的 status 分布、有旗標的案件、沒派工的案件、回報零筆事實的案件。
主流程和 W1 各串一個 Execute Workflow 節點去呼叫 logger,後面再接一個 Code 節點,把原本的輸出原樣傳下去:
return [{ json: $('W1 Guard').first().json }];
沒有這個節點的話,Execute Workflow 的輸出會蓋掉原本的資料,整條流程就斷了。
第一個最嚴重:同步等待會把流程卡死。
Execute Workflow 節點有一個 Wait For Sub-Workflow Completion 選項,預設是開的。我照預設設定接上去,第一封信正常跑完,第二封信就整個停住——沒有錯誤訊息、沒有逾時、執行紀錄停在那裡不動。我去看代理的紀錄,從第二封信開始完全沒有新的模型呼叫。
原因是巢狀:主流程呼叫 W1(它是一個子 workflow),W1 裡面又呼叫 trace-logger(又一層子 workflow),每一層都在等下一層完成。層數一多就卡住。
把 Wait For Sub-Workflow Completion 關掉就好了。trace 本來就不需要等它寫完,主流程不靠它的回傳值。改完之後 30 封信順順跑完。
這也是我第一次遇到 n8n 卡住但完全不報錯。之後再接子 workflow,我會先問自己「下游需要它的回傳值嗎」,不需要就關掉等待。
第二個:複雜邏輯寫在運算式裡會安靜地失敗。
我一開始想在 Execute Workflow 的欄位對應裡直接算出 flags:
{{ Object.entries($json._audit ?? {}).filter(([,v]) => Array.isArray(v) ? v.length : v).map(([k]) => k).join(',') }}
結果寫進去的是 fake_dispatch,raw_collected_facts,而這兩個欄位當時一個是空陣列、一個是數字 3,照我的邏輯都不該被選中。我沒有繼續追究運算式是怎麼解析這段的,直接把邏輯搬回 Code 節點,在守門員裡算好一個 trace_flags 字串,運算式只寫 {{ $json.trace_flags }}。
運算式適合取值和簡單的字串拼接。超過一行的邏輯,放 Code 節點。
第三個:對不回案件的紀錄等於沒記。
第一次跑完,分類那一列的 case_id 全是 unknown。追下去發現入口的 Code 節點整理信件時,根本沒把 case_id 帶下去。
專員那一列更麻煩。工單編號原本是讓模型自己填的:
{{ $fromAI('task_id', '工單編號,格式 t_ 加任意英數字', 'string') }}
它填了 t_001、t_123456789 這種值,跟案件編號毫無關係,紀錄撈出來之後對不回是哪一封信。改成由程式產生:
{{ $('Normalize Email').first().json.case_id + '_w1' }}
工單編號這種東西沒有理由讓模型決定。能用程式算出來的欄位就別交給它。
把 30 封信重跑一次,trace 寫了 47 列:29 列分類、18 列查單。樞紐表長這樣:
{
  "by_intent": { "order_status": 10, "product_qa": 7, "return_refund": 5, "complaint": 3, "promo_coupon": 2, "other": 2 },
  "by_route": { "order_lookup": 10, "order_lookup+knowledge": 8, "knowledge": 6, "none": 5 },
  "worker_status": { "ok": 15, "partial": 2, "not_found": 1 },
  "flagged": [{ "case_id": "EV29", "flags": "rejected_facts" }],
  "no_dispatch": ["EV37", "EV42", "EV43", "EV46", "EV48"],
  "empty_result": [{ "case_id": "EV07", "worker": "order_lookup", "status": "not_found" }]
}
這幾行回答了我昨天要翻三個分頁才能回答的事。
no_dispatch 列出的五封確實都是客訴、優惠、改會員資料這類該轉人工的信,沒有該派卻沒派的。flagged 只有一封,守門員擋下了主管宣稱但專員沒回報的事實。empty_result 那封是客人沒給訂單編號、信箱也查不到訂單,回報 not_found 是正確行為。
端到端的成績是 24/30、危險錯誤 0,跟 Day 18 修正版的數字一致。加上 trace 之後行為沒有改變,這點也確認了。
我會在 Day 16 接第一位專員之前就先做 trace log。
理由不是它多難做——一張表加兩支子 workflow,兩個小時。理由是這二十天我做的每一個判斷,幾乎都需要「跨案件看趨勢」:prompt 改了之後捏造事實的次數有沒有變少、換 embedding 之後查不到的比例有沒有下降、哪一種意圖最容易出事。這些問題我都是靠 jsonl 和臨時寫的統計腳本回答的,而那些腳本是因為我自己寫了測試框架才有。
如果是直接在 n8n 上做、沒有外部框架的人,沒有 trace log 就只剩下執行紀錄,那等於只能一筆一筆看。
175 個案件的派工失敗統計:多派 21 次、漏派 3 次、派錯人 0 次、重複派工 0 次。我原本預期的失敗型態有兩種根本沒發生,主要問題是多派,而多派有一半是我的期望值定錯。trace log 用一張 Data table 加兩支子 workflow 就能做,每個階段寫一列、用 case_id 串起來。實作上踩到三個坑:子 workflow 同步等待會讓流程安靜地卡死、複雜邏輯寫在運算式裡會失敗、案件編號沒帶下去的紀錄等於沒記。
明天處理接力任務:一封信需要先查到結果、再依結果決定下一步要查什麼,這種情況目前的架構還做不到。


 iThome鐵人賽
 看影片追技術