
現在,我們已逐漸開始把以前做過的提案、會議紀錄這些真實工作資料交給 AI,讓它反過來研究:「我平常到底是怎麼做事的?」
比起坐在空白頁前努力回想自己的 SOP,真實工作留下來的資料,通常藏著更多我們自己早已習以為常的判斷。但真的把資料丟進去時的那一瞬間,你可能跟我一樣突然遲疑了一下:提案封面上有客戶 Logo,會議紀錄裡有人名、Email,有些頁面寫著報價,有些討論甚至包含還沒對外公布的產品方向。這些,真的可以拿來訓練我的 AI 分身嗎?好像不太妥當?
如果我的目的只是讓 AI 學會「我怎麼做提案」,它真的需要知道客戶叫什麼名字、這個案子報多少錢、明年三月到底要推出什麼新功能嗎?大部分基於商業機密或個資的考量下,其實不該讓 AI 知道。
所以上一篇簡單的有提到「真實資料先去識別化,再交給 AI」之,這一篇我們就來把這件事補完整,而且先從一般人今天就做得到的方法開始。
講到「去識別化(De-identification)」,大家第一個想到的通常是把姓名拿掉。例如原本寫著「王小明表示,目前使用者最大的問題可能不是健康知識不足」,改成「客戶 PM A 表示,目前使用者最大的問題可能不是健康知識不足」。
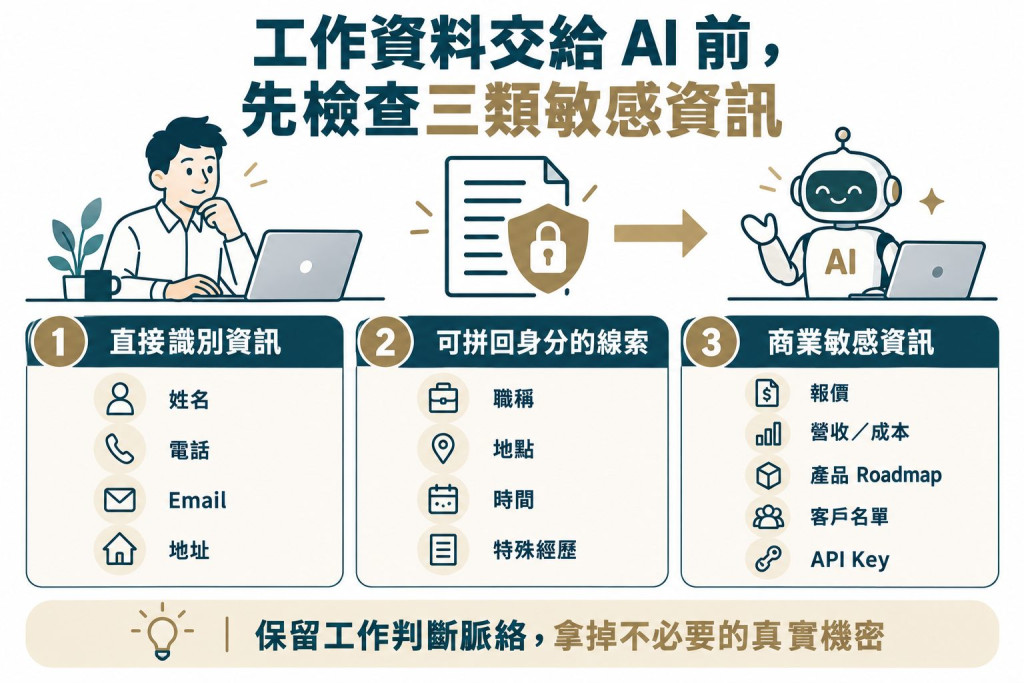
這當然是一個開始。姓名、電話、Email、地址這些可以直接讓人知道「這是誰」的資訊,通常都應該優先處理。
麻煩的是,有時候文件裡連名字都不用出現,我們還是猜得到是在講誰。
例如:「去年從 Google 回台灣,目前是公司唯一負責醫療產品的副總。」
一句姓名都沒有,但如果你剛好認識這家公司,甚至只是把幾個關鍵字拿去搜尋,很可能就拼得出來。這類資訊單獨看起來似乎沒什麼,職稱、地點、時間、特殊經歷幾個線索放在一起,就可能慢慢把某個人拼回來。
所以我們還得要小心:
不只要注意最明顯要去識別的「名字」,還要找那些「可以把人拼回來的線索」。
工作資料裡還有另一類資訊更容易被忽略。假設文件裡已經完全沒有人名、電話、Email,只剩下這段話:「公司預計明年三月推出新產品,目前開發預算為 480 萬。董事會正在討論是否收購其中一家主要競爭對手。」
從「能不能辨識出某一個人」來看,這段資料可能很乾淨,但如果這些資訊還沒公開,它依然可能是敏感的公司資料,尤其你待的如果是大公司。
所以這一篇雖然從「去識別化」開始,實際處理工作文件時,需同時檢查兩件事情:第一,這些資料會不會讓人知道是在講誰;第二,就算完全猜不出是誰,這件事情本身是不是也不該讓外部知道。
像是報價、營收與成本、未公開產品 Roadmap、客戶名單、內部策略、帳號密碼、API Key,都不一定屬於個人識別資訊,但一樣需要處理。
《R森小叮嚀》
去識別化也不是一張「通行證」。如果公司規範、客戶合約或 NDA 原本就禁止把某類資料提供給外部 AI 服務,那就不要因為自己改過人名,便認為資料從此可以任意使用。拿不準的時候,先確認公司的資訊安全規範,再決定這份資料能不能用。
既然擔心資料外洩,那是不是乾脆全部刪光最安全?
別忘了上一篇為什麼要把這些資料拿給 AI。我們希望它從資料裡學到自己的工作方法,如果把所有背景條件一起刪掉,AI 最後看到的只會剩下一堆沒有前因後果的結論。
假設原本的會議紀錄寫著:「因為這次專案的研究預算只有 80 萬,我判斷不適合做大型量化調查,先安排幾場使用者訪談確認問題。」
如果看到「80 萬」屬於敏感資訊,就直接改成:「因為這次專案的研究預算是__,我判斷不適合做大型量化調查。」AI 雖然看不到真實預算了,卻也很難理解後面的決策。
比較適合的版本會是:「因為這是一個研究預算有限的小型專案,我判斷不適合做大型量化調查,先安排幾場使用者訪談確認問題。」
80 萬這個精確數字消失了,但「資源有限 → 不適合大型量化研究 → 改採成本較低的質化方式」這條判斷脈絡仍然存在。
保留工作判斷需要的脈絡,拿掉不必要的真實機密。我的 AI 分身要學的是我為什麼這樣工作,它不需要順便把客戶的身家一起記起來。
知道原則之後,我們先從最陽春的方法開始。如果今天只有一份提案、幾份會議紀錄,其實不需要立刻安裝一堆新工具。Word、Google Docs、Notion 這些原本就在使用的文件工具,很多時候已經夠用了。
先做一件很簡單的事情:原始檔保留起來,另外複製一份專門給訓練 AI 分身使用的版本。
例如原本是:健康飲食App_會議紀錄.docx
另外複製一份:健康飲食App_會議紀錄_訓練AI版.docx
接下來所有修改都只發生在訓練 AI 版。這個檔名跟習慣看起來很笨,卻可以避免處理到一半才發現連原始紀錄都被自己一起改掉,就真的「可是瑞凡,回不去了」。
那個…不要問我是怎麼知道的,很可怕
接著開始整理文件,大致只需要三招來判斷。
姓名之外,Email、電話、個人地址、帳號資料都很常出現在會議紀錄裡。如果 AI 分析我怎麼做提案時根本用不到,就沒有留下來的必要。
例如檔案的最開頭原本寫著:
「聯絡人:Rose Tang/Email:rose@cooldesign.com/電話:09xx-xxx-xxx」
這種內容整段刪掉即可。沒有必要為了一個對工作方法毫無影響的 Email,還特地幫它發明一組假 Email,沒事找事做。
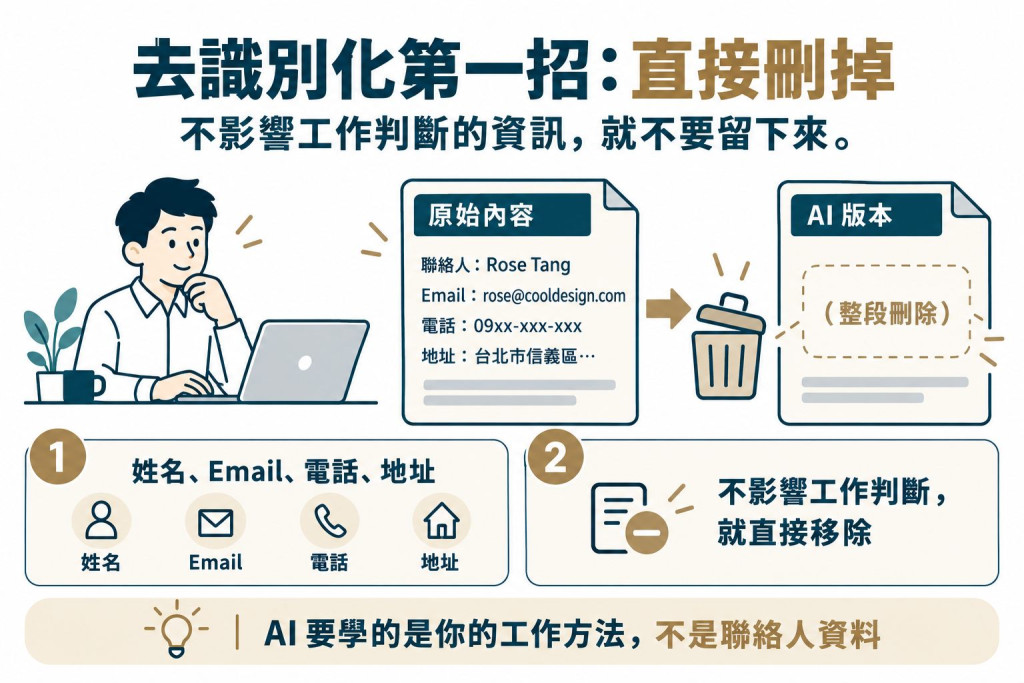
判斷的依據很簡單:刪掉這個資訊之後,分身還看不看得懂我為什麼做出後面的決策?如果完全不影響,就可以拿掉。
有些資料雖然不能留下真名,但「這個人扮演什麼角色」對決策脈絡仍然重要。例如原本寫:「Vicky 認為應該直接增加更多 AI 健康建議功能。」
如果改成「某人認為應該直接增加更多 AI 健康建議功能」,我們其實也失去了一些重要資訊。某人到底是使用者、工程師、客戶老闆,還是剛好路過的隔壁同事,影響很大。
這時可以改成:「客戶產品負責人認為應該直接增加更多 AI 健康建議功能。」或者「客戶 PM A 認為應該直接增加更多 AI 健康建議功能。」
姓名消失了,但這個意見來自哪一種角色仍然被保留下來。
所以像「周大森 → 客戶 PM A」、「享健科技 → 客戶 A」、「VR 健身環 → VR 類健康產品 A」,都可以使用這種方式處理。這類把真實識別資訊替換成其他代號的做法,也常被稱為假名化(Pseudonymisation)。
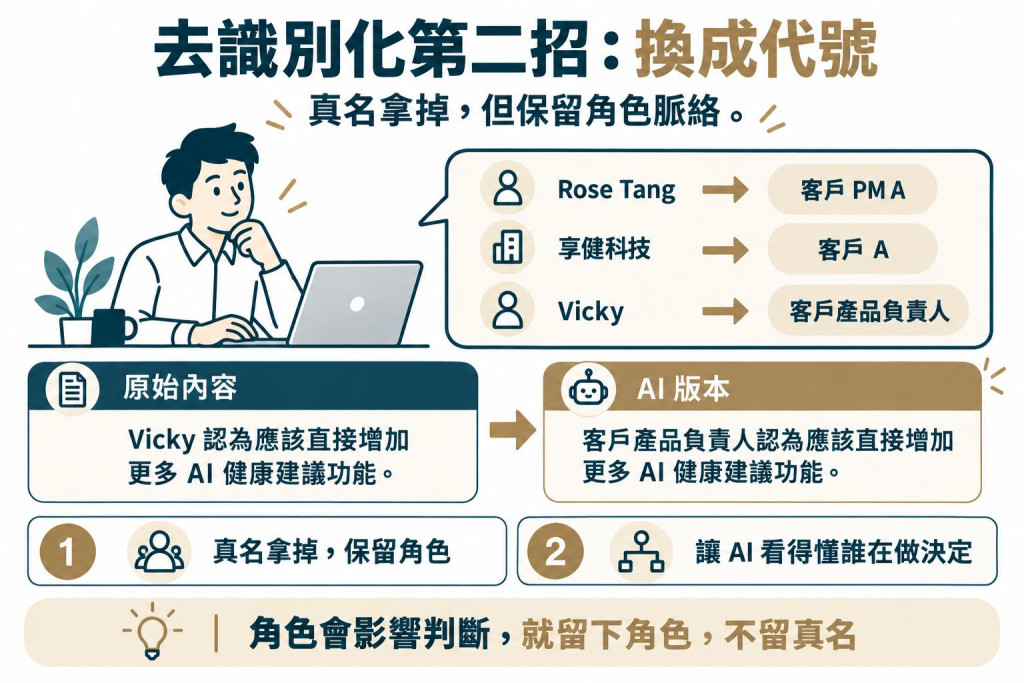
原則只要記住:真名幾乎都可拿掉,但如果角色會影響到你的 AI 分身學習你工作方式的效果,就把角色留下來。
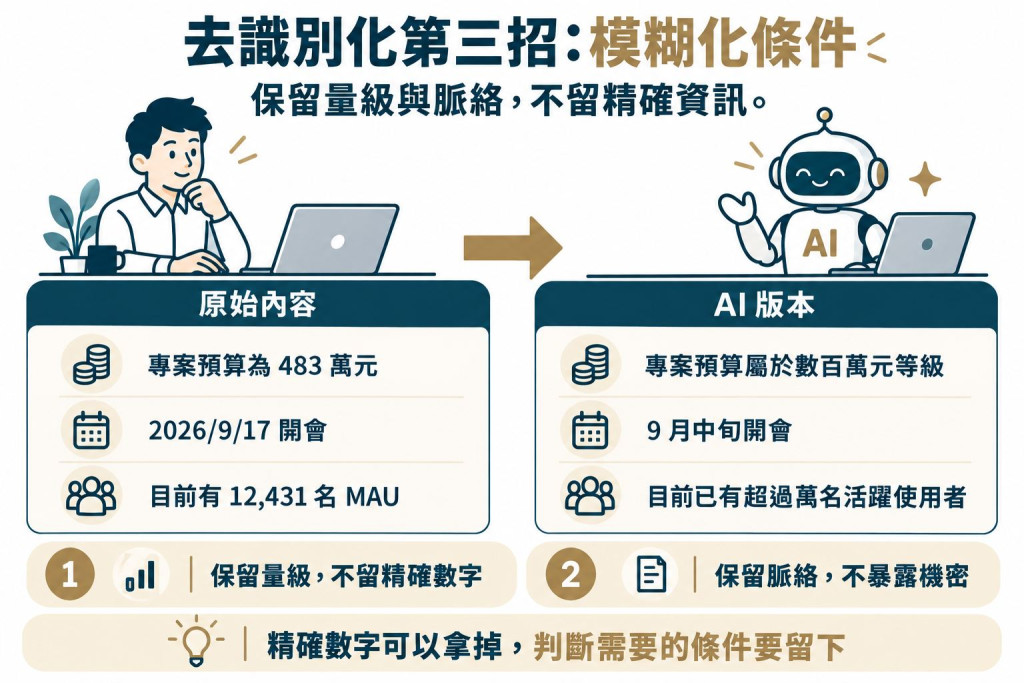
另外一種很常見的情況是:「這個資訊對理解事情有用,但不用精確到這個程度。」
例如「專案預算為 4,830,000 元」,如果真正影響我判斷的是「這是一個資源有限的專案」,那麼可以改成「專案預算屬於數百萬元等級」,甚至抽象化成「這是一個預算有限的中型專案」。
「2026 年 9 月 17 日下午兩點開會」可能可以改成「9 月中開會」;「App 目前有 12,431 名月活躍使用者」如果精確數字沒有影響工作方法,也可以改成「App 已經有超過萬名的活躍使用者」。
如此一來,就算真實的數字被模糊了,但 AI 理解事情需要的「量級」與限制條件還在。
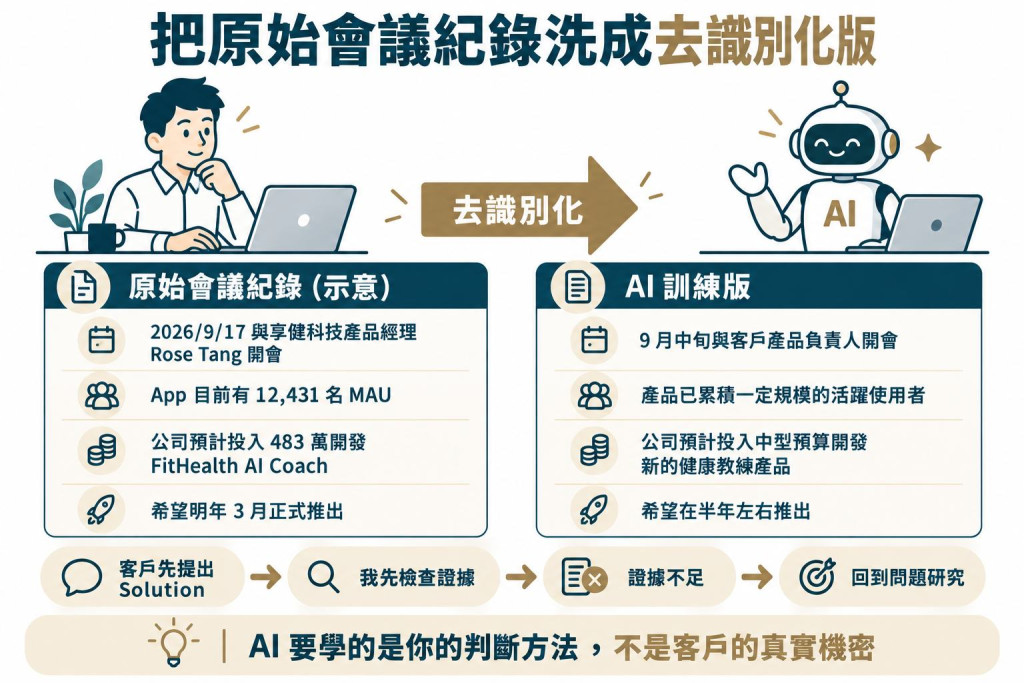
假設上一篇健康飲食 App 專案中,有一段這樣的會議紀錄。以下內容只是示意:
2026/9/17 下午兩點與享健科技產品經理 Rose Tang 開會。目前 App 有 12,431 名 MAU,公司預計投入 483 萬開發 FitHealth AI Coach,希望明年 3 月正式推出。Rose 認為目前最大的問題,是使用者不知道自己應該吃什麼,因此希望優先增加 AI 飲食建議功能。
這一小段其實已經混進不少資訊:公司名稱、人名、精確日期、精確使用者數、預算、尚未公開的產品名稱,以及預計上市時間。
如果我目的只是讓 AI 分身學會:「面對客戶已經提出的 Solution,我通常會怎麼判斷?」這些資訊大部分都可以去識別化。
處理之後,可能會變成:
9 月中旬與客戶產品負責人開會。目前產品已經累積一定規模的活躍使用者,公司預計投入中型預算開發一項新的健康教練消費級產品,並希望在半年左右推出。客戶產品負責人認為,目前最大的問題是使用者不知道自己應該吃什麼,因此希望優先增加 AI 飲食建議功能。
接下來原本的會議紀錄可能繼續寫:
我方行銷研究結果,顯示目前還沒有足夠證據證明「缺少飲食建議」是真正問題,所以先沒有直接進入功能規劃,改從使用者為什麼無法持續使用產品開始研究。
你會發現,真正想拿去教 AI 的資訊幾乎完整留下來了:
客戶先提出一個 Solution,我沒有直接接受,因為目前證據不足,所以把問題往前重新研究。
這才是我們希望工作分身學會的東西,至於這場會議究竟是哪一天、客戶叫什麼、預算精確到多少,對這項能力沒有太大的幫助,就沒必要揭露。
實際操作時,可以先整理一張自己的替換表:
| 原始資料 | AI 版本 |
|---|---|
| 享健科技 | 客戶 A |
| Rose Tang | 客戶 PM A |
| FitHealth AI Coach | AI 健康功能 |
| 483 萬元 | 數百萬元預算 |
| 2026/9/17 | 9 月中旬 |
接著利用 Word、Notion、Google Docs 等工具的搜尋功能,把這些內容逐一找出來處理。Word 可以直接使用「尋找與取代」,Notion 也可以先利用頁面搜尋把同一個關鍵字的位置找出來。
《R森小叮嚀》
我不太建議在第一次處理時看到名字就直接「全部取代」。同一個名稱、代號或數字,在不同地方可能代表不同事情。尤其是在敏感資料上,比起省掉那幾十秒,一個一個確認反而比較安心。
做到這裡還不要急著把文件丟給 AI 分身訓練。
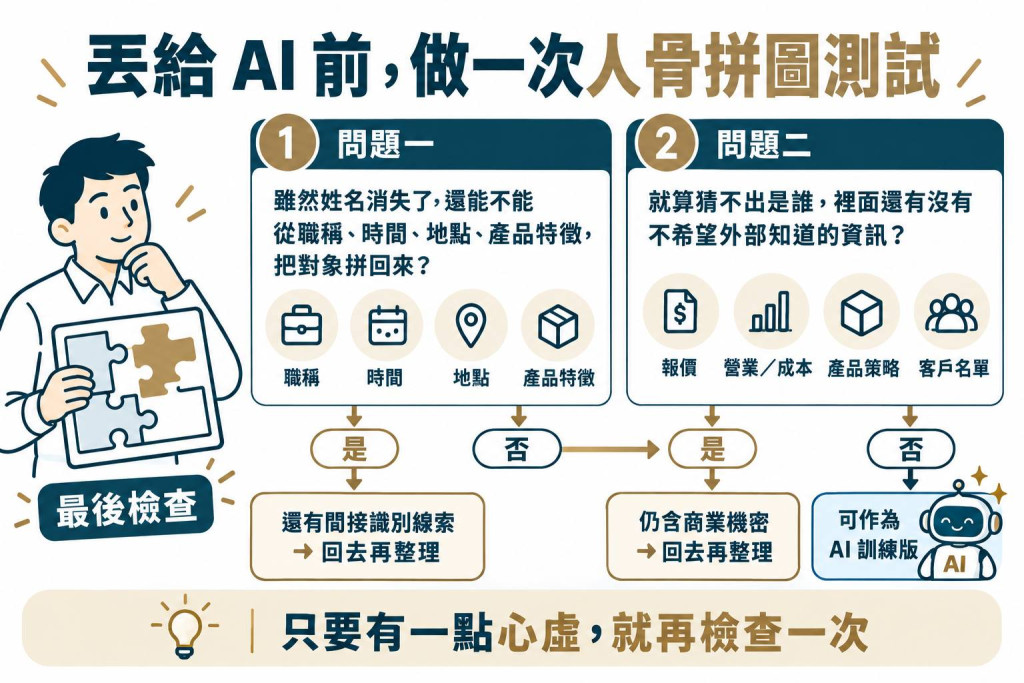
我會做一次最後檢查,我自己把它戲稱叫「人骨拼圖測試」。
把自己暫時想像成一個知道這個產業,但沒有參與這個專案的人,然後問:
雖然姓名都消失了,我能不能從職稱、時間、地點、產品特徵,把這個人或這家公司,從一堆骨頭中拼回來?
如果答案還是可以,而且不難,就代表還有一些間接識別線索需要再處理。
接著再問自己第二題:
就算我完全猜不出這是誰,裡面還有沒有資訊是我不希望競爭對手看到的?
第二題專門檢查商業機密。只要其中一題讓自己覺得有點心虛抖抖的,我就會再回去整理一次。
如果只是偶爾處理幾份工作資料,我認為真的不用一開始把事情搞得很複雜。建立一份給 AI 用的副本,沒必要揭露的資料都刪掉,角色是重要脈絡的話就換代號,條件是重要的話就改成區間或模糊描述,最後自己再重新讀一次把關,看還能不能把真實對象拼回來,也看看有沒有留下不該外流的公司機密。
這樣的作法,就已經比一般人直接把原始檔送進 AI ,來得有警覺得多了。

非常認同!!
去識別化這議題很重要,加上ai時代來臨,個資數據已是這時代的黃金資產,個人與企業都必須重視,但往往都是出事了才知道重視....我待過的公司沒一家例外=.=
"我待過的公司沒一家例外"
噓... 你知道的太多了
 iThome鐵人賽
 看影片追技術
看更多
