
🌐 幾個 Agent 組隊,先分出去的是查資料、出意見的工作,動手改的最好只留一個。溝通要把交辦和交回寫清楚:對方沒參與前面的討論,派工要講目標和範圍,回報要附上偏離和沒驗的地方;會改變別人手上工作的發現,才值得直接傳。信任不靠對方自己說:另一個 Agent 寫的字都當外人寫的,對方是誰、替誰做事要驗得出來,說做完了也要自己驗收。交給別的團隊、別家公司的 Agent,雙方共用的安排越少,這些越要事先講好。
昨天在 Day 27|番外篇:全公司導入 Agent,該從哪一步開始?,我們看 Cloudflare 和 Uber 怎麼讓幾千個人一起用 Agent,最後是我自己的做法:開發和測試分開推。
今天也是番外篇。昨天是很多人各自用自己的 Agent,今天換成 Agent 跟 Agent 之間:一個 Agent 要把工作交給另一個 Agent,兩邊要先講好什麼,主要會以科普為主,介紹一下
快速回顧一下:
act 欄位講 delegation:token 裡同時寫授權的使用者和代他做事的 Agent。今天看 Uber 怎麼把這件事做到每一站。標題的開放世界,指的是 Agent 一步步走出自己的 Harness:先在同一個 Harness 裡組隊,再把工作交給公司裡別的團隊部署的 Agent,最後是網路上互不認識的 Agent。一個 Agent 自己做的時候,前面做過的決定還查得回自己的對話和紀錄;交給另一個 Agent,它沒參與前面的討論,該知道的就得另外交代。再交到別人管的系統,連進度怎麼查、誰准它做、結果怎麼驗,都不能假設雙方做法一樣。所以這裡的遠近,看的是雙方共用多少安排:同一套權限、同一張工作清單、同一份紀錄,越往外共用的越少,要事先講好的越多。
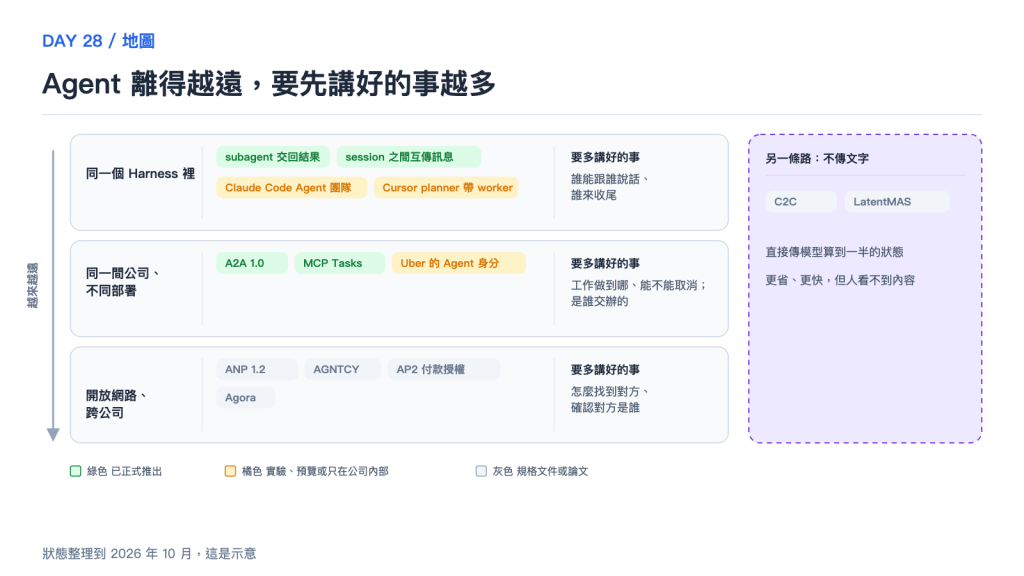
圖:由上到下,Agent 離得越來越遠。同一個 Harness 裡有 subagent、session 之間互傳訊息、Claude Code 的 Agent 團隊、Cursor 的 planner 帶 worker;同一間公司的不同部署有 A2A 1.0、MCP Tasks、Uber 的 Agent 身分;開放網路有 ANP、AGNTCY、AP2、Agora。每一條右邊是那一層要多講好的事。最右邊的 C2C、LatentMAS 不傳文字,直接傳模型算到一半的狀態。綠色已正式推出,橘色是實驗、預覽或只在公司內部,灰色是規格文件或論文。這是示意,實作要照自己的工具和環境調整。
下面照標題的順序走:先看組隊,再看溝通,最後看互相信任,每一件都由近講到遠;溝通那部分會岔出去,看一條不用文字的路。最後整理成自己的 Harness 可以怎麼開始。
分工的好處很直接:幾個 Agent 同時查不同方向,大量的搜尋結果和 log 留在各自的 Context,主對話不會被塞滿,這一半 Day 13 講過了。代價在最後:總要有人把各自的結果核對、整合起來。查資料的結論可以並排比較,矛盾的再判斷;改程式不一樣,一個 Agent 改掉的東西,可能正是另一個 Agent 依賴的,而它當初為什麼這樣改,對方看不到。所以我會先把查資料、review 這類工作分出去,動手改的留給一個 Agent。
這個判斷,兩篇看起來唱反調的文章其實都支持。Cognition 的 Walden Yan 在 2025 年 6 月寫了〈Don't Build Multi-Agents〉,第二條原則是「Actions carry implicit decisions, and conflicting decisions carry bad results」:每個動作背後都藏著決定,分出去的 Agent 看不到彼此的決定,做出來就會打架。同一週 Anthropic 發了 Day 13 看過的研究系統,多 Agent 在他們的研究評測上高了 90.2%;但同一篇也寫,所有 Agent 要共用同一份 Context、或彼此相依很多的工作,現在還不適合拆,例如大部分 coding 工作能同時進行的部分比研究少。
LangChain 的 Harrison Chase 幾天後寫了〈How and when to build multi-agent systems〉,把這兩篇放在一起看,說它們其實有很多共同點,其中一個是以「讀」為主的多 Agent 比以「寫」為主的容易:寫要平行,得先把 Context 傳給每個 Agent,再把各自的產出合得起來。Anthropic 的研究系統就是這樣分的,查資料分給好幾個 subagent,最後的報告由主 Agent 一次寫完。
效果也看工作本身。Google 和 MIT 的研究者在〈Towards a Science of Scaling Agent Systems〉跑了 260 種設定:拆得開的金融推理,由一個 Agent 統籌的多 Agent 架構比單 Agent 好 80.8%;一步接一步的規劃,各做各的多 Agent 架構反而差 70.0%。他們也看到,沒有一個 Agent 集中核對的架構,錯誤比較容易一路傳下去。
真要讓好幾個 Agent 一起寫,整合的工作就落在 Harness 身上。Cursor 2026 年 2 月的研究文章最早讓大約 20 個 Agent 共用一個協調用的檔案、搶鎖,大部分時間都在等鎖,整體速度只剩 1 到 3 個 Agent 的程度;後來改成由 planner 拆工作,每個 worker 在自己的 repo 副本裡做完一件。7 月的另一篇照 835 頁的 SQLite 手冊用 Rust 重寫一個資料庫,同一個模型放在舊版和新版 Harness 上比,舊版頭兩小時就有 68,000 個 commit,衝突累積到 7 萬多次才被暫停;新版四小時下來,衝突不到 1,000 次。做得到,只是拆範圍、排順序、處理衝突,每一樣都要另外設計。
Cognition 十個月後的〈Multi-Agents: What's Actually Working〉也說,好幾個 Agent 平行寫 code 的做法還很少人真的在用;行得通的是寫入只留給一個 Agent,其他 Agent 出意見,例如換一個乾淨 Context 的 reviewer 來看,Devin Review 平均每個 PR 抓到 2 個 bug,約 58% 是嚴重的。OpenAI 的〈A practical guide to building agents〉更保守,建議先把一個 Agent 用到底,原文是「maximize a single agent's capabilities first」;指示複雜到照不好,或相似的工具多到常選錯,才拆成好幾個 Agent。
所以我的起點是:先看一個 Agent 哪裡做不好,再決定要不要拆;要拆,先分查資料、出意見的工作,動手改的留一個。真的需要好幾個一起改,就照 Cursor 那樣先切開範圍,也準備好處理衝突。
決定分出去之後,下一個問題是:另一個 Agent 沒參與前面的討論,要交給它哪些東西,回來時又要交代哪些事?派工和回報,都在決定對方下一步看得到什麼。派工沒寫到的範圍,被派出去的 Agent 只能自己猜;收報告的一方要接著判斷,就得知道結論在什麼條件下成立、哪裡偏離了原本的安排、還有哪些沒驗。中間每多一次轉述,就多一次漏掉或講錯的機會。
派工要給的四樣東西,Day 13 看過了。另一件要決定的是帶多少前面的對話過去。OpenAI Agents SDK 的 handoff 是把對話整個交給另一個 Agent 接手,預設對方看得到前面全部的對話,想少帶一點就設 input_filter,例如拿掉所有工具呼叫的紀錄。文件也提醒,已經抄進一般訊息裡的工具參數和結果,不會跟著被遮掉;接手的 Agent 和它背後的模型供應商,都要當成會收到這段歷史。Cognition 那篇的第一條原則是要傳就傳完整的過程;Claude Code 的 subagent 只交回摘要,為的是保住主對話的 Context。兩邊之間,我會帶足夠對方接著判斷、而且可以給它看的部分。
回報那一半,Cursor 的 worker 做完會交一份報告給派工作的 planner,除了做了什麼,還有注意事項、疑慮、偏離計畫的地方和新發現。這跟 Day 17 要 Agent 交回時附上用了哪些線索、排除了什麼,是同一件事:改了什麼,看 repo 就知道;為什麼這樣改、哪裡沒把握,只有報告寫得出來。
要精確保留的內容,最好別再轉述一次。LangChain 的 benchmark 比過兩種架構:supervisor 由一個主 Agent 收下其他 Agent 的回覆,再自己回給使用者;swarm 讓每個 Agent 都能直接回使用者。supervisor 稍差,他們看紀錄發現是主 Agent 轉述時講錯,直接拿傳話遊戲(telephone)來比喻。改法之一是給主 Agent 一個 forward_message 工具,把其他 Agent 的回覆原封不動轉出去;連同其他幾項調整,supervisor 在這個 benchmark 上進步將近 50%。Anthropic 的研究系統則是讓 subagent 把成果存到外面,只把位置交回主 Agent。
拼起來是這張表:
| 什麼時候 | 寫什麼 | 誰這樣做 |
|---|---|---|
| 派工時 | 目標、輸出格式、該用的工具和來源、做到哪裡為止 | Anthropic 的研究系統(Day 13) |
| 換手時 | 接手的 Agent 看得到多少前面的對話 | OpenAI Agents SDK 的 input_filter |
| 交回時 | 做了什麼、注意事項、疑慮、偏離計畫的地方、新發現 | Cursor 的 worker |
| 原始資料 | 存到外面,只交回位置;要原文就原封不動轉出去 | Anthropic 的研究系統、LangChain 的 forward_message |
有些發現等到最後交報告就太晚了:另一個 Agent 此刻還在照舊的假設做,等報告回來才知道,已經白做一段。例如幾個 Agent 各自追同一個 bug 的不同假設,或前端、後端、測試各改一層,全部繞回主 Agent 轉述,主 Agent 就成了瓶頸。讓隊友直接傳訊息,就是讓它在做的時候就收到會改變下一步的發現;代價是收的一方也要花 Context 處理這些訊息。
Claude Code 的 Agent 團隊就是這種做法,目前是實驗功能,要設定 CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 才會打開。一個 session 當隊長(文件叫 team lead),負責拆工作、分配、最後彙整;其他 session 是隊友(teammate),各有自己的 Context,彼此可以直接傳訊息,不必經過隊長。大家共用一張工作清單,好幾個隊友同時搶同一件工作時,用檔案鎖擋住。
文件也講明了代價:每個隊友都是一個獨立的 Claude,token 用量跟隊友人數一起長。適合研究、review、彼此獨立的新功能;一步接一步的工作或要改同一個檔案,用單一 session 或 subagent 比較好。
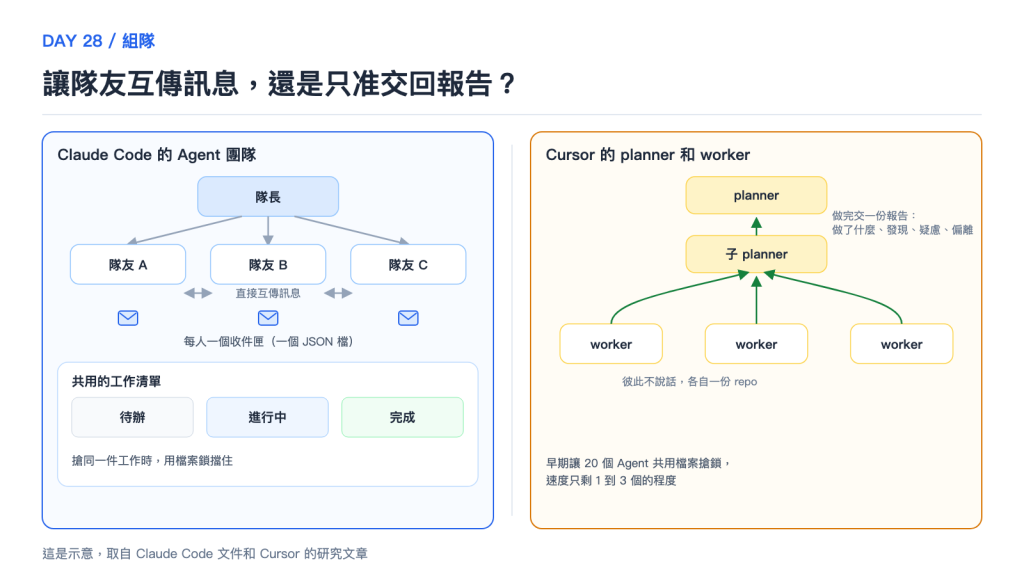
圖:左邊是 Claude Code 的 Agent 團隊:隊長往下派給三個隊友,隊友之間直接互傳訊息,每人一個收件匣(一個 JSON 檔),下面是共用的工作清單,分待辦、進行中、完成,搶同一件工作時用檔案鎖擋住。右邊是 Cursor 的 planner、子 planner 和三個 worker:worker 彼此不說話、各自一份 repo,做完交一份報告往上送,寫做了什麼、發現、疑慮、偏離。底下是 Cursor 早期的教訓:20 個 Agent 共用檔案搶鎖,速度只剩 1 到 3 個的程度。這是示意,實作要照自己的工具和環境調整。
Cursor 走的是另一個方向,原文寫 worker「don't communicate with any other planners or workers」,有發現就寫進報告交回 planner,由 planner 決定要不要改派工作。哪一種比較好,還沒有定論:Cognition 的第二篇收尾寫「The open problems are all communication problems」,列的問題裡有兩個就在講這件事,子 Agent 的發現怎麼讓兄弟 Agent 知道、怎麼傳 Context 又不把對方淹沒。
我的判斷是,等最後的報告會讓別人重做,才讓隊友直接說話;互相反駁假設、跨層一起改,這種需要。直接說話的時候,誰負責拍板、誰負責彙整,還是要先定好。彼此獨立的工作,交回一份寫清楚的報告就夠。
上面這些安排,都還在同一套系統裡:工作清單、進度、誰能取消,是 Harness 自己的資料。交給別的團隊部署的 Agent,就不能假設還看得到這些:它是另一個服務,裡面用什麼模型、什麼框架你不知道,一件工作可能跑好幾個小時,中途還可能回頭跟你要資料。對方怎麼排程、怎麼執行,可以留在它那邊;發出工作的一方要知道的,是怎麼查進度、怎麼補資料、怎麼取消。這些原本是 Harness 內部的資料,現在要變成雙方都認得的欄位。
現在有兩份規格在做這件事。MCP 在 2026 年 7 月 28 日的版本把 Tasks 從實驗功能搬成正式的擴充功能:叫一個工具做比較久的事,server 可以先回一個 task ID,client 之後拿它查進度、補對方要的資料、取消。A2A(Agent2Agent)管的是兩個各自獨立、看不到對方內部的 Agent,官網自己寫明它「Not a sub-agent or tool-call protocol」,所以工作狀態多了幾種:對方收到了還沒開始、要先拿到額外的授權,或是不接這件工作。
A2A 由 Google 發起,2026 年 3 月出了 1.0;IBM 原本推的 ACP 在 2025 年 8 月併了進來,2026 年 8 月 A2A 加入 AAIF,跟 MCP 放在同一個基金會底下。也有人不看好:Credal 在 2026 年 3 月的文章認為 A2A 推不起來是兩件事,用得上的情境不多、實作的負擔又重。這篇寫在 1.0 和 MCP 7 月那次更新之前,但「兩套協定都要維護值不值得」這個問題還在。
我會看雙方要交換什麼來選。對方提供的是一個會跑很久的工具,你只要查進度、補資料、取消,包成 MCP 工具、用 Tasks 就夠;要把對方當成獨立的 Agent 來往,連接不接、要不要先授權都要談,A2A 多出來的那幾種狀態才用得上。
再往外到網路上,雙方原本互不認識,要先找到對方、連得上,再約定訊息怎麼寫。下面幾個各處理其中一段:
這一層還在早期,我會先當成看方向的材料。
除了約定怎麼交辦,研究者也在問另一件事:Agent 之間交換的內容,一定要先寫成文字嗎?到目前為止,Agent 之間傳的都是文字,頂多再加檔案和結構化資料。好處是人看得懂,要檢查也有地方下手;壞處是兩邊都要多做一次:傳的一方把想法寫成文字,收的一方再從頭讀一遍。2025 年 6 月有一篇立場論文直接問〈Why do AI agents communicate in human language?〉:模型內部是在高維的向量裡運算,壓成人類的語言會掉資訊。
有幾篇研究就試著不傳文字,改傳 Day 8 講過的 KV-cache,或模型內部的 hidden state。這樣省掉一次寫和讀,代價是收的模型用到的東西,人不一定看得到:
數字很漂亮,可是分數變高,還要另外確認傳過去的確實是這一題的資訊。2026 年 8 月的一篇檢驗把傳過去的 cache 換成另一題的、全部歸零的、或隨機的,看分數會不會掉:LatentMAS 原本的傳法一換掉就壞,代表內容確實傳過去了;C2C 公開的那個轉換模組,換成另一題的 cache 分數幾乎不變,看不出傳過去的是這一題的內容。
〈When Latent Agents Lie〉(2026 年 6 月)看的是安全:一個惡意的 Agent 改掉人看不到的那份狀態,跟著交出去的那句結論還是很正常,答案卻整個壞掉,只檢查文字的機制抓不到。替傳過去的狀態加簽章,擋得住交出去之後半路被換掉的;Agent 自己交出壞掉的狀態,簽章就擋不住。
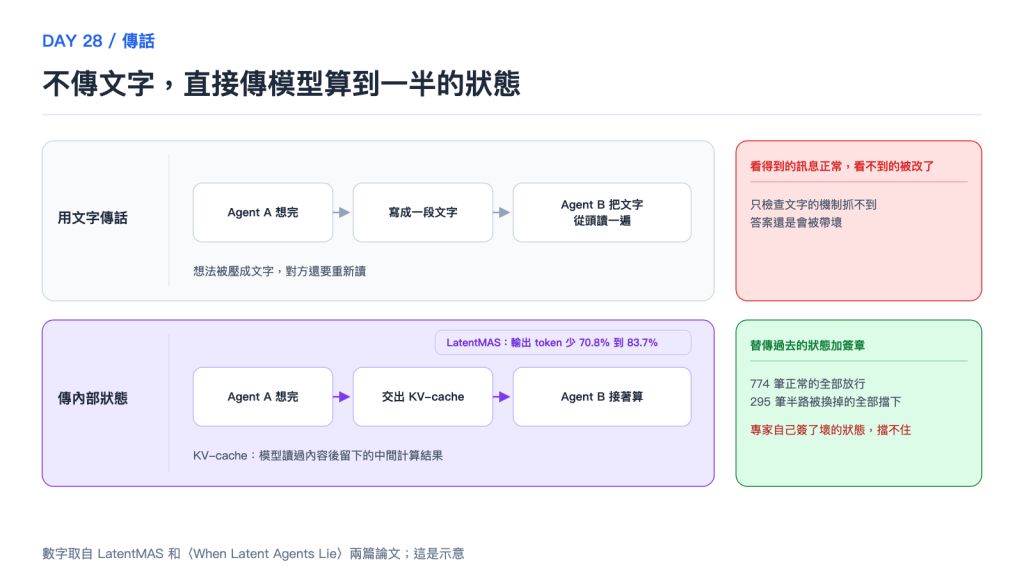
圖:上面一條是用文字傳話:Agent A 想完,寫成一段文字,Agent B 把文字從頭讀一遍。下面一條是傳內部狀態:Agent A 想完,交出 KV-cache,Agent B 接著算;LatentMAS 的輸出 token 少 70.8% 到 83.7%。右邊上面是風險:看得到的訊息正常、看不到的被改了,只檢查文字的機制抓不到;下面是解法:替傳過去的狀態加簽章,774 筆正常的全部放行,295 筆半路被換掉的全部擋下;專家自己交出壞掉的狀態,簽章擋不住。這是示意,實作要照自己的工具和環境調整。
這些做法都要直接讀寫模型內部的 KV-cache 或 hidden state。一般透過廠商的 API 用模型,送進去、拿回來的是文字和圖片這些內容,拿不到內部狀態,所以通常要自己架開源模型才做得到。對大部分在刻 Harness 的人,這一段現在還是研究。它提醒的是:交過來的那句話看起來正常,收的模型實際用到的、人看不到的那部分不一定正常,原本只檢查文字的做法就不夠了。
不管交來的是文字、檔案還是內部狀態,收的一方都得先確認兩件事:現在是哪個 Agent 在呼叫,它又代表誰、這次能做什麼。每轉一手,這兩件事都要能驗證地傳下去,收的一方才能照自己的規則決定要不要做;到了不同管理者之間,還得先講好接受誰發的身分證明。
在同一個 Harness 裡,誰傳的話由 Harness 標出來。Claude Code 的隊友傳來的訊息,會告訴收的一方「這是另一個 Claude session 傳的,不是使用者」,所以它不能替使用者核准權限,被擋下的動作也不能轉給別的隊友代做。同一台電腦上不在同一隊的 session,用 session 之間互傳訊息的功能傳來的話,一樣不能拿來核准任何東西,也不能改設定。
跨出 Harness,就沒有人替你標了。Uber 在 2026 年 5 月的文章開頭舉了一個例子:值班工程師用 Oncall Agent 處理一個告警,Investigation Agent 查完判斷是告警門檻設錯了,就把工作交給 Monitoring Agent 開 PR 改門檻。PR 上只看得到 Monitoring Agent,查不到是哪位工程師要求的。工作經過好幾站,每一站的系統只看到一個籠統的服務身分,下游只知道「有個服務呼叫了 API」,稽核紀錄拼不起來,下游原本設好的細部權限也用不上。
Day 22 講過 RFC 8693 的 act 欄位,也說各家還沒有共同的實作。Uber 是自己做了一套,而且每一站都換:每個 workload(跑 Agent 的那個服務)先跟開源的 SPIRE 拿一張簽過名的身分證明。Agent 要呼叫下一站時,SDK 拿著這張證明和收到的 token,去專門發 token 的服務(STS)換一張新的;STS 先查 Agent Registry,確認這個 Agent 登記過可以跑在這個 workload 上。新的 token 只給下一站用、幾分鐘就過期,裡面寫著整串經手的人和 Agent,例如 [user1, oncall-agent, investigation-agent];到了 MCP Gateway,它看整串經手鏈,再決定能不能呼叫這支工具、要不要遮掉個資。
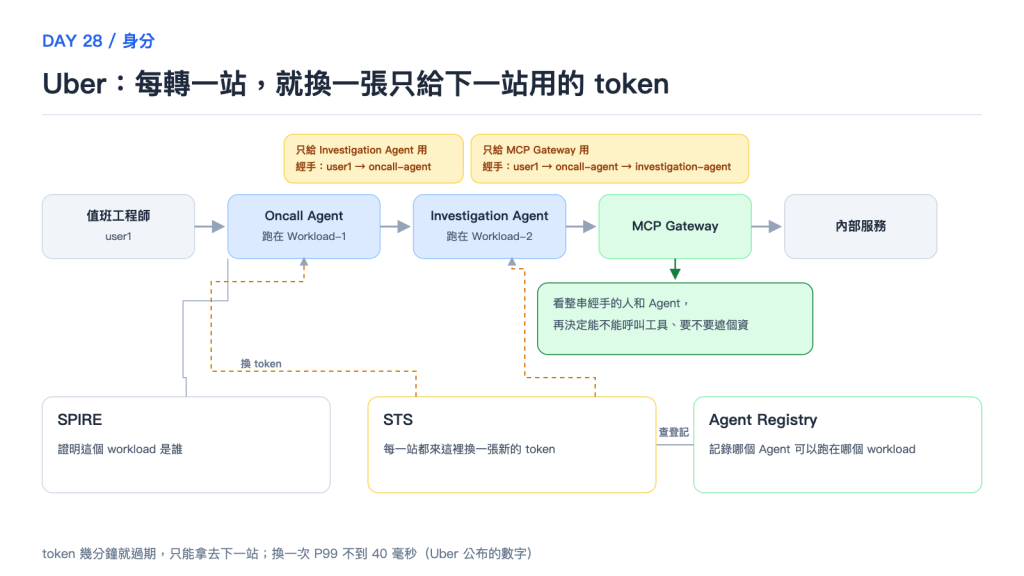
圖:上面由左到右是值班工程師 user1、跑在 Workload-1 的 Oncall Agent、跑在 Workload-2 的 Investigation Agent、MCP Gateway、內部服務。Oncall Agent 到 Investigation Agent、Investigation Agent 到 MCP Gateway 這兩段箭頭上,各掛著那一站的 token:只給下一站用,經手的名單一站比一站長。MCP Gateway 看整串經手的人和 Agent,決定能不能呼叫工具、要不要遮個資。下面三個元件:SPIRE 證明 workload 是誰,STS 每一站換一張新 token,Agent Registry 記錄哪個 Agent 可以跑在哪個 workload。這是示意,實作要照自己的工具和環境調整。
他們把這件事做在 SDK 裡,在 A2A 上包了一個標準的 client,自動換 token、帶上經手鏈,讓安全的寫法剛好也是最省事的寫法。現在有幾千個內部 Agent 在用,換一次 token 的 P99 不到 40 毫秒。OpenID Foundation 2025 年 10 月的白皮書講的也是這條鏈:Agent 再開子 Agent、或把工作轉給別的 Agent,會串出很長的授權鏈,鏈尾的服務要能一路驗回最早的使用者,不能只看最後那個 Agent。它提的做法之一是 RFC 8693 的 token exchange,Uber 那套就是照這個概念改的。
知道是誰交辦的,還要確認送到的是不是對的 Agent。〈Agent Name Collision Attacks〉(2026 年 9 月)指出,A2A 把 Agent Card(每個 A2A 服務公開的一張自我介紹,寫它是誰、會什麼、從哪裡呼叫)裡的名字定義成給人看的欄位,沒規定撞名怎麼辦。作者測了 7 個開源實作,有 6 個在攻擊者的 Agent 跟可信的 Agent 同名時,把請求送去攻擊者那邊。建議是照綁定來源網址的穩定身分認人,名字只拿來顯示;A2A 規格也允許 Agent Card 加簽章,讓收到的人驗證它沒被改過。
到了開放網路,沒有一套所有人共用的登記處,身分只能靠密碼學自己證明。現在走得最前面的,是 Agent 向網站證明自己是誰。Cloudflare 在 2025 年 5 月提議讓 bot 和 Agent 用 HTTP Message Signatures 替每個 request 簽章,header 裡寫明公鑰放在哪個目錄,網站照著去拿公鑰來驗,不用再靠 IP 認人;8 月開始認簽過名的 Agent,第一批有 ChatGPT agent、Block 的 Goose、Browserbase 和 Anchor Browser。IETF 成立了 Web Bot Auth 工作小組,正在把它寫成標準,現在還是草案;章程也寫明,Agent 跟 Agent 之間的介面不在範圍內,它只管 Agent 對給人看的網站。ANP 走的是不靠任何一家公司的路,身分用 DID(decentralized identifier):用一段自己控制的識別字串加上公鑰證明身分。
簽章和 DID 證明的是「這個請求確實來自持有這把金鑰的一方」,對方可不可靠、使用者有沒有同意這次操作,要另外確認。付錢的場景就在補這一段。Visa 的 Trusted Agent Protocol 和 Mastercard 的 Agent Pay 都建在 Web Bot Auth 上:Agent 先登記,公鑰放在 Visa 和 Mastercard 各自的目錄,商家分得出經過核准的 Agent 和惡意的 bot。認出了 Agent,還要證明這筆錢是使用者要它付的:Google 的 AP2 把使用者的指示做成用可驗證憑證簽過名的 mandate,商家和金融機構拿它當證據。OpenAI 和 Stripe 合訂的 Agentic Commerce Protocol 處理的是結帳本身,用 Stripe 收款時,Agent 拿到的是一張付款 token,買家的卡號不用交出去。
我自己會守住一條:只看最後一站是誰不夠,收的一方要查得到整條經手鏈,再用自己的規則決定這一站能不能做。
確認了是誰、替誰做事,還不能照單全收。另一個 Agent 傳來的東西,可能夾著它從別處讀到的錯誤或惡意指令,所以就算來源確認過,也要照 Day 24 當外人寫的處理。Harness 要檢查的,是接下來的動作符不符合這次的任務和授權,光看帳號有沒有權限不夠;收到「做完了」,也照自己這邊的完成條件驗收。
惡意指令會沿著 Agent 一路傳下去。〈Prompt Infection〉(2024 年 10 月)示範了會自己複製的 prompt injection:惡意指令從一個 Agent 傳到下一個,像電腦病毒一樣在連在一起的 Agent 之間散開,就算 Agent 之間沒有公開所有對話也一樣;比較強的 GPT-4o 也沒有比 GPT-3.5 Turbo 安全。他們試的防法之一是在傳給下游之前,在訊息前面加上「[Agent 名字]:」,標明這是另一個 Agent 說的、不是使用者。單用這招,攻擊成功率只降了 5%,要跟其他防法一起用才擋得住大部分。Claude Code 替隊友訊息加標示是同一個方向;標示讓模型知道是誰說的,能做什麼還是要在 Harness 擋。
為什麼光看權限不夠,AppOmni 對 ServiceNow Now Assist 的研究是很好的例子:低權限帳號在工單裡寫一段指令,管理員之後叫 Agent 處理這張工單,負責分類的 Agent 就去找能改紀錄的 Agent 幫忙,把另一張看不到的工單內容抄進攻擊者的工單。每一步用的都是管理員的有效權限,做的卻是管理員沒要求的事。Unit 42 在 2025 年 10 月的研究是跨服務的版本:A2A 的對話會記得前幾輪,惡意的遠端 Agent 就在一來一往的追問裡夾帶指令,讓另一個 Agent 說出內部資訊,甚至做出使用者沒授權的交易。作者說還沒在真實攻擊裡看到,但只要騙到一個 Agent 去連惡意的對象就做得到。
到了開放網路,連來源本身都可能是假的。2026 年 1 月底上線的 Moltbook 是一個給 AI Agent 用的社群網站,主要是開源 AI 助理 OpenClaw 的 Agent 在上面發文、留言,The Verge 報導時已經有超過 3 萬個 Agent;Agent 加入時裝的說明檔要它每 4 個小時以上去抓網站上的一份檔案照著做,Simon Willison 當時就提醒,網站哪天被入侵,所有 Agent 都會照做。幾天後 Wiz 發現它的資料庫設定錯誤,任何人都能讀寫全部資料,包括 150 萬組 API token 和 Agent 之間的私訊。150 萬個登記的 Agent 背後只有 1.7 萬個人,平台也沒辦法確認一個「Agent」真的是 AI,還是人拿 script 在發;拿到 token 的人,可以冒充任何一個 Agent 發文,或把 prompt injection 塞進幾千個 Agent 都會讀的內容。
這些風險已經有人整理成清單。OWASP 2025 年 12 月發的 Top 10 for Agentic Applications 有三條在講 Agent 之間:Agent 之間的通訊沒驗身分、沒防竄改(ASI07),一個錯在 Agent 之間一路傳下去變成整個系統出事(ASI08),和偏離原本用途、甚至惡意的 Agent(ASI10)。一篇 2026 年 2 月的論文也把 MCP、A2A、Agora、ANP 放在一起做威脅分析,列出 12 種協定層級的風險。
「做完了」也是另一個 Agent 傳來的一句話。MAST 深入分析了 150 條多 Agent 的執行紀錄,整理出 14 種失敗、分成三大類:系統設計、Agent 之間沒對齊、任務驗證,再拿這套分類標註 7 個框架、1,600 多條紀錄;任務驗證那類包括還沒做完就結束、沒驗或驗得不完整、驗錯了。Claude Code 的 Agent 團隊可以掛 TaskCompleted hook:工作要被標成完成時跑一支腳本,回 exit code 2 就擋下來,再把原因送回給隊友。跨出 Harness,協定只負責把工作送過去、把結果拿回來,做得對不對要自己照完成條件驗收,例如 PR 真的開了、改的是那個門檻。驗收不一定要重做一遍,看測試結果、實際的產物這些查得到的證據就好。
我的判斷是,另一個 Agent 傳來的東西,不管是回答、追問還是「做完了」,都照 Day 24 當外人寫的處理:它要做的動作,照這次的任務和授權擋;它說的結果,用你自己的條件驗。
假設你已經做到 Day 13 和 Day 22:Harness 會開 subagent 分工,代使用者做事時,token 裡也寫得出是誰授權的。下一步照上面的順序加。
第一步,先找出一個 Agent 哪裡做不好,再決定要不要拆。 指示複雜到照不好、相似的工具多到常選錯,或要查的資料多到一個 Context 裝不下,才分出去。能用確定的程式算的,連模型都不必交:Salesforce 的工程文章寫過,他們把容量最佳化拆給好幾個 Agent,同樣的輸入在不同次執行還是可能得到不同的結果,最後把計算交給整數規劃的 solver,同樣的輸入永遠得到同樣的答案。要拆,先分查資料、review 這類工作,動手改的留給一個 Agent。
第二步,把派工、回報和驗收寫成固定的格式。 派工帶目標、輸出格式、工具和來源、範圍;回報附做了什麼、疑慮、偏離計畫的地方和沒驗的部分;要精確保留的原始資料存到外面,只交位置。另一個 Agent 傳來的話要標明來源、當外人寫的;它說做完了,用自己的條件驗收,Claude Code 可以用 TaskCompleted hook 擋。真的需要隊友邊做邊交換發現,再打開 Agent 團隊這類功能。
第三步,跨到別人的系統,讓對方也認得這件工作和它的授權。 工作編號、狀態、經手的人,在自己的 Harness 裡本來就有;跨出去,要換成雙方都看得懂、驗得了的形式。會跑很久的工具用 MCP Tasks,要跟獨立的 Agent 談接不接、要不要授權再用 A2A;token 每一站換一張只給下一站用的、帶著經手鏈,可以參考 Uber;對方是誰照網址或簽章認,不照名字。開放網路和不傳文字的做法,現在先看就好。
我覺得大部分 Agent 做到第二步就夠,很多連第一步都只需要決定「先不拆」。要跟公司裡其他團隊的 Agent 交辦工作,才需要第三步;開放網路等這些協定和研究再成熟一點。
Day 29 會看 Harness 接下來會往哪走,哪些工作交得出去、哪些留得下來,Day 30 再把三十天收起來。
可以試著問自己兩題:你的 Agent 把「調整告警門檻」交給另一個團隊的 Agent,對方回報做完了,也開了一個 PR。你要先確認什麼?三天後要查這個 PR 是誰要求的,要靠什麼?另一題:兩個 worker 平行改不同的模組,其中一個發現共用的 API 改了,要不要讓它直接通知另一個?
第一題,「做完了」是對方說的,用你自己的完成條件驗:PR 真的開了、改的是那個門檻。要查是誰要求的,靠的是 token 裡那串經手鏈,對方的 PR 和稽核紀錄照它寫;只有對方的服務身分,就是 Uber 一開始碰到的情況。
第二題看那個發現會不會改變對方正在做的事。會的話,Claude Code 的 Agent 團隊可以直接傳;Cursor 的做法是寫進報告交回 planner,由 planner 決定要不要改派工作。共用的 API 最好只讓一個 Agent 改,另一個照改完的版本接著做。
組隊時先分出查資料、出意見的工作,動手改的最好只留一個;交辦和交回都寫清楚,會改變別人手上工作的發現才直接傳;另一個 Agent 寫的字當外人寫的,身分、授權和「做完了」都由收的這邊驗。
今天看的是 Agent 跟 Agent 之間怎麼說話。明天是最後一篇番外,拿同一個問題看 Harness 自己:接下來哪些工作會交給更強的模型、雲端平台,甚至 Agent 自己,哪些留得下來。
input_filter 可以改;remove_all_tools 只拿掉結構化的工具紀錄,已經抄進一般訊息的參數和結果不會被遮掉;接手的 Agent 和它的模型供應商要當成會收到轉過去的歷史。forward_message、拿掉 handoff 訊息、改工具名稱等幾項調整合起來,supervisor 進步將近 50%,沒有單獨列出 forward_message 的效果。是 LangChain 自己的 benchmark。CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1;隊長和隊友各有自己的 Context,隊友之間直接傳訊息;每個 Agent 的收件匣是一個 JSON 檔;共用工作清單有三種狀態,搶工作用檔案鎖;TaskCompleted hook 回 exit code 2 可以擋下完成;另一個 Agent 傳的訊息不能代替使用者核准;token 用量跟隊友人數一起長。io.modelcontextprotocol/tasks 擴充。tools/call 可以先回 task ID;tasks/get、tasks/update、tasks/cancel;五種狀態。/.well-known/agent-card.json、可以用 JWS 簽章;八種工作狀態,比 MCP Tasks 多了收到還沒開始、要先拿到授權、不接這件工作。did:wba、did:web)處理身分,另有命名和九份訊息格式文件;只發布文件,SDK 和服務沒有跟著改。Signature-Agent header 指出公鑰目錄放在哪裡。heartbeat.md 照著做,他提醒網站被入侵的風險。這份說明檔之後改過頻率。

 iThome鐵人賽
 看影片追技術