

病人安全小組——院內都叫它病安小組——每個月開一次會,看的就是上個月院內哪裡差點出事、哪裡已經出事了。開會前一天,病安承辦同仁依權限從通報系統彙整資料,準備討論用的電子報表。我參與準備時,注意到各欄位能回答的問題很不一樣。
前面幾欄很整齊:通報日期、發生地點、事件類別、通報者職類、有沒有到達病人。這些欄位可以直接畫成圖、貼進簡報,看起來很像一份報告。這一段的 schema 是完整的,每一欄都可判定、可統計、可比較。
然後是最後一欄,欄名叫「事件經過」。
裡面是一段自由文字。有的三行,有的三十行。有的寫得極為完整,時間、人、動作、結果都在;有的只寫了一句「已依規定處理」。有人在裡面寫下自己的推測,有人在裡面替同事解釋,也有人寫了跟事件關係不大、但顯然憋很久的話。
這一欄補充了結構化欄位放不下的情境,也是承辦同仁最需要逐案判讀、向通報單位確認的地方。
會議上被討論的,永遠是前面那幾個下拉選單統計出來的東西:這個月跌倒幾件、用藥事件幾件、哪個單位比較多。這些數字每個月都在報,而且每個月都長得差不多。
長條圖上最高的那一根,這個月是 7B 病房;7B 的陳護理長就坐在會議桌對面。而那張圖能告訴她的只有「你們比較高」——高在哪裡、跟哪一類事情有關,全部在最後那一欄裡。
許多問題的細節藏在那一欄裡。小組即使逐案讀過,要把整個月的敘述串起來找共通點,仍然需要另一輪整理工時。
先用一句話交代這個東西:異常事件通報是醫院內部的回報機制——任何一件不該發生卻發生的事,不管有沒有造成傷害,都透過通報系統填寫紀錄;目的不是追究責任,是讓問題在造成傷害之前浮出水面。 它就是你的 incident report,而 Day 2 那張各單位的年度統計,就是從這批單子來的。
那裡沒講的是另外半句:規定上該填的都要填,實際上沒有人查得出來誰沒填。所以這個制度實質上是自願的——而它接下來的每一個設計,都是為了遷就這件事。
而這個制度有一條所有醫院都一樣的設計原則:降低通報門檻。
它最大的敵人不是通報得不準,是根本沒有人通報——一件沒有被寫下來的事,在系統裡等於沒有發生過。所以通報單被刻意做得很短,欄位少、必填更少,剩下的全部丟給一欄自由文字。
這不是偷懶,是一個很清楚的取捨:用資料的結構性,換通報的意願。 規則寫得下來的部分早就是下拉選單了;寫不下來的,全在那一欄。這筆技術債是故意欠的,當初也欠得有道理。
這個制度為了讓人願意寫,刻意把欄位做少;代價是真正的資訊全部堆在那一欄自由文字裡,而那一欄沒有人有空讀完。
還有第二層問題,而且更麻煩:前面那些看起來很乾淨的結構化欄位,品質不如外表。
「事件類別」是通報者自己在下拉選單裡選的。而通報者不是分類專家,也沒有義務是——他是剛處理完一件麻煩事、下班前把單子填掉的第一線同仁,選「其他」永遠最省事。有些單子類別選了跌倒,文字寫的其實是約束帶(固定躁動病人、避免他自己下床或拔管的那條帶子)鬆脫;有些選了用藥事件,讀下去核心問題在交班。
分類欄位記錄的不是事件的性質,是通報者當下對這件事的理解。 這兩件事不一樣,而年報是用前者做的。
真正要做的事情一句話講得完:把那一欄自由文字,變成一列結構化紀錄。 這句話聽起來太簡單,所以要拆開講。
第一件事不是寫 prompt,是決定這批紀錄的 schema——我要哪些欄位。
而這一步不能問 AI。問了它會給你一組聽起來很完整、但沒有一個欄位是為了回答你的問題而存在的欄位表。
我要的欄位,是那些後續真的有人會拿去做決定的欄位。舉幾個:
其中「是被誰攔下來的」那一欄我最想要,因為它回答的是「我們的系統看不看得見自己出錯」——那是第三週的題目(Day 16),先埋著。
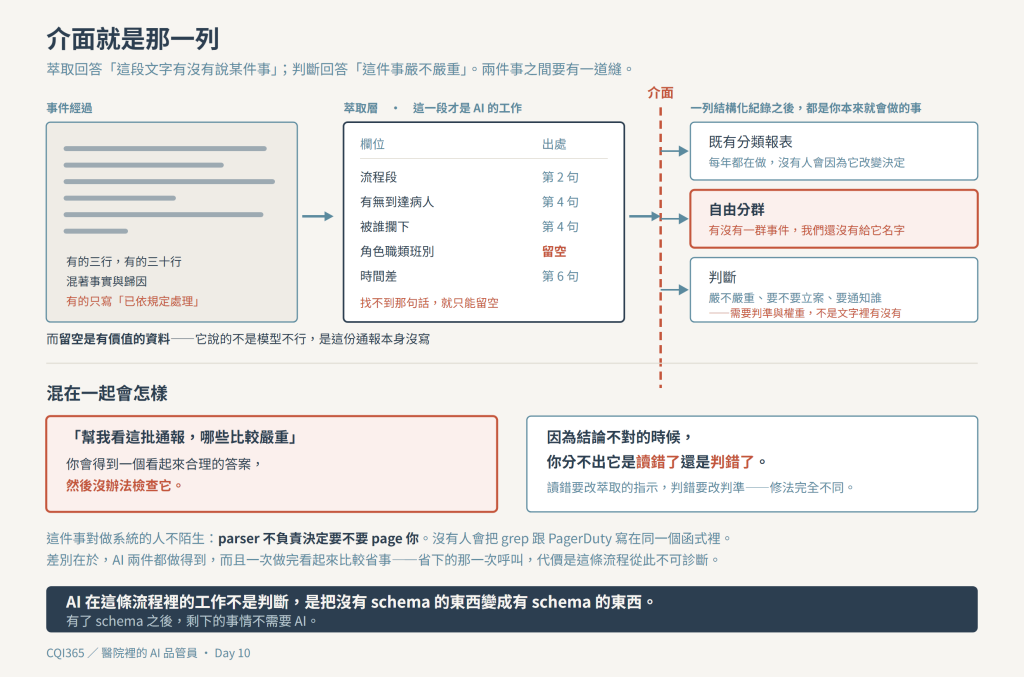
第二個決定,是整段設計裡最重要的一個:萃取跟判斷分開,中間留一個明確的介面。
把兩件事混在一起問——「幫我看這批通報,哪些比較嚴重」——你會得到一個看起來合理的答案,然後沒辦法檢查它。
因為當結論不對的時候,你分不出它是讀錯了還是判錯了。而這兩種錯誤的修法完全不同:讀錯要改萃取的指示,判錯要改判準。混在一起,你連從哪裡下手都不知道。
這件事對做系統的人不陌生:parser 不負責決定要不要 page 你。日誌解析成結構化欄位是一層,告警規則是另一層,中間有明確的介面,沒有人會把 grep 跟 PagerDuty 寫在同一個函式裡。
差別在於,AI 讓這兩件事變得非常容易混在一起,因為它兩件都做得到,而且一次做完看起來比較省事。 省下來的那一次呼叫,代價是這條流程從此不可診斷。
第三個決定:每一個萃取出來的欄位,都要求它附上原文中支持這個結論的那一句話。
這一條本來是防守用的,結果意外變成整段流程裡最省時間的設計。複核的人不必重讀整段文字,只要看那一句話對不對——把「讀完再判斷」變成「看一句話驗證一個欄位」。
它同時解決了一個更根本的問題:欄位填不出來的時候會怎樣。
沒有要求出處的時候,模型傾向猜一個合理的值填進去。要求出處之後,它至少得在原文裡找一句話當根據,找不到就只能留空。而留空是有價值的資料——它告訴你的不是模型不行,是這份通報本身沒寫。哪些欄位經常留空,反過來就是通報單該修的地方——這張留空統計明天就做得出來,而且要修的不是模型,是上游那張表單。
萃取層的輸出是一份結構化紀錄:一列一事件,欄位固定,型別固定,每個欄位旁邊掛著出處。
從這一列開始,後面所有的事情都是你本來就會做的:查詢、統計、交叉比對、分群、排序。整合點就在那一列上——品管流程跟資訊流程接起來的位置,不在模型裡面,在那張表的 schema 上。
AI 在這條流程裡的工作不是判斷,是把沒有 schema 的東西變成有 schema 的東西。有了 schema 之後,剩下的事情不需要 AI。
有了結構化紀錄之後,第一件想做的事是分群。
而這裡有一個看起來很自然、但我決定不做的選項:直接把既有的事件分類架構餵給它,讓它照著分。
不做的理由是,既有的分類表是給通報者用的,不是給分析用的:它的設計目標是讓填單的人三秒內選到一個不會錯太多的選項,所以必然粗、互斥,而且通常是十幾年前訂的。
用它來分群,你只會得到既有分類的統計——那份統計每年都在做,是一塊沒有人會因為它改變任何決定的儀表板。那不缺。
缺的是「有沒有一群事件,我們到現在還沒有給它名字」。
所以第一輪刻意不給類別。讓它在沒有預設答案的情況下,把描述上共用同一個機制的事件聚在一起,再把聚出來的群攤給病安小組看:這一群是什麼?要不要給它一個名字?我們原本把它們放在哪幾個類別底下?
這一步真正有價值的產出通常不是「它分對了」,而是它把原本散在三個不同類別底下的事件放到同一群,而那一群看下去確實共用同一個機制。這種東西照既有分類統計永遠看不到,因為它們在報表上從第一天就被拆開了。
但完全不用既有分類也不行。年報要報、對外要比較、主管機關的通報格式是固定的——那一層是對外的 API,改了就跟去年的數字接不起來。
所以兩層都跑:一層對既有分類給例行報表用,一層自由分群給找問題用。輸入是同一份結構化紀錄——這正是前面那一列的價值:同一份萃取結果,可以餵給兩個目的完全相反的下游。
跑一次分群沒有意義。會議上看一看,覺得有點意思,然後就過去了。
要讓它變成制度,得先處理一個很煩的問題:如果每個月重新分群,群的定義每個月都不一樣,你就沒辦法比較這個月跟上個月。 每次執行都重新定義座標軸的系統,產不出趨勢。
所以現在的做法是輪流:
探索式分群跟固定分類要輪流跑。只跑探索式的,你什麼都比較不了;只跑固定分類的,你永遠只看得到自己已經知道的東西。
最後這一段是領域判斷,不是技術問題,但它決定整套東西可不可信。
通報單的文字裡,事實跟歸因是混在一起的。
以下這段是我自己寫的,不是真實通報:
交班後接手的同仁發現輸液幫浦的速率設定與醫囑不符,立即調整並通知醫師,病人無不適。當時同時段有三位新入院病人,人力吃緊。
前面兩句是事實。最後一句是通報者的解釋。
通報者的解釋常常是善意的、聽起來也合理,但它常常是錯的——他解釋的是自己看得見的那一段,看不見的那一段本來就不在他的視野裡。根因分析存在的整個理由,就是不要停在第一個解釋(第三週的題目,Day 14)。
萃取層如果不把這兩層分開,它會非常順地把「人力不足」填進「原因」欄位,因為文字裡就是這樣寫的。然後你會得到一份看起來很結構化、其實只是把一群人的猜測排整齊的表。schema 是對的,值是猜的。
而它比原本那一欄自由文字更危險。自由文字看起來就很粗糙,沒有人會直接信;一張有欄位、有型別、可以畫成長條圖的表,會被信。格式的整齊度跟內容的可靠度沒有任何關係,但人腦會把兩者混在一起。
所以萃取的欄位表裡沒有「原因」這一欄。有的是「通報者提到的可能原因」。欄名很長,但它誠實。
明天談下一個瓶頸:當會議畫面列出二十幾條都是真的問題,要怎麼挑出值得做的那一個。


 iThome鐵人賽
 看影片追技術